STeP:以信号时序逻辑为视觉语言模型动作生成提供精确规范
机器人遵循自然语言指令,不仅要完成目标,还要在执行过程中满足空间、时间与逻辑要求。作者提出STeP,将这些要求显式表达为信号时序逻辑(STL)规范,而非仅隐含在学习策略中。
展开阅读 具身图谱在图谱中把握具身智能
机器人表现的改进,不能只由预测误差、正常起点成功率或低位宽精度判断。本月围绕三个问题展开:未来表征如何服务反馈控制,偏离正常轨迹后怎样恢复,以及量化收益能否兑现为部署效率。关键是把改善放回各自的观测、任务与硬件条件中解释。
机器人遵循自然语言指令,不仅要完成目标,还要在执行过程中满足空间、时间与逻辑要求。作者提出STeP,将这些要求显式表达为信号时序逻辑(STL)规范,而非仅隐含在学习策略中。
展开阅读固定相机图像信号处理器(ISP)生成的RGB图像,是否会影响机器人策略表现?作者在场景、任务和机器人状态不变时,逐项改变曝光、传感器噪声、色彩响应、色调响应和位深,发现不同成像因素对动作预测与操作成功率的影响明显不同。
展开阅读作者提出面向有界不确定性高维黑箱系统的sRAS Q-CBF安全过滤器,要求安全到达目标,并在首次进入后持续安全留在其中。方法结合保持价值与到达—避障价值:先确定目标内可永久安全驻留的子集,再求解避开失败状态和目标内部不可持续安全状态、到达该子集的问题。通过对抗强化学习与Q函数提升,合成和部署无需已知动力学、价值导数或手工障碍函数。
展开阅读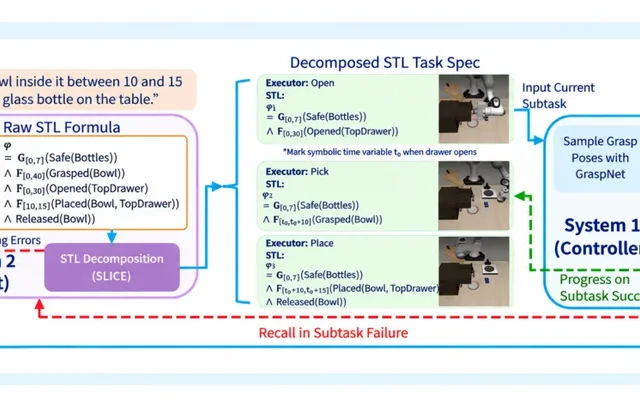 2026-09-28 · arXiv · 作者论文STeP:以信号时序逻辑为视觉语言模型动作生成提供精确规范
机器人遵循自然语言指令,不仅要完成目标,还要在执行过程中满足空间、时间与逻辑要求。作者提出STeP,将这些要求显式表达为信号时序逻辑(STL)规范,而非仅隐含在学习策略中。
框架由高层推理与低层控制协同工作:高层将指令转为整项任务的规范,再分解为子任务,并让持续性约束随各阶段保留;低层结合运动规划与模型预测控制,将STL鲁棒度纳入优化。在线监测在安全条件失守或目标超时后触发重规划,并携带执行历史,保留原任务上下文。
作者报告,在新建的LIBERO-Constrained基准49个任务—约束实例上,STeP的安全成功率为80%,SmolVLA和移除STL的VLM-MPC-Cost分别为14%和20%;该指标要求完成任务且满足全部约束。在LIBERO-PRO六种组合中的五种,成功率为54%—89%,但Goal套件的任务扰动下仅为16%。
这些结果需结合实验条件理解:仿真使用特权状态获取物体信息;LIBERO-PRO基线取自既有论文,STeP数据来自作者自己的运行,并非全部方法的统一重跑。
 2026-09-29 · arXiv · 作者论文RawVLA:面向机器人操作的具身神经图像信号处理器
固定相机图像信号处理器(ISP)生成的RGB图像,是否会影响机器人策略表现?作者在场景、任务和机器人状态不变时,逐项改变曝光、传感器噪声、色彩响应、色调响应和位深,发现不同成像因素对动作预测与操作成功率的影响明显不同。
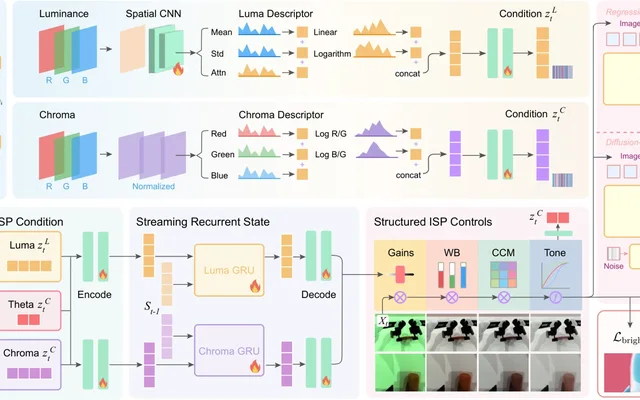
为此,作者提出RawVLA:在冻结VLA策略的条件下,将因果线性RAW序列分解为亮度与色度描述,经独立循环状态生成曝光、白平衡、颜色校正和单调色调控制,再将渲染图像交给策略预测动作。训练通过动作目标更新ISP,无需逐像素监督。
作者还构建RawVLA-Bench,在RAW形成前改变仿真光照,覆盖LIBERO与RoboTwin 2.0的五种光照条件。论文报告,LIBERO跨骨干平均成功率由最强基线的43.01%升至68.82%;RoboTwin 2.0达到54.98%,相对最强神经ISP基线提高85.81%。收益主要来自不利光照,正常光照表现大体保持。这些数字属于作者基准实验;其中LIBERO输入是由RGB反处理生成的伪RAW,而非物理传感器原始采样。
该工作将成像处理作为机器人策略评测和适配的显式变量,提供了不更新VLA策略、转而优化视觉前端的技术路径。
结果应限于作者所述基准与光照协议,不视为独立复现或通用操作能力证明。两套仿真基准的RAW构造方式不同:LIBERO采用RGB反处理,RoboTwin 2.0采用色调映射前HDR缓冲并加入传感器噪声。
 2026-09-17 · arXiv · 作者论文赢下已赢之局:面向高维黑箱系统的严格到达—避障—保持控制障碍函数
作者提出面向有界不确定性高维黑箱系统的sRAS Q-CBF安全过滤器,要求安全到达目标,并在首次进入后持续安全留在其中。方法结合保持价值与到达—避障价值:先确定目标内可永久安全驻留的子集,再求解避开失败状态和目标内部不可持续安全状态、到达该子集的问题。通过对抗强化学习与Q函数提升,合成和部署无需已知动力学、价值导数或手工障碍函数。
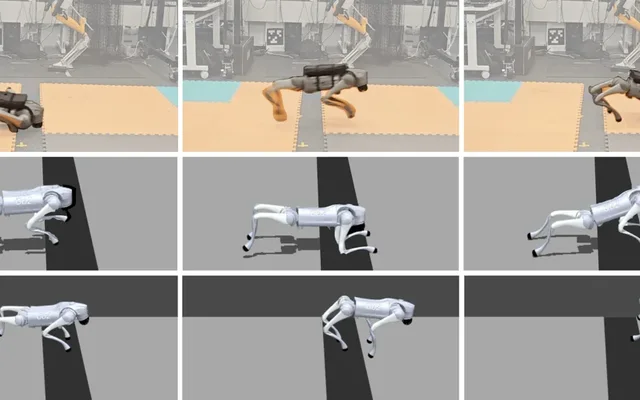
作者报告,每种过滤器各1000回合的Go2跳沟仿真中,sRAS成功率为86.9%,成功指跨越、安全落地并保持安全至回合结束;论文另展示真机成功执行。每种过滤器各1000场F1TENTH仿真比赛中,sRAS安全率为98.0%,每场成功超车9.63±0.99次,两圈耗时97.37±2.87秒,后两项为均值±标准差。
这些是作者自报结果。几乎处处保持任务可行性的理论保证依赖精确价值与零测集假设,学习近似不自动继承保证,也不能将可行性保持理解为必然有限时间到达。赛车实验无扰动,成功超车要求领先保持5秒,不构成无限期保持的实证验证。
该工作把安全过滤的目标从单纯避险扩展为保留完成任务及保持成果的可能性。理论区分可行性保持与实际到达:进入终端安全集后的保持具有条件保证,但不能据此宣称任意任务策略都必然有限时间到达。
证据身份为作者论文及其自报实验,不作为独立复现或厂商产品能力声明。真机材料仅据成功执行展示描述行为,不报告真机统计成功率;仿真中的持续安全有回合结束或领先保持时长等评测边界。学习得到的价值与策略不自动继承精确值理论保证。
 2026-09-26 · arXiv · 作者论文机器人学习中的潜在动作,什么最重要?
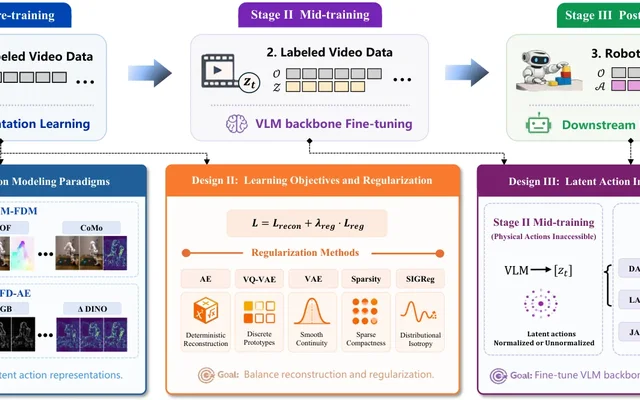
潜在动作模型可从无动作标注视频中学习物理动作的紧凑替代表征,但既有方法的实验设置不一致,难以判断哪些设计真正影响操作表现。作者将代表性方法纳入统一自编码框架,在LIBERO、LIBERO-Plus和RoboTwin2.0上考察41项设计选择,覆盖建模范式、学习目标与正则化、动作接入策略。
研究采用三阶段训练:先从连续帧学习潜在动作,再用其微调视觉语言模型骨干,最后利用机器人动作数据训练策略。作者发现,直接使用原始数据训练的LAPO仍是强基线;未来帧重建指标比动作解码探针更稳定地反映下游表现,但仅适合粗筛,不能替代任务评测。
真机实验在Franka Panda的四项桌面任务上比较原始与潜在动作微调后的OpenVLA-OFT。汇总五个训练检查点,成功次数由259/400增至317/400,成功率从64.75%升至79.25%,提高14.5个百分点;这不是单一最终检查点的成绩。
两组真机模型使用相同的200条示范和下游训练配置,仅骨干参数不同,视觉输入均为单个前视RGB相机。上述结果属于作者论文中的实验报告。
为利用视频初始化机器人策略提供了设计与筛选依据:潜在动作微调值得验证,但模型选择仍应回到下游任务表现。
代理指标不宜用于精细排名,跨潜在维度比较时相关性还会下降;向灵巧手、四足和人形平台推广仍列为未来工作。
 2026-09-02 · arXiv · 作者论文用于高效变形飞行的尾流矢量控制
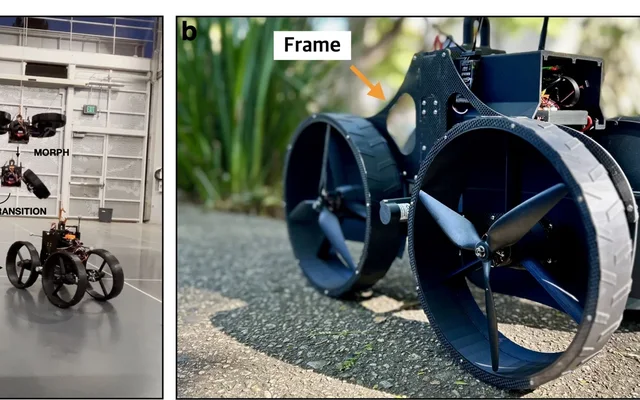
变形飞行机器人在空中改变构型时,推进器偏离竖直方向会减少垂直推力,限制悬停与抗扰能力。作者提出被动尾流矢量控制:在空地变形机器人ATMO机身内嵌导流面,将旋翼尾流重新导向下方,回收原本难以用于升力的气流动量;该机制本身无需运动部件或电子设备。
研究结合台架测力、数值流场仿真和整机实验。台架上,导流出口角为10°、推进器轴线倾至水平时,垂直推力超过竖直构型基准推力T₀的40%。整机受结构约束,第二版导流器采用15°出口角,在80°倾角时获得略低于40%的峰值推力回收;不能将台架结果直接当作整机表现。
作者依据推力曲线与重量计算,加入导流器后的临界悬停角为83°,较无导流器构型增加20°;实际飞行则验证了72°倾角稳定悬停。超过72°时,机器人虽能开始起飞,却缺乏抵抗扰动、稳定垂直位置的控制余量。因此,83°是推力条件推算的边界,而非已验证的稳定悬停纪录。
这项作者研究展示了通过被动气动结构补偿变形推力损失的路线,可减少对额外执行器和复杂控制策略的依赖。
推力回收依赖导流器几何与具体构型,现有设计不能直接推广到其他变形机器人;推力条件允许悬停不等于具备足够抗扰控制余量。
 2026-09-03 · arXiv · 作者论文更好的想象推演意味着更好的机器人控制吗?反馈条件下世界模型评估的受控研究
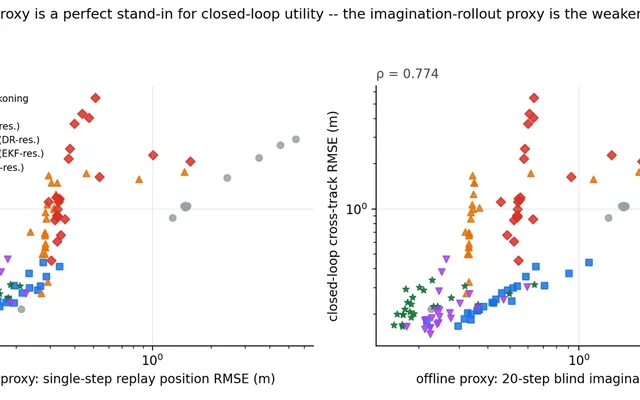
离线预测更准,是否意味着闭环控制更好?作者在带有偏置里程计和间歇地标观测的差速机器人路径跟踪仿真中,以状态估计器作为紧凑预测模型,在24种感知条件下比较六种估计器的轨迹回放、20步无地标观测推演与闭环跟踪表现。
结果显示,回放位置RMSE与闭环横向跟踪RMSE的Spearman相关系数为0.923,无地标观测推演为0.774;两者分别在5/24和18/24种条件下选出不同于闭环最优的估计器。固定推演长度为20步,逐步纳入可用观测时,相关系数为0.916;完全撤去观测后降至0.774。时域与更新间隔的联合实验表明,关键不只是预测多远,还包括是否保留观测校正:长推演在频繁校正下仍能保持较高排序一致性。
训练阶段延长感知中断,在组合感知退化条件下将GRU-EKF的横向跟踪RMSE从1.72米降至1.06米,但收益并未跨独立中断条件和估计器架构一致出现。作者据此建议,评测须同时说明预测时域与观测更新安排;这些结果不意味着短时域预测普遍优于长时域预测。
为反馈系统中的预测模型评测提供方法学提醒:离线协议应尽量匹配部署时的感知、状态校正与控制更新结构,不能只看无观测推演误差。
证据来自作者论文,不是独立复现。主实验限于单一差速平台仿真、单一路径族与纯追踪控制器,不含视觉预测模型,不能据此外推大型视觉世界模型的通用评测标准。
 2026-09-29 · arXiv · 作者论文SAKI:面向长时程移动操作的人类视频技能组装与运动学模仿
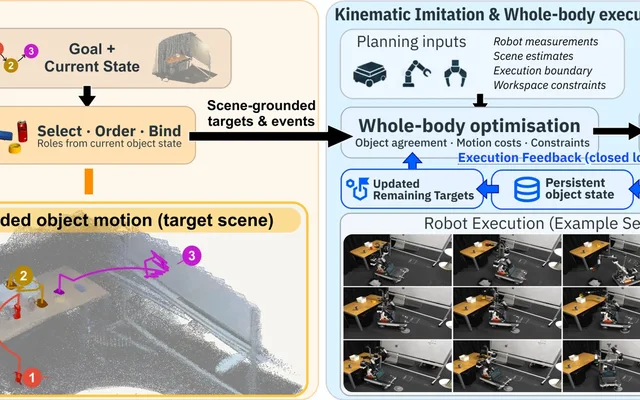
人类视频中的交互若要用于长时程移动操作,机器人需要在场景、视角和自身构型变化时复用技能,而非照搬演示路径。作者提出SAKI,将视频技能获取、跨演示组装和闭环全身执行连接起来。
其核心是将交互要求与可调整运动分离:保留接触、抬升净空、朝向及终态关系,允许转运路径随布局改变。系统依据给定目标和任务依赖选择、排序技能,将物体角色绑定到当前场景,再以全身优化生成底盘与机械臂运动。执行时保留跨视角物体估计,视觉更新只修改未执行轨迹,并在技能切换时传递前一技能的终末机器人构型。
作者真机实验中,连续序列完成率为31/45(68.9%)。保留场景绑定、全身优化、视觉更新和重规划,仅以重建轨迹直接插值替代任务条件参考准备时,完成率为7/45(15.6%);论文报告准备环节带来53.3个百分点提升。实验依赖校准双目演示、任务上下文及兼容抓取或接触信息;序列成功要求所有阶段完成,且无中途重置或人工协助。
作者的消融结果支持:在相同下游求解与反馈条件下,准备可适配的交互参考仍有助于连续任务完成,不能仅靠全身优化和反馈替代这一环节。
结果按作者论文实验解读,不作为独立复现结论。技能组装使用给定目标与依赖,准备还需兼容几何和接触模型;证据不宜外推为无先验的通用任务规划能力。
 2026-09-01 · arXiv · 作者论文以潜在动作为意图,使世界动作模型能够高效想象未来
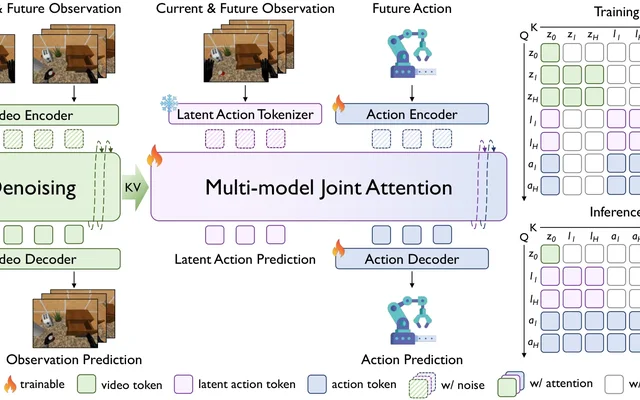
世界动作模型在推理时生成未来观测,会增加控制延迟;直接取消这一过程又可能损失泛化表现。作者提出LAWA,将未来想象转移到紧凑的潜在动作空间,而非重建未来画面。
其分词器通过无动作标签的机器人与第一视角视频预训练,并用掩码监督强化对交互区域的关注。策略训练后,推理阶段移除未来视频分支,联合去噪潜在意图与可执行动作块;潜在意图实际是在离散码本目标约束下演化的连续状态,而非逐步输出离散代码。
作者报告,在RoboCasa使用10%训练轨迹和全量数据时,LAWA平均成功率分别为65.6%和80.8%,比作者匹配实现的Fast-WAM高9.6和4.5个百分点。在单张NVIDIA A800上,每个动作块推理耗时338.5毫秒,相比Joint-WAM降低42.9%且成功率相当,但仍慢于Fast-WAM的196.5毫秒。
这些结果来自作者实验。比较共享下游数据划分及优化设置,但不等参数量或分支结构;作者还指出,没有第一视角预训练时,LAWA尚不及Joint-WAM。
这项工作为保留未来表征而不生成未来画面提供了一种性能与延迟折中路线,并不意味着潜在动作预测在所有条件下都优于显式观测预测。
证据为作者论文实验,不应视为独立复现;优势依赖所述预训练与比较设置。材料仅承诺将发布代码和模型,不能据此认定已经工程开放。
 2026-09-30 · arXiv · 作者论文CEER2:面向人形机器人移动操作的方向性、可调末端执行器与根部柔顺性
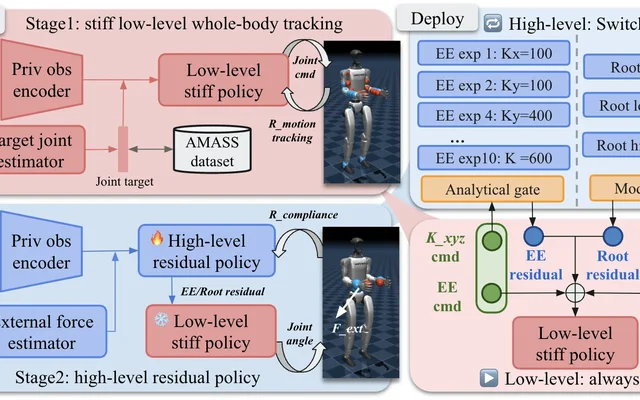
人形机器人接触人或环境时,既要顺应外力,又要保持任务所需的运动精度;末端各方向与机体也可能需要不同响应。作者提出CEER2,将方向性、可调末端柔顺与根部抗扰、随力运动结合。
方法采用两级分层强化学习:先训练较硬的全身跟踪策略,再将其冻结,训练高层指令残差策略。部署时,解析柔顺空间混合专家组合10个末端专家,使各笛卡尔轴刚度可在100—600 N/m内独立调节;根部则切换抗扰、低阻尼或高阻尼模式。交互力由本体感知历史估计。
作者在仿真的16种刚度配置、每种方法960次试验中,报告末端柔顺跟踪误差为0.0349 m、刚度平均绝对百分比误差为0.249,均低于同协议所列基线。真机使用宇树G1,不使用腕部力/力矩传感器;作者展示在线调刚度,并报告方向性末端柔顺配合根部阻尼完成3 kg箱体协作搬运,而各向同性低刚度设置下箱体滑落。真机刚度测量仅为近似估计,不能视作仿真精度的等量验证。
将末端各轴刚度与根部响应分开设定、同时执行,为操作接触与随人移动提供可组合的控制接口。
证据来自作者论文实验,不代表独立复现。真机手动力与位移测量只提供近似刚度;能力受底层跟踪策略约束,交互中仍存在重踏步、缺少针对性交互落脚调整的问题。
 2026-09-07 · arXiv · 作者论文ICI-VLA:面向视觉—语言—动作模型、利用时空对齐示范的上下文模仿
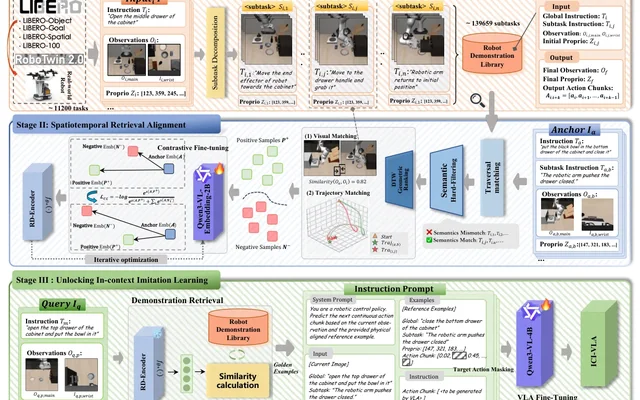
VLA适应新操作场景通常需要额外更新参数,数据或算力不足时会限制部署。作者提出ICI-VLA,以检索示范作为测试时上下文:参数只在离线训练时更新,推理时策略与检索器均冻结,保留原生文本生成接口,以数值文本输出动作,而非增加专用动作头。
方法将长轨迹拆成带语义标签的微示范,通过语义筛选和动态时间规整(DTW)挖掘监督信号,训练RD-Encoder,使检索兼顾子任务语义、阶段与运动几何。DTW仅用于离线训练,推理不读取查询的目标动作。目标动作掩码在训练时破坏部分动作前缀,降低对精确数值续写的依赖;其是否促使模型更多利用当前观测,仍是作者假设。
作者报告,LIBERO与RoboTwin 2.0平均成功率分别为97.7%和60.4%;四项双臂Aloha真机任务平均为83.2%。默认推理检索三条示范,属于少样本上下文适配而非零样本。仿真每任务评估10次,真机每任务250次;这些结果应在相应测试条件下理解。
作者实验支持将时空对齐示范作为固定策略的测试时适配输入;消融中,移除掩码、DTW或语义筛选均降低成功率。
方法仍依赖示范与规划器覆盖,并有离线训练及检索成本。外部基线沿用各自协议,不能将跨论文差值视为受控配对证据;消融也不能证明模型形成了显式残差计算。
 2026-09-29 · arXiv · 作者论文用于激光雷达SLAM的退化正交几何约束
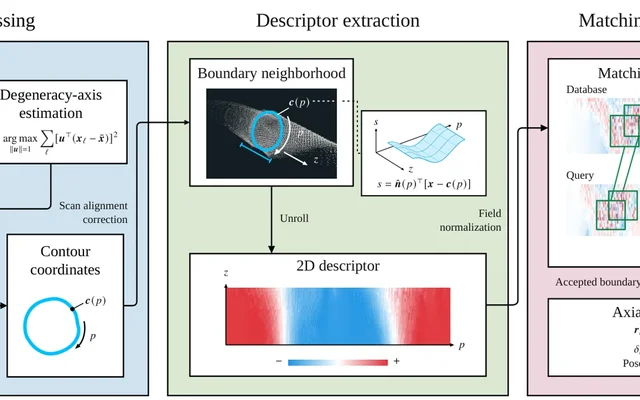
长隧道、管道等轴向均匀环境缺少纵向几何变化,激光雷达里程计容易沿行进方向累积漂移,局部扫描匹配无法独自解决。作者提出DeCOD,利用管接头、结构环等横截面地标,为退化方向补充位置约束。
方法将地标附近表面相对参考轮廓的有符号法向偏移展开为二维描述符,保留相似截面间的细微差异;匹配时处理反向行驶、部分遮挡和轮廓估计误差,再经几何验证筛选关联。通过验证的地标以5自由度几何因子接入位姿图,约束截面位置和走廊轴线,但不约束绕轴旋转。
作者在公共GEODE基准和自采地下管道数据上评估。Shield检索中,轴向容差为2.4米、验证内点至少15个时,Precision@1为95.6%,Recall@1为31.3%;前者只统计接受的查询,后者统计全部共同查询,不能将高精确率理解为全面召回。
轨迹评测另用至少9个内点的门槛:以BIEVR-LIO为基础,S8-Beta位置RMSE从61.597米降至0.768米。实验采用去程建库、返程查询;结果依赖重访时的可靠地标关联,不代表任意环境下都能消除漂移。
该工作展示了用横截面地标补充轴向几何信息、再与里程计联合优化的路线,而非仅抑制退化方向上的不可靠更新。
证据为作者论文实验,不是独立复现。可靠地标不足时仍会残留较大误差;当前方法面向单一主导弱轴,多自由度退化的扩展仍属后续工作。
世界—动作模型通过迭代去噪联合生成未来状态与动作,共享权重处理视频、本体感知和动作等信息流。作者指出,相近的局部量化误差可能造成不同的最终动作偏差,因此仅降低数值误差不足以保障控制表现。
论文提出4位量化框架SteerQuant,以动作影响图谱指导共享通道缩放,再按信息流和去噪步骤校准激活量化;每层保留一份静态量化权重,不为特定流提高位宽。配套推理引擎Rudder将缩放与输出补偿融合进低位宽内核,减少额外内核启动和中间访存。
作者报告,在两个LIBERO模型的W4A8、W4A4设置下,平均成功率较全精度最多下降0.8个百分点。RTX 4090上的三个模型测试中,去噪相对BF16最高加速2.23倍。真机实验采用双臂平台、三项任务,每项12次试验;W4A8端到端推理加速1.35倍,平均任务得分提高,但电池插入得分下降。该延迟不包含机器人运动执行时间,平均任务得分也不等同于全部任务的二元成功率。
作者结果支持以最终动作影响指导量化误差分配,并用融合内核减少缩放开销,为世界—动作模型的低位宽推理提供一种方法。
结论限于作者论文评测:效率测试使用RTX 4090,覆盖三个模型;真机仅涉及一个双臂平台的三项任务。不能据此外推其他硬件、机器人平台或通用操作能力。
 2026-09-25 · arXiv · 作者论文Causeway:恢复VLA策略在指令切换中的任务可达性
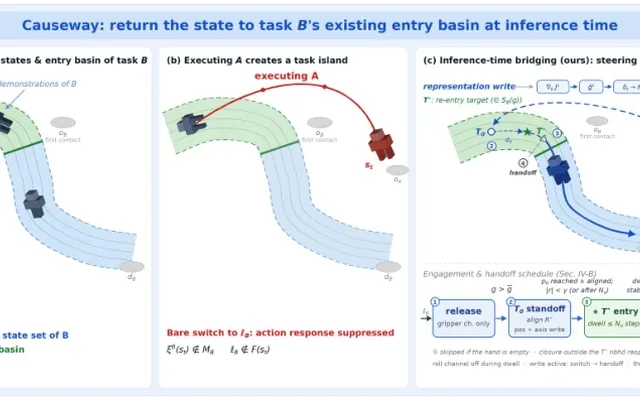
机器人能从标准初始状态完成任务,却可能在执行另一任务后无法响应新指令。作者将这类相对于目标任务不可达的状态称为“任务孤岛”,研究执行中及完成后的指令切换失败。
Causeway采用无需训练的推理时表征干预:根据机器人本体状态和目标任务示范提取的重入位姿,通过冻结解码器反向传播,将状态导向梯度写入动作流表征,引导机器人返回可执行区域。恢复动作仍由原VLA生成,不更新参数、不添加动作头,也不使用外部动作生成;本体感知规则控制干预与交接。
作者在LIBERO-Goal的71组跨物体任务对、三个切换时机及三种VLA架构上报告:π₀.₅、OpenVLA-OFT、GR00T N1.5的平均成功率分别由26.0%、3.4%、9.9%升至61.6%、64.5%、47.5%;到达交接邻域的比例提高42—72个百分点。
主评测排除了前序任务会移动目标配置的五组任务对。作者还在LIBERO-Object及xArm真机上测试恢复效果;真机覆盖七组有序任务对、三个切换时机,每个单元五次试验,证据范围仍限于这些设置。
该工作展示了通过推理时干预恢复既有任务能力可达性的路径,而非让VLA学会新任务。
结果来自作者论文实验,不应视为独立复现。方法依赖任务相对坐标与示范覆盖,需要按架构校准;大幅场景变化、抓持中动力学等未建模因素会使性能下降。
 2026-09-10 · arXiv · 作者论文CAP:通过学习式去噪实现感知—盲行连续自适应的人形机器人运动
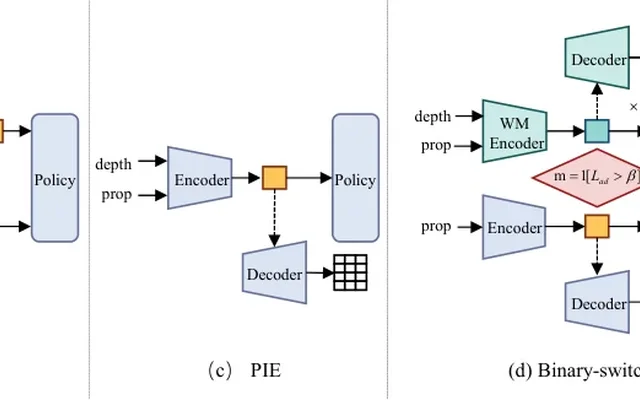
复杂地形行走需要提前感知障碍,但深度信号可能局部受损或间歇失效。作者提出CAP,针对部分受损深度中仍可恢复的地形信息,以双通路连续融合替代感知与盲行子策略之间的离散切换。
CAP采用单阶段训练:世界模型编码器接收受损深度,以独立的干净、姿态稳定深度为重建目标;本体感知变分编码器同时提供不依赖深度的身体状态信息。训练将输入端的深度噪声课程与策略端的世界模型特征丢弃配合,覆盖不同感知质量。世界模型用于去噪感知,不生成供策略优化的想象轨迹。
作者报告,仿真中CAP在Clean、Noisy条件下的平均成功率分别为99.6%、97.9%;这里Noisy仍保留部分有效深度,并非完全失明。仿真训练策略直接部署到宇树G1后,在楼梯、平台、沟隙及混合地形的干净与部分遮挡条件下合计完成39/40次试验。但完全遮挡时,楼梯成功5/5,平台、沟隙和混合地形各为0/5,表明连续退化不等于失去视觉后仍能跨越所有障碍。
这项作者研究展示了世界模型作为去噪感知模块、与本体感知持续协同的运动控制路径,而非依靠想象轨迹优化策略。
证据来自作者论文,并非独立复现;真机每个条件—地形单元仅5次试验。完全失去感知时仍受地形限制,大幅分布外几何误差与失步后的安全恢复尚未解决。
 2026-09-26 · arXiv · 作者论文生成、跟踪、改进:利用强化学习微调运动生成器实现感知式多技能人形机器人运动
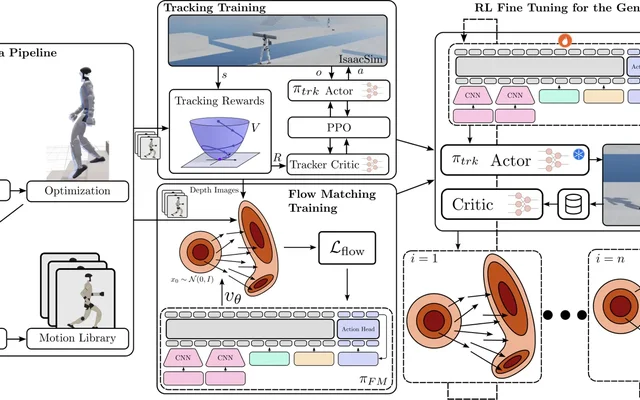
作者提出生成器—跟踪器双层架构:流匹配生成器依据深度图像规划全身轨迹,感知式跟踪策略执行;两者使用经动力学优化的人体动作构建地形一致的训练片段。核心改进是冻结跟踪器,对生成器进行离策略强化学习微调:通过初始噪声采样与条件扰动开展结构化搜索,收集闭环数据,再用优势加权回归更新生成器。双深度相机帮助提前观察地形,并在速度指令不变时减速,无需里程计或高度图。
在作者的IsaacLab仿真微调实验中,相对预训练策略,通过成功率最多提高25个百分点;成功要求限时到达目标且不跌倒。技能指标是采样回合中所有所需技能均选择正确的回合比例;某楼梯地形从0%增至约80%。每策略、每地形采样50回合,打乱后人工标注,无法判别计错。这些数字不是真机增益。作者另在宇树G1上展示室内外行走、跑步、上下箱体与楼梯,不能据此外推任意地形或速度能力。论文没有高速爬楼轨迹,也不支持高速跳上箱体;深度输入的语义不足及人工设计依赖仍是限制。
作者实验表明,生成器微调可调整技能选择与地形一致性,是跟踪器微调之外的补充改进环节;不据此推断通用运动能力。
证据属于作者论文中的仿真实验与真机展示,不作为独立研究复现或工程开放证据。定量提升相对预训练策略,不能混同为G1真机提升。仅用深度信息限制语义表达,当前无法编码某些箱形物体不应跳上的要求;微调奖励依赖人工设计,动作数据处理仍需手调过渡超参数,并以启发式或人工方式选择人体参考动作。
 2026-09-20 · arXiv · 作者论文CompVLA:面向接触密集操作的可变柔顺视觉—语言—动作模型
接触密集操作不仅要求机器人跟踪运动,还需调节受外力时的让步方式。作者指出,多数现有VLA采用纯运动学动作表示,细小跟踪误差可能导致失去接触或施力过大,单一固定刚度也难以兼顾自由空间精度与接触柔顺性。
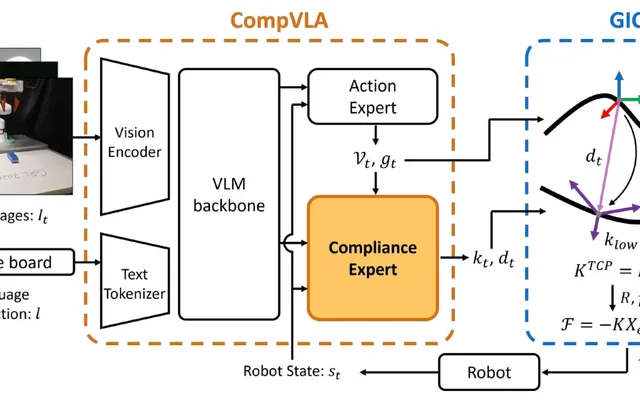
CompVLA在π₀基础上加入柔顺专家:动作专家先预测参考轨迹,柔顺专家结合该轨迹与视觉语言上下文,输出时变对角刚度和虚拟位移。虚拟位移既确定柔顺方向,又移动平衡目标以产生接触力;这些输出由几何阻抗控制器执行。训练标签来自示范中的力/力矩记录,评测时策略不使用力/力矩传感器读数。
作者在擦白板、支点翻转和杯子分配三项接触任务上报告,CompVLA平均成功率为67.1%,较本实验最强基线高12.7个百分点;但杯子分配单项未领先,不能解读为所有任务均优。
实验每项任务采集100条训练示范,结果按三次运行、每次每任务20回合评测汇报。擦白板指标是成功擦除字母的比例,其余任务采用二元成功判定;因此该平均值应结合任务口径理解,结论限于作者这组实验。
将方向性柔顺与主动施力纳入VLA输出,为连接多模态策略和底层接触控制提供了一条具体路线。
证据来自作者论文实验,不是独立复现。柔顺专家不能充分补偿较大轨迹误差;力/力矩派生标签不适合无接触力信号的接触前阶段,主导方向表示也可能不足以处理多方向柔顺或强旋转—平移耦合。
 2026-09-11 · arXiv · 作者论文打破视觉—动作捷径:面向可泛化机器人基础模型的潜在接口训练
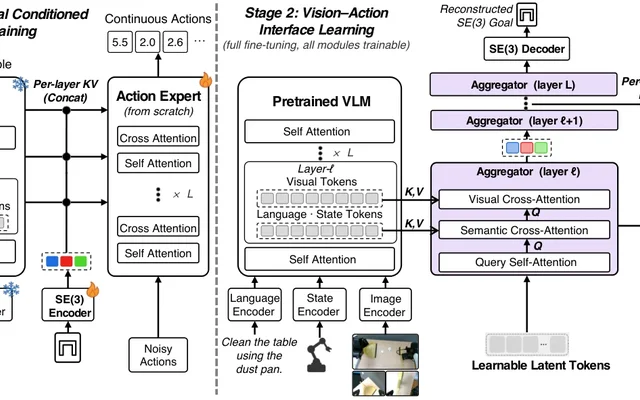
机器人模型可能依赖训练中与动作相关、却与任务无关的视觉线索,导致分布变化时泛化退化。作者提出潜在接口训练(LIT),用无图像动作预训练与位姿监督接口,约束视觉信息进入动作生成的路径。
第一阶段以语言、机器人状态和示范动作块的末端执行器终止位姿为条件,学习空间目标条件动作先验。第二阶段让潜在令牌聚合视觉与语义表征,成为动作专家的唯一视觉条件通道,并监督其重建同一终止位姿。推理时不需要该目标位姿。
作者在π0.5、MolmoAct2、FAST-WAM和ImageWAM上报告:相对各自配对基线,LIBERO-Plus总体成功率提高3.87—10.70个百分点,LIBERO平均成功率保持或提高。总体指标为七类扰动成功率的非加权平均;模型仅用原始LIBERO示范训练,测试时不适配。
真机实验仅比较MolmoAct2配对方案,使用三个任务共300条示范;按任务汇总后,光照、相机配置和干扰物变化下的成功率分别从53.3%升至70.0%、30.0%升至46.7%、50.0%升至63.3%。这些是作者实验结果,不宜直接与微调预训练策略检查点的已发表成绩比较。
该研究为“限制视觉条件如何被动作专家使用”提供了实验支持,而非仅增加视觉表征信息;支持范围限于论文测试的架构与条件。
基线与LIT均从预训练骨干和随机初始化动作专家起步,并非微调已有策略。作者明确指出,更大规模真机评估仍待开展,不能据此外推通用操作能力。
 2026-09-22 · arXiv · 作者论文VLAQuantBench:视觉—语言—动作模型训练后量化的闭环评测
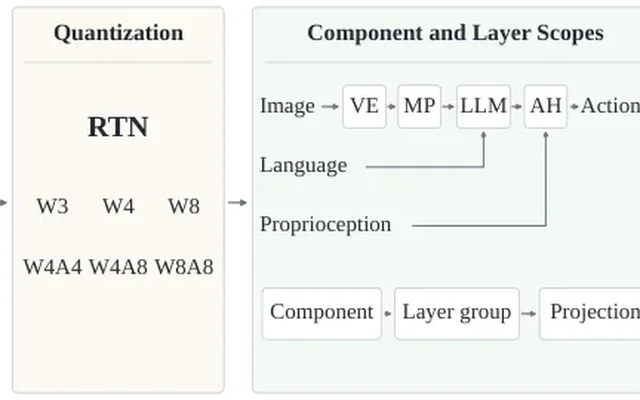
训练后量化能降低VLA模型的内存需求,但单层误差不足以判断闭环任务表现。作者提出VLAQuantBench,以统一的就近舍入(RTN)量化器控制数值格式与量化层范围,保留各模型原有推理约定;评测覆盖四个模型在LIBERO上的表现,共409次运行、94,574个仿真回合。
核心结果是量化更多层不一定更差:在未经校准的W4A4下,π₀.₅动作头量化范围由126层扩大至167层,Spatial成功率从7.0%升至70.5%,但仍低于基线。同观测回放也显示数值误差恢复。两回合校准可消除所测动作头子集的严重联合失效,但同类平滑与裁剪配方会降低π₀表现,且未使OpenVLA-OFT端到端恢复至基线附近。
另一项干预是在OpenVLA-OFT中保留输出投影的原始精度:其余441个合资格线性层采用W3时,LIBERO-Long成功率从端到端W3的8.0%恢复到93.5%,基线为92.5%。这些准确率结果使用模拟量化,并不等于实际部署加速;作者另测的真实量化内核虽降低峰值显存,却均慢于BF16。
研究支持将层范围、数值格式与校准配方联合做闭环验证,而非套用通用层敏感性规则。作者报告开放评测代码、配置、层范围定义和回合记录,为后续比较提供工程基础。
这是作者论文结果,不是独立复现。非单调恢复限于所测未经校准W4A4设置;真实内核评测仅覆盖一个骨干和一种GPU,所识别精度分配尚未在真机上验证。
机器人操作尚在进行时,模型能否理解当前进度,而非只认出画面内容?作者提出RoboChrono,以真实机器人执行和补充的徒手人类录像构建39个场景、34,713个评测实例,考察流式任务理解。
方法以因果观测边界约束输入:模型只能看到查询时刻及此前的观测,不能使用未来画面。七项任务分属识别、对齐和时间定位,覆盖当前动作、下一动作、帧匹配、帧排序等;18个多模态模型在无基准专用微调的零样本条件下接受评测。
作者报告,GPT-6-Astra的帧匹配准确率为98.3%,帧排序为68.3%;RynnBrain1.1-122B-A10B对应为95.4%和32.9%,表明匹配优势并不必然伴随排序优势。在五个开放权重模型、312个题干的平衡子集上,匹配问题消融显示:移除视觉后,当前动作识别下降22.1个百分点,下一动作预测仅下降0.7个百分点。作者据此提示,下一动作答案可能依赖任务和动作先验,不能仅凭预测得分判断模型是否利用了视觉历史。
该基准的诊断价值在于分开考察视觉识别与时间进度理解,避免仅用汇总分数掩盖能力差异。
这是作者论文报告的评测,不是独立复现或机器人闭环控制验证;数据包含成功执行录像及徒手人类场景,消融结论限于所测模型和子集,不宜外推通用操作能力。
 2026-09-29 · arXiv · 作者论文SCOUT:通过动作结果反馈实现测试时策略适配
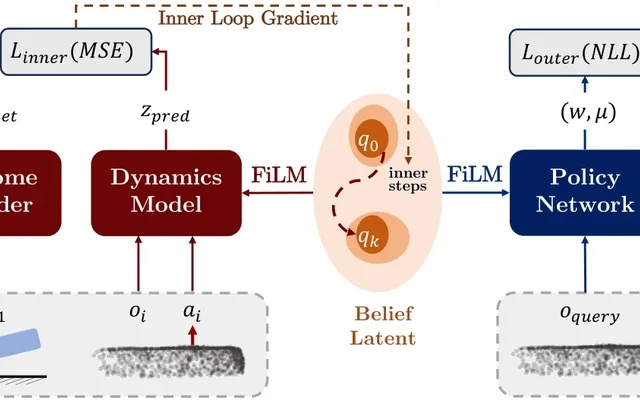
作者提出SCOUT,针对机器人部署时未知物理属性与动力学带来的适配需求,用动作结果预测误差提供反馈,而非仅依赖标量奖励。方法以共享信念潜变量连接动作策略与前向动力学模型:元训练内循环依据动力学预测损失更新信念,外循环以模仿学习损失优化网络;部署时冻结全部网络权重,仅更新信念潜变量。
作者报告,歧义门仿真基准以最多20步内完全开门为成功标准,5步适配的SCOUT成功率为0.97,历史条件GMM为0.68。主实验使用仿真器真值逐点流;测试时改用估计流后,5步适配成功率为0.96,成功试验平均步数由12.8增至14.94。
真机实验将仅在仿真中训练的模型用于偏心杆抓取和推动;每种方法、每个重心位置各测试10回合,每回合最多10步。作者报告,相比非测试时训练基线,两项任务均需要更少尝试。以上是作者论文实验结果;验证限于物理歧义,尚未覆盖复杂几何约束、感知错误,也未集成大规模基础策略,不能据此外推通用操作能力。
提供了一条通过共享信念潜变量,将动作结果预测误差转为部署时策略调整的路线,而不是直接微调策略网络权重。
证据为作者论文实验,不作为独立复现或工程开放的证明。门任务主结果使用仿真器真值逐点流,估计流测试仍属于该仿真基准;真机验证限于偏心杆抓取和推动。论文明确尚未验证复杂几何约束、感知错误等失败来源,也未集成大规模基础策略。
 2026-09-02 · arXiv · 作者论文TrAct:以视觉轨迹连接机器人控制与视觉预测
机器人动作依赖具体本体,其视觉效果又受场景几何、物体状态与接触动力学影响,难以直接为未来画面提供充分约束。作者提出TrAct,以二维点轨迹作为控制与预测的中间接口,让世界模型依据图像空间中的运动预测后果,而非仅依赖机器人动作。
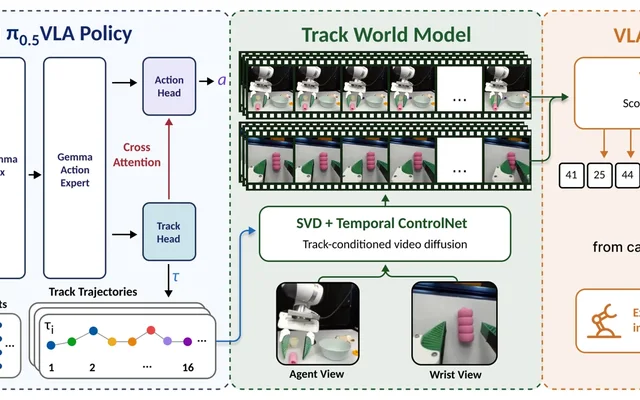
框架由三个模块协作:VLAT根据当前观测和语言指令联合生成候选动作及对应轨迹;轨迹条件世界模型TWM预测各候选的未来视频;视觉语言奖励模型VLAC按指令评分,机器人执行最高分预测所配对的动作。
作者报告,相比π₀.₅,TrAct在自建LIBERO-INTEGRAL上的成功率从27%升至55%,在Franka Panda真机任务上从49%升至76%;相比动作条件世界模型辅助选择,成功率分别从49%升至55%、66%升至76%。
这些结果有明确条件:LIBERO-INTEGRAL包含20项鲁棒性与跨本体任务;真机测试覆盖五项训练未见任务,各设训练背景与不同背景。推理时,仿真与真机分别生成20和16个候选,再进行预测与筛选。
作者实验支持将视觉轨迹作为策略与世界模型的共享接口,为通过未来画面评价候选动作提供了一条技术路径。
结论限于作者所设基准与真机任务,不外推通用操作能力,也不视为独立复现。主文仿真结果使用单个评测种子;附录另对TrAct与VLAT+AWM开展了三种子评测。
 2026-09-28 · arXiv · 作者论文利用视觉—语言—动作模型学习在视觉中断下行动
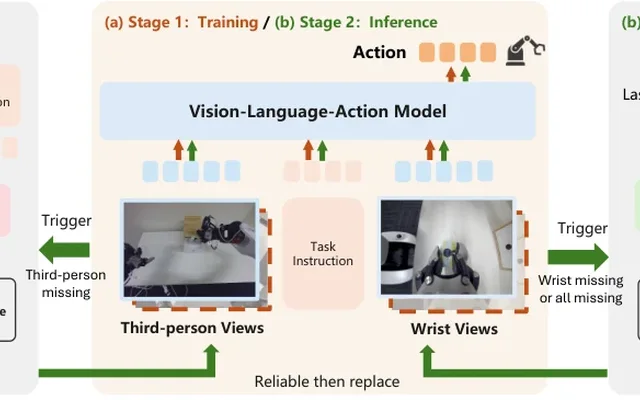
机器人执行任务时若摄像头突然断流,策略须在缺少后续观测的情况下继续操作。作者提出MAIL-Bench,在RoboCasa365的18项已见任务、900个固定场景中,按腕部、第三人称和全部视觉设置缺失条件,评测闭环操作的能力保留。
基准以各策略自身正常成功轨迹的完成时间为参照,在30%、45%、60%处切断相应视角,持续至回合结束。MINT结合缺失视角训练与选择性视觉预测:训练时标记不可用摄像头并屏蔽视觉词元;推理时,腕部或全部视觉缺失使用光流外推,第三人称缺失使用动作条件世界模型。预测未通过可靠性检查后,本回合不再使用,策略退回缺失输入状态。
作者报告MINT改善了π₀.₅与GR00T N1.5的中断表现,其中GR00T N1.5的MAIL-Bench综合分由0.246升至0.462。该分数结合正常成功率与仅在正常成功场景上计算的中断能力保留率,并非断流后的总体成功率。作者还在AgiBot G2的四项桌面任务中开展真机比较,每项任务、每种条件测试10次。以上属于论文内验证,不能据此外推跨本体或通用操作能力。
将摄像头完全停止供帧与可用图像的内容扰动区分开,并把预测失效后的缺失输入控制作为回退路径,为研究视觉断流下的闭环可靠性提供评测与方法设计。
MAIL-Bench目前仅覆盖一种本体和18项RoboCasa365 Atomic-Seen任务,更广泛的基准与机器人平台验证仍属未来工作;世界模型还增加推理与显存开销。本条证据身份为作者论文实验,不作为厂商声明、工程开放核验或独立研究复现结论。
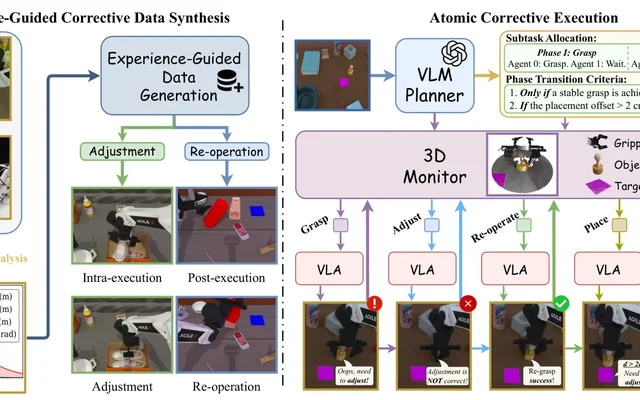 2026-09-21 · arXiv · 作者论文CARE:面向视觉—语言—动作策略的经验引导原子纠正执行
视觉—语言—动作(VLA)策略偏离正常执行轨迹后,可能进入训练数据少见的状态。作者提出CARE,将执行失败转为恢复监督,针对中途出错后如何继续完成操作,而非只学习成功示范。
方法以阶段条件失败分布为核心:收集失败轨迹,建模各阶段的几何偏差,采样生成新的失败状态并收集纠正示范。推理时,规划器拆分原子阶段,三维几何监控触发执行中调整或失败后重做;正常与纠正动作均由同一VLA策略执行。
作者报告,在所测基准与骨干组合中,仿真和真机任务成功率平均分别提高14.5和15.9个百分点。真机实验覆盖SO-101双臂平台四项任务,每项评估100次;π₀平均成功率由30.8%升至50.0%。这些是作者实验结果,不是独立复现结论。
论文还提出从中间失败状态出发的FSR-Bench。该基准关闭经验引导数据合成,配对方法使用相同的均匀采样纠正数据,以单独检验原子纠正执行;π₀困难组恢复成功率由15.8%升至21.2%,说明结构性故障恢复仍有明显局限。
将“从哪些失败中学习”与“何时调用纠正动作”分开设计,为VLA失败恢复提供了可分别检验的数据与执行机制。
结论限于作者所测任务和协议;FSR-Bench结果不能归因于经验引导数据合成。监控依赖技能级几何谓词,新增原子技能仍需定义谓词模板。
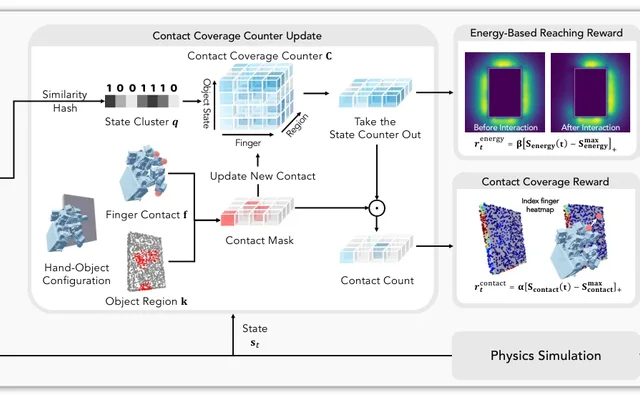 2026-09-29 · arXiv · 作者论文ContactExplorer:面向通用灵巧操作的接触覆盖引导探索
灵巧操作需要丰富的手—物体接触,但接触力新颖性信号可能不稳定,距离新颖性又不一定促成实际接触。作者提出ContactExplorer,将探索目标表示为手指—物体表面区域接触覆盖,而非仅鼓励接近物体。
方法用学习得到的哈希编码聚类物体当前与目标状态,分别累计接触次数,避免不同构型间的统计相互干扰;再结合接触后的计数新颖性奖励与接触前的能量式接近奖励,引导手指寻找尚未充分探索的区域。
作者在七项仿真任务上报告:使用40%训练预算时,平均成功率为75%,同预算各基线不超过47%。比较保持策略架构、观测和超参数一致,结果基于五个随机种子,平均值为七项任务均值的非加权平均。
真机杂乱物体分离采用教师—学生蒸馏,每种策略测试30次;相较仅用任务奖励,目标暴露成功率由36.7%升至76.7%,运送成功率由3.3%升至33.3%。暴露要求至少一半目标露出且可抓取,运送还要求抵达目标位置;两者差距主要来自暴露后未能接住并稳定物体。
作者实验支持将状态条件化接触覆盖作为灵巧操作的探索组件;受限物体取回实验显示,它可减少对人工接触初始化的依赖。
评估仍以仿真为主;循环状态下重复接触的奖励会衰减。跨手型实验分别训练策略,真机手内重定向采用开环教师动作回放,不能据此认定单一策略具备跨本体或闭环通用能力。
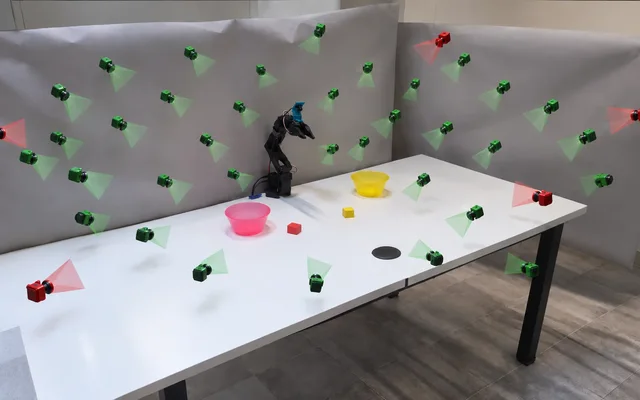 2026-09-23 · arXiv · 作者论文InfiNoVA:面向视角不变机器人策略的无限新视角增强
视觉—语言—动作(VLA)策略容易依赖训练时的相机视角,换到未见视角后性能下降;增加实体相机又成本较高、覆盖有限。作者提出InfiNoVA,用同步多相机演示生成密集、几何一致的训练视图。
方法以五台相机记录操作轨迹,利用InstantSplat++逐时刻重建三维高斯表示,再从虚拟相机位姿渲染新视图,保留原始语言指令与动作标签。增强在数据层完成,不改策略架构,推理时无需重建模块。实验采用SO-101机械臂与SmolVLA,覆盖拾放、清扫、分类和堆叠四项任务,每项采集70条演示。
作者报告,在相同随机视角评测协议下,各结果进行100次执行,InfiNoVA四任务平均成功率为40.5%,VISTA增强和未增强策略均为7.5%。另在仅针对拾放任务的100次测试中,直接使用五个实体相机视图训练的成功率为24%,InfiNoVA为40%。这些结果支持受控条件下的视角鲁棒性改善,不能外推为跨本体或通用操作能力。
提供了一条不改策略架构、通过保持状态—动作对应关系的几何视角增强改善相机鲁棒性的数据路线。
证据为作者论文实验,应按作者报告解读,不作独立复现结论。研究限于单一机器人平台、SmolVLA和四项受控任务;超出已观测工作空间的视角、其他本体与长时程任务仍待验证,逐时刻离线重建的扩展性也待改进。
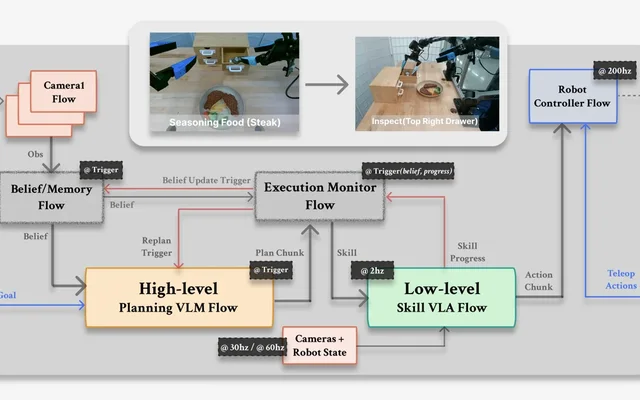 2026-09-11 · arXiv · 作者论文Retriever:组合面向长时程操作的感知—推理—行动闭环
长时程机器人闭环中,感知、信念更新、规划与控制的频率和延迟不同。作者指出,隐式时序与输入消费规则会使行为随调度变化,难以复现和调试。论文提出Retriever,结合异步决策模型、编程模型和运行时,将智能体表示为有状态因果流函数图;函数绑定显式时钟和输入快照规则后形成Flow,明确何时运行、读取哪些输入。
示例系统Retriever-0连接相机、信念与记忆、VLM规划、执行监控、VLA技能和控制器,以计划块和动作块衔接慢速规划、2Hz技能推理与200Hz控制;默认不打断当前技能。作者真机实验按任务进度评分:完整流水线的香料搜索为73%,是四个抽屉的平均值;袋中取物为100%,不能改称整任务成功率。
确定性重放要求固定确定性的代码与同步策略、初始状态、已提交外部输入、含滞后决策的时钟与提交轨迹,并满足严格因果反馈;随机调用须由日志中的种子或输出重放。保证针对事件路径,不承诺实时运行时GPU浮点结果逐位一致。上述任务结果不构成通用操作能力证明。
通过显式规定模块运行时钟和输入快照,并记录重放所需事件信息,为异步机器人闭环的调试与离线重执行提供系统化路径。
证据身份为作者论文中的任务实验,而非独立研究复现或工程开放证明。所列百分比是特定任务的进度指标,不是整任务成功率,也不能外推通用操作能力;重放保证依赖固定输入、轨迹和随机性记录等条件,不等于实时运行时GPU数值逐位一致。
 2026-09-27 · arXiv · 作者论文GINIO:面向神经惯性里程计的几何 SO(3) 等变接口
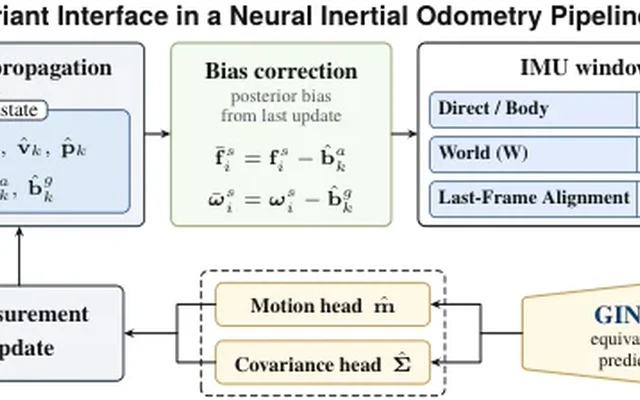
作者提出GINIO神经惯性里程计接口,使运动预测按向量、谱协方差按张量规律随IMU坐标旋转变换。网络接收校准、偏置校正后的IMU窗口,偏置等局部状态由连接的估计器维护。末帧对齐(LFA)将窗口样本统一到最后时刻的传感器坐标系;对全SO(3)等变预测器,它与世界坐标系训练仅相差最终旋转,但推理仍依赖相对姿态估计。
作者报告:TLIO世界坐标系、连接SCEKF的配置中,测试时旋转测量坐标系后,GINIO-W与EqNIO的ATE分别为2.018米和76.389米,不代表标称条件下全面领先。NanoBench采用纯网络协议,双方均无外部姿态输入时,GINIO-A与AirIO的ATE分别为1.430米和5.579米。
Fetch仅用标称安装训练,在未见物理重装下,GINIO-R与ResNet的平均ATE分别为0.50米和8.15米。轨迹按安装条件独立采集,以轮式里程计为参考,支持经验性重装鲁棒性,而非同轨迹配对验证。精确等变保证不涵盖物理重装附加误差或预处理姿态误差;上述结果均为作者论文报告。
为学习式惯性测量与滤波融合提供可用于不同骨干和估计器的几何设计原则;重点是旋转鲁棒性与有竞争力的标称精度,而非所有标称条件下均领先。
精确保证针对校准、偏置校正信号的坐标旋转,不消除重装引起的偏置、尺度或轴间失准、杆臂、振动、时序及预处理姿态误差;LFA仍依赖相对姿态。谱协方差构造的框架等变性以预测向量矩阵满秩为条件,对角协方差消融头不具备同样的张量保证。材料为作者论文,不是独立复现;代码、评测脚本和处理后的基准划分仅承诺发表时发布,不能据此认定已开放。
 2026-09-18 · arXiv · 作者论文从预训练到熟练掌握:以最少人工干预开展面向长时程操作的真实世界子任务强化学习
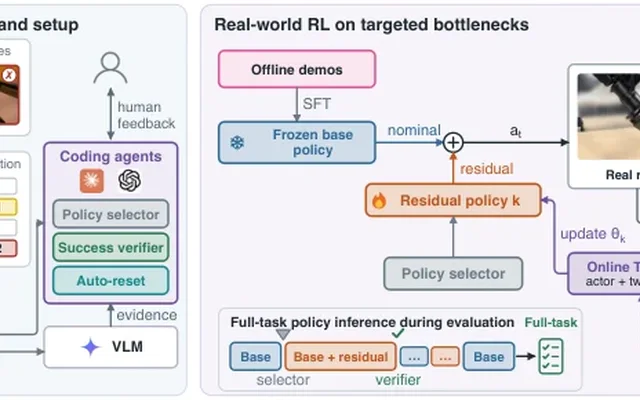
预训练机器人策略可能已能完成长任务的大部分步骤,却反复卡在少数瓶颈;完整任务示范会重复采集已有可靠行为,而末端稀疏奖励难以反馈中间步骤的改善。作者提出PARTS,将真实机器人强化学习集中于这些失败子任务。
方法先对π₀.₅进行任务示范微调,再冻结基础策略,仅在指定瓶颈启用有界残差修正。编程智能体生成选择器、成功验证器和重置程序,以局部结果提供奖励;在线TD3+BC结合成功重加权再训练与重新部署,保留全部成功经历及部分失败经历,继续收集数据。
作者在双臂YAM和单臂Franka上测试耳机入盒、乐高分拣和线缆拔插,每种方法每项任务评估20个完整回合。乐高仅报告进度分数:17分钟强化学习交互后,分数由54%升至82%;线缆任务经29分钟交互,插入成功率接近翻倍。
比较匹配的是机器人交互时间,不含物理重置和更新暂停,不能据此认定总耗时或算力成本相同。人工仍需识别瓶颈、制定约束;耳机任务还需核查成功标签,并在机器人无法恢复场景时协助重置。
提供一种保留基础策略、用局部奖励集中修补失败环节的适配路径;改进仍以完整任务执行评估,而非只看孤立子任务。
证据为作者论文实验,不是独立复现。评估限于文中三项任务;乐高进度分数不能等同完整任务成功率,“最少人工干预”也不代表全自主。
 2026-09-06 · arXiv · 作者论文IM-ENGINE:用于具身数据生成的图像编辑
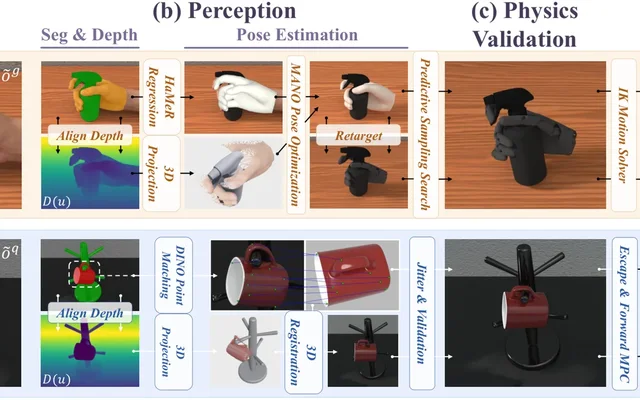
机器人操作数据需要同时表达任务意图并满足物理可执行性;人工示范采集负担较重,纯仿真生成又可能忽略功能性接触。作者提出IM-ENGINE,以图像编辑作为中间表示,面向功能性灵巧抓取与目标状态生成。
流程先编辑仿真渲染图,再利用已知几何、深度、分割、相机参数及保持不变的锚定物体恢复三维状态,经物理验证与轨迹生成转为机器人监督数据。抓取分支重建人手与物体交互并重定向至机器人手;目标分支恢复物体位姿,筛除碰撞和不稳定状态。
作者报告,在五类物体的ShadowHand评测中,用生成数据微调的DRO达到99.4%举升成功率、83.2%功能成功率;前者在Genesis仿真中测试,后者由五名标注者检查并取平均。八项任务的目标状态生成成功35/40,同一实验中的PhyScensis为11/40,成功须同时满足仿真物理合理性与预期任务关系。真机衣架挂钩、杯子挂架策略各测试10次,成功率分别为70%和50%;每项策略使用约1,000条仿真轨迹训练。
其价值在于把生成图像中的任务语义转成可验证的三维状态与轨迹,而不只将图像作为视觉目标;作者实验展示了这一路径用于抓取和关系约束型放置的可行性。
结果属于作者论文评测,不应视为独立复现或通用能力证明。流程依赖适配的成对三维资产;编辑可能改变锚定物体或产生不可行交互,薄结构、插入和悬挂中的碰撞与接触仿真仍有困难。
 2026-09-16 · arXiv · 作者论文通过互联实现抓取:基于粗略物体模板的鲁棒闭合运动
物体形状、尺寸和位姿估计不准时,灵巧手的闭合动作本身能容忍多少误差?作者提出“互联抓取”规划器,将闭合运动的鲁棒性与执行中的反馈纠错分开评估。
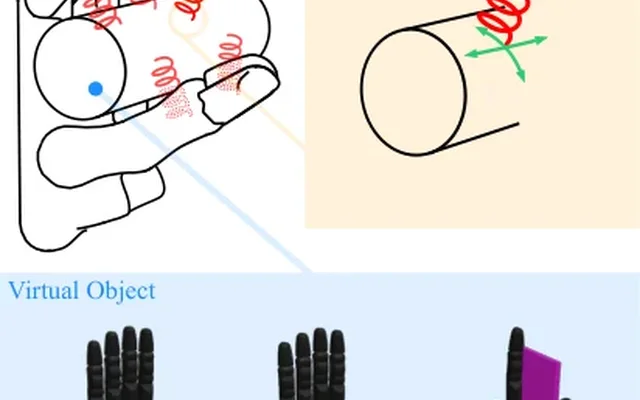
方法以圆柱、球体或扁盒为粗略模板,结合人类抓握类型,通过虚拟弹簧、阻尼器与可滑动接触端点耦合虚拟手和物体,不预设接触点。虚拟模型控制在仿真中生成完整闭合轨迹,实体手随后跟踪;闭合期间不使用真实物体的测量反馈,但仍有手内部的位置控制。
作者在Shadow灵巧手与UR10e机械臂上报告:动作可容忍约1厘米尺寸误差,以及数厘米平移和数十度旋转误差。在相同扰动协议下,相比D(R,O) Grasp,27个轴向—物体组合中有25个具有更宽的位姿误差容忍范围;基线使用理想点云,每个扰动须至少三次生成抓姿中的两次成功。日常物体测试覆盖80件,抓取成功比例为82.5%。
实验以物体举起五秒且不滑落为成功标准。研究只规划给定预抓取位姿后的闭合,不涵盖到达、杂乱场景或模板选择;上述比较不代表通用操作能力排名。
作者结果支持将部分抗几何误差能力直接设计进闭合轨迹,而非完全交给反馈纠错;这是闭合运动规划层面的证据。
比较中基线可能在移动时拖动物体,减小实际扰动并高估其鲁棒性。规划器不估计或适应描述误差;论文中的代码开放说明仍是双盲评审后发布的承诺,不能据此认定已开放或已有独立复现。


该研究为“语言推理—执行—监测—重规划”提供了共享的显式规范接口,支持在所测操作任务中将任务完成与约束满足分开评估。
证据来自作者论文,不是独立复现。固定谓词与技能映射限制全新任务泛化;低层控制的短滚动时域使远期截止时间影响有限,执行落后后的追赶能力不足。