多物体多目标投掷的快速规划
多物体、多目标投掷需要兼顾动作耗时与规划开销。作者提出MOMT规划框架,让机械臂在连续运动中将手持物体投向不同目标,重点解决逐个独立规划可能造成的关节空间大幅转移。
展开阅读 具身图谱在图谱中把握具身智能
本期串起三个问题:世界模型画出的失败能不能当真,指令换目标后策略会不会照旧跑,真机与公开数据能支撑多大判断。失败轨迹回灌、合成数据改写、语义校准与真机横向对照都给出了正面数字,也都带着明确的失效条件,适合按条件读,而不是照单全收。
多物体、多目标投掷需要兼顾动作耗时与规划开销。作者提出MOMT规划框架,让机械臂在连续运动中将手持物体投向不同目标,重点解决逐个独立规划可能造成的关节空间大幅转移。
展开阅读人类操作视频可为灵巧机器人学习提供经验,但保留裸手交互外观时,难以同步获得运动与触觉监督。作者提出ExoBridge,利用双手协调操作形成跨手监督,学习从裸手视频到传感外骨骼状态的映射。
展开阅读问题。 视觉-语言-动作模型(VLA,把图像与指令转成机器人动作的通用策略)对两类改动常反应反了:只改外观(打光、风格、杂物、措辞)时任务语义未变,动作本该稳定却出现多余漂移;目标物体或约束真被换掉时,却照旧跑原轨迹。论文把两者称为互补的失效模式。
展开阅读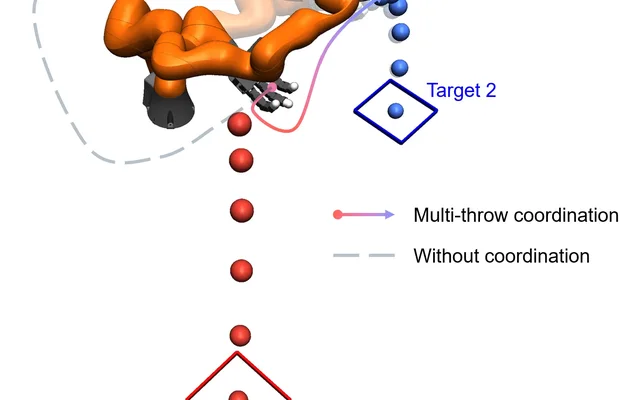 2026-10-07 · arXiv · 作者论文多物体多目标投掷的快速规划
多物体、多目标投掷需要兼顾动作耗时与规划开销。作者提出MOMT规划框架,让机械臂在连续运动中将手持物体投向不同目标,重点解决逐个独立规划可能造成的关节空间大幅转移。
方法将单目标解生成与多目标协调分离:利用固定基座机械臂的旋转不变性压缩表示,将描述有效释放状态的后向可达管与机器人最大速度字典匹配,每个目标的可行投掷构型生成耗时低于5毫秒;协调阶段以剪枝Greedy搜索权衡规划时间与执行耗时。
在Kuka iiwa 7搭配Allegro手的双物体实机实验中,10组目标配置下,Greedy相比Naive独立规划使执行时间减少29%,但规划耗时为69.8±32.3秒,Naive为0.06±0.02秒;两者均投中14/20次。动态改靶演示采用Naive,总重规划延迟低于100毫秒,无需停机,不能将该响应速度与Greedy的执行收益合并理解。
这些结果来自作者实验:实机抓持构型经手工调试,三、四物体扩展仅在仿真中评估;框架假设投掷空间无障碍,并将飞行物体视为不计气动与自旋的质点。
 2026-10-06 · arXiv · 作者论文ExoBridge:通过人体肢体耦合学习从裸手到手戴式外骨骼的映射
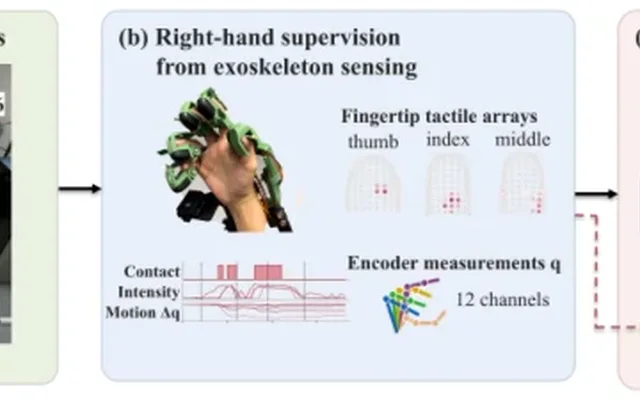
人类操作视频可为灵巧机器人学习提供经验,但保留裸手交互外观时,难以同步获得运动与触觉监督。作者提出ExoBridge,利用双手协调操作形成跨手监督,学习从裸手视频到传感外骨骼状态的映射。
采集时,裸露左手操作一个物体,佩戴外骨骼的右手在另一份物体上协调执行同一任务,同步提供编码器和触觉测量;不要求双手关节轨迹完全一致。时序视觉模型学习预测指尖接触、连续触觉强度及相对初始状态的编码器变化,推理仅使用裸手RGB视频。
作者在四项操作任务的1,215段示范上,按采集会话划分五折并使用三个随机种子评估。汇总任一指尖接触AUROC为0.916,触觉强度Pearson相关系数为0.790;编码器通道0—9的运动平均绝对误差为4.15,零变化基线为7.51。结果限于既有任务内的留出会话和固定相机条件下的离线状态预测,尚未验证桥接预测驱动的闭环控制。
将外骨骼测量用作另一只裸手视频的监督信号,提供了连接视觉示范与机器人相关状态空间的路径;运动输出通过既有标定关联机器人手。
证据来自作者论文,不是独立复现。触觉目标属于对侧外骨骼;配套机器人实验直接使用外骨骼示范,不能视为桥接预测的闭环验证。数据与评估代码仅声明将发布。
 2026-10-21 · arXiv · 作者论文超越外观变化:为 VLA 模型做任务语义动作校准(Beyond Appearance Shifts: Task-Semantic Action Calibration for VLA Models)
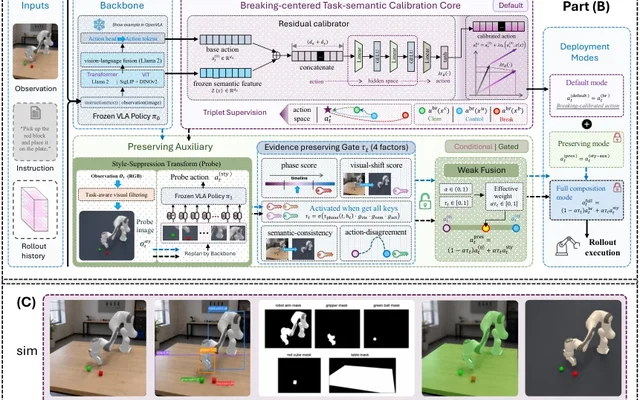
问题。 视觉-语言-动作模型(VLA,把图像与指令转成机器人动作的通用策略)对两类改动常反应反了:只改外观(打光、风格、杂物、措辞)时任务语义未变,动作本该稳定却出现多余漂移;目标物体或约束真被换掉时,却照旧跑原轨迹。论文把两者称为互补的失效模式。
方法。 BAS-VLA 不换骨干、不重训基础策略,只在共享 VLA 的动作输出上挂一层轻量校准:默认的“破坏中心校准核”用干净/保义改写/语义破坏改写三联指令训练,要求干净与保义两路靠近干净参照、彼此靠近,破坏一路被推离干净动作区;另配一支按证据开启的保义辅助,只在干扰证据强、语义仍一致时弱修正基础动作。
结果(作者自测)。 四个目标物体互换任务聚合:改变后的任务成功率由 18/800(2.3%)升到 548/800(68.5%),旧任务成功降到 0/800。Milk-Swap 干净 98.0%、保义对照 97.5%、破坏条件下旧任务 0/200;黄油→奶油奶酪仍残留 113/200(56.5%)。风格偏移由 84/200(42.0%)升到 140/200(70.0%)。真机四个语义改变案例各 80 次试验,合计 15.9%→51.9%。
条件与代价。 语义破坏用 OpenPI-pi0.5 + LIBERO-Object,保义用 OpenVLA-OFT + LIBERO-Spatial(作者自行微调的载体);破坏中心核 p50 增加 47–53 ms,保义与组合模式端到端 p50/p95 为 924/1,048 与 972/1,112 ms。
对做机器人本体软件的开发者,可借鉴的是接入方式而不是网络结构:校准层作为可插拔组件挂在共享 VLA 的动作输出上,骨干权重不动,训练侧额外准备“保义改写”和“语义破坏改写”两类指令对即可,推理侧默认路径的代价是 p50 增加 47–53 ms。作者主张的工程逻辑是:目标或约束真变时,先让策略“不再按旧任务继续跑”,再谈改对,这比笼统追求鲁棒性更贴近部署中“指令换目标”这类变更。保义支路则把“什么时候才允许改动基础动作”写成显式证据门控,可用于设计回退与监控策略;但它需要再查一次冻结策略,端到端延迟接近 1 秒,按其量级更适合作低频或早期修正,不宜放进高频控制回路。文中全部数字来自作者自测的仿真与真机试验,本次材料未见独立复现。
证据全部来自作者论文(LIBERO 仿真 + 论文内真机试验),本次材料未见独立复现;保义侧的 OpenVLA-OFT 载体是作者按 OFT 配方自行微调得到的,不是现成公开权重。语义破坏侧对视觉与语义相近的物体对仍失效:黄油→奶油奶酪在破坏条件下旧任务成功率达 113/200(56.5%),是该方法目前最明显的负例。门控会误触发也会漏触发:干净 7.5%、语义破坏 8.0%、保义偏移漏触发 23.5%,即便用 oracle 路由这一上界,任务保持率也只有 91.5%。保义侧只在已验证的干扰族上有选择性收益,作者自己并未把该方法定位为通用保义分支或通用鲁棒性层。保义与完整组合模式端到端延迟接近 1 秒(p50/p95 924/1,048 与 972/1,112 ms),不适合高频控制回路;真机部分每方法每案例 80 次试验,规模也有限。
 2026-10-03 · arXiv · 作者论文EgoFound3R:具有逐点交互属性的世界空间端到端第一视角手部重建
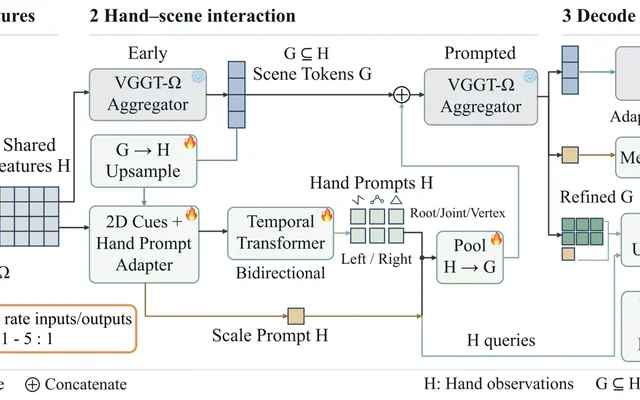
第一视角视频中的相机运动、手物遮挡和绝对尺度缺失,使世界坐标下的手部重建困难;分阶段估计手部、相机与接触还会重复编码,制约标注吞吐量。作者提出EgoFound3R,将手部几何与逐点交互属性纳入统一模型。
方法以结构化手部提示复用冻结的VGGT-Ω几何骨干,通过显式点表示共同解码几何、可见性、接触和距离;共享参数多速率设计保留密集手部观测,降低全局场景聚合频率。推理仅需单目视频,不依赖深度、标定、物体模板或独立检测裁剪阶段。
作者报告,在OakInk-v2、TACO和HOI4D上,相对各自最强基线,未对齐平均关节位置误差(Raw MPJPE)分别下降43.2%、22.4%、11.6%。在单张NVIDIA H20、512×512输入的报告配置下,手部观测处理吞吐量为28.69帧/秒,是WiLoR的5.97倍;该指标不是插值后的输出帧率。
比较受评测协议约束:百窗口子集仅在匹配组内排名,世界坐标指标区分真实与预测外参。模型依赖未来帧插值和整段对齐,仍属离线方法,不能将吞吐量视为在线部署能力。
把几何与交互属性解码合并,并减少重复场景聚合,为第一视角视频的大规模手部标注提供一条统一处理路线。
结果应按作者论文报告解读。接触基线的接触定义不同,几何基线还使用真实手物几何,不能据此作无条件排名;离线处理也不等于实时部署。
 2026-10-05 · arXiv · 作者论文面向端到端驾驶安全评估的可控、照片级真实行人危险动作生成
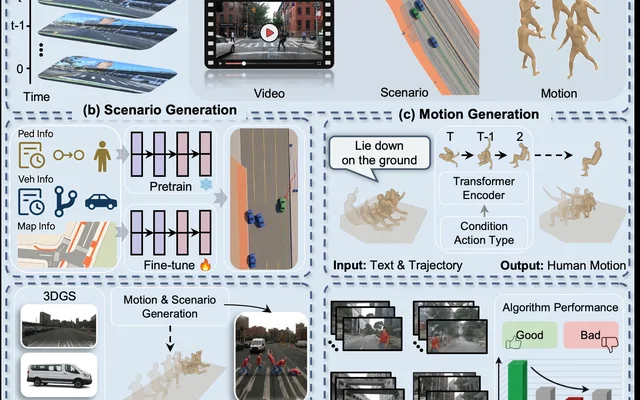
罕见的车—行人高风险交互难以为端到端驾驶评测提供充足的传感器级数据。作者指出,轨迹生成方法不能合成原始视觉观测,视频方法则缺乏行为可控性,因此提出ControlPed,将冲突轨迹生成、人体动作合成与3D高斯泼溅渲染串联起来。
框架基于HazardPed数据集,包含高精地图及857段标注人体动作。方法先生成冲突轨迹,再通过文本条件扩散模型生成三维人体动作;生成过程中固定根节点水平位置,使动作对齐目标轨迹,最后将可驱动行人化身注入重建场景,输出多视角视频。
作者在88个人工检查的渲染场景中评测七个端到端驾驶模型,报告平均HDScore从88.8降至47.4。下降主要来自路线完成度、无碰撞和碰撞时间指标,可行驶区域合规性基本不变。
测试使用官方预训练权重,不作微调,且全部采用开环评测;路线完成度使用代理定义,在首次出现未来0.5秒内碰撞的关键帧终止路线。上述结果反映该渲染协议下的行人风险响应,不能直接视为闭环交互或真实道路安全结论。
为端到端驾驶提供兼顾行人动作控制与视觉渲染的风险场景生成路径,可用于部署前安全测试。
证据来自作者论文实验,不是独立研究复现;当前仅为开环设置,闭环交互仍是后续方向,结论应限定于所述评测协议。
机器人操作时,既要预测动作后的画面,也要生成动作,并理解物体的空间关系。Thinker-WM针对这些功能常由不同模块衔接的问题,把彩色视频、具有实际距离尺度的深度图和机器人动作放进共享中间表征,共同预测其变化。对开发者而言,这提供了用同一模型做未来预测、动作生成和视频转动作的接口思路。
模型保留各类输入输出专用的编码器与解码器,核心由统一动态变换器共享参数处理。深度并非仅作辅助标签,而是参与生成;训练初期深度读取视觉与动作信息,到具有准确深度监督的目标机器人微调阶段,再开放双向信息交互。
作者报告,给同一模型输入真实动作序列并移除语言提示后,EWMBench生成总分由4.66升至5.03,支持动作条件确实影响预测。在RoboTwin仿真的开关任务中,双向交互配置的闭环成功率为75.0%,纯彩色视频配置为60.0%;结果汇总三个训练检查点,每个检查点测试20次。这是特定仿真任务的对照实验,不能视为真机部署效果。
为机器人软件开发提供一种统一预测与动作生成的模型接口设计,并用受控实验检验动作输入和深度交互是否发挥作用。
证据来自作者论文,不是独立复现。闭环对照仅覆盖所述仿真开关任务;作者明确表示,作为真机闭环策略的有效性仍待验证。
 2026-10-15 · arXiv · 作者论文TGrasp6D:任务引导的视觉语言先验与位姿细化实现零样本任务导向六自由度抓取
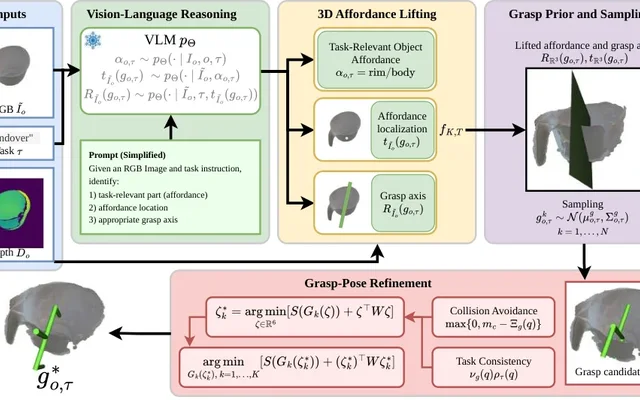
作者提出TGrasp6D,以单次RGB-D观测和自然语言任务指令生成任务导向的六自由度抓取,无需任务专用训练或微调。方法先由视觉语言模型识别并定位与任务相关的物体功能部位,预测图像中的抓取方向,再将这些线索提升至三维,形成任务引导的抓取先验;随后采样候选位姿,通过优化兼顾避碰与任务区域一致性。在TaskGrasp评测中,作者仅保留至少有20个人工标注抓取的物体—任务对,共310个实例;成功判据为夹爪扫掠体积与任一对应真值抓取的交并比至少达到0.1。按该协议,TGrasp6D成功率为94.5%,最强基线FoundationGrasp为73.7%;移除位姿细化后降至89.4%。作者还在Franka Research 3上测试5件物体、10种物体—任务组合,每种组合进行10次试验,TGrasp6D成功93/100次,GraspGPT与FoundationGrasp分别为41/100和52/100。这些结果属于作者论文实验,应分别按数据集协议和真机测试范围解读。
该工作展示了先以任务语义约束抓取生成、再做几何细化的路线;消融支持细化改善几何可行性,但不能充分纠正选错功能部位的问题。
单视角输入易受深度噪声、遮挡及点云缺失影响;方法依赖大型视觉语言模型,存在时延与成本负担,且未显式建模接触力学或闭环执行。
在 RoboTwin「调整水瓶」任务上,已公开的世界模型 Boundless World Model(BWM)基座 `step-12000` 只用规划成功的轨迹训练,会把策略抓取失败的片段渲染成成功,冻结分类器因此把 82.5% 的仿真失败误读为成功,画面没法用来判断一次操作是否成功。
该 Hugging Face 模型卡发布了一个微调检查点:改用含失败的 rollout(试错轨迹)再训 750 步,留出片段上失败误读为成功的比例降到 0.263,成功召回 0.964;只用成功数据微调无效(0.860)。权重与基座同结构,可直接替换 `step-12000.safetensors`。
它也能当强化学习环境用:在模型内用 PPO(近端策略优化)训练 π0.5 共 10 次策略更新,在 144 个留出初始状态上回到仿真器评分,5 个种子全部优于 SFT(监督微调)策略、平均高 9.7 分,但依赖三处 PPO 改动。
局限:动作细节决定成败时,训练数据中 29% 的失败仍被渲染成成功;训到 1000 步假成功率更低,成功召回却从 0.91 降到 0.73。数字均出自作者自述的模型卡,未见独立复现。
对机器人软件开发者来说用处很具体:世界模型(world model,即根据动作生成后续画面的模型)产出的视频一旦把失败画成成功,就不能拿来判断这一把有没有抓住;这份检查点显示,把失败轨迹喂回世界模型能明显压低这种「假成功」(留出片段上失败误读率由 0.825 降到 0.263,成功召回 0.964)。权重与基座同结构(同一 DiT 扩散变换器与动作编码器状态字典,仅推理权重),可直接替换 `step-12000.safetensors`,接入已有推理管线改动很小。接入时照卡片的推理契约即可:每窗 61 帧(1 初始帧 + 8 历史帧 + 52 未来帧),`num_inference_steps=50`、`cfg_scale=1`、`action_mode=adaln`,动作取 BWM 的 `eef_abs` 空间;卡片还提示发布管线在 50 步推理时历史噪声分支实际不起作用,需要自己加噪。把模型当 PPO 训练场的用法同样出自这份作者材料。
全部指标出自作者自己发布的模型卡(由 AI 编码助手 Cursor 起草、作者复核),本次未见独立复现,也未涉及真机实验;评测全部在 RoboTwin 仿真中完成,只覆盖一个任务、一种本体、一个头部相机和单一策略家族的 rollout,动作细节决定成败的初始状态上训练数据中仍有 29% 的失败被渲染成成功。材料是抓取时的网页快照,本次时间戳取自 HF 页面的最后修改时间,模型卡属滚动更新页面,其首发日期不能证明文中所有表述都在报告截止前已存在。
 2026-10-19 · arXiv · 作者论文Humanoid SRL:通过额外肢体增强人形机器人的协同行走与操作
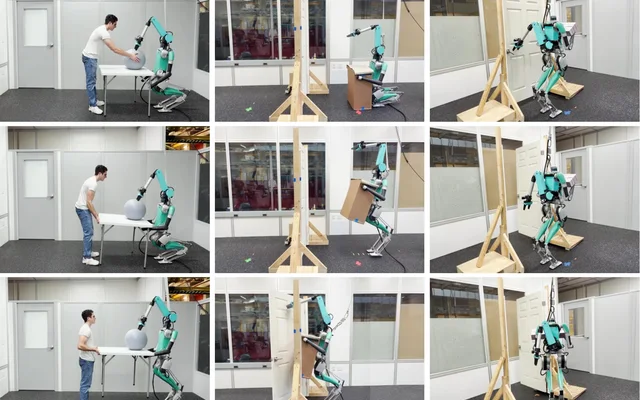
双手抱箱时怎样开门,搬动物体时怎样腾出手支撑身体?作者为人形机器人加装一条四自由度的额外机械臂,分别测试颈部和背部安装方式。真机展示中,原生双臂持续抱箱,颈部机械臂在行走时推门,背部机械臂则从身后操作门把手;改变的不只是触达范围,还有三条手臂之间的任务分工。
控制上,系统先用全身轨迹优化生成满足动力学、接触和关节力矩限制的参考动作,再训练强化学习控制器跟踪。教师策略利用仿真内部信息指导学生策略,部署时仅保留使用机身传感信息和任务参考的学生控制器;作者报告其从仿真零样本迁移至真机。
在外部框架支撑实验中,背部机械臂提供额外接触后,机器人承受了重复前后扰动,幅度达到实验安全上限10厘米;无该支撑时,在7.5厘米扰动下失衡。部分自主任务另接入扩散策略,即根据彩色、深度图像和机身状态生成短时动作目标的视觉规划层,底层控制器不变。作者展示了高架取物交付、堆箱稳定和搬箱过门三项自主任务,但新环境、新物体及更长流程的泛化仍待研究。
对本体软件开发者,这项研究提供了额外机械臂与全身平衡统一控制、上层视觉规划与底层执行分离的设计参考,而非把第三臂当作独立机械手。
证据来自作者论文及其真机实验,不是独立复现。轨迹优化的任务代价与接触时序预先设定;视觉自主执行仅覆盖所选任务,不能据此外推通用自主能力。
 2026-10-22 · arXiv · 作者论文苦涩的教训可能正走向机器人:9 个前沿模型在真机上操控机械臂的系统评测
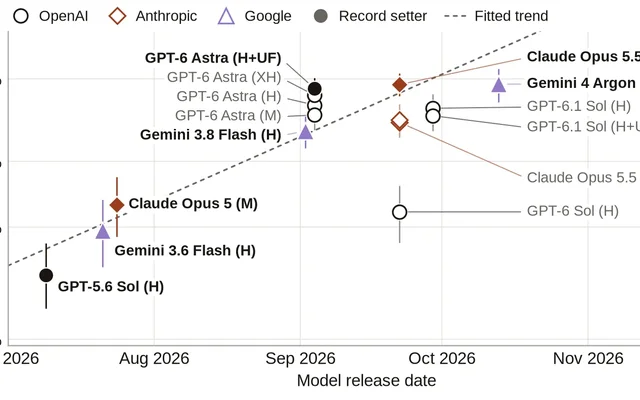
通用多模态大模型(能同时处理文字与图像的大模型)已能直接操控真机机械臂,但此前真机上的跨模型比较很少,真机的下垂、标定漂移、定位散布等误差也难在仿真中复现。作者在 RoboDojo 基准的六个操作任务上,用同一台双臂真机与同一套接口评测九个前沿模型、十五个(模型,配置)组合,并称这是首次在真机上对广泛前沿模型的系统比较。
评测由 Inspect Robots 框架闭环执行:模型每轮选一个动作,执行后把新观测追加回上下文,直到模型主动结束、耗尽 40 步动作预算或触发硬件故障。可用动作只有 move_to(每条臂提交含位置、姿态、夹爪开度的 7 元末端位姿,框架用逆运动学转成关节角)、done、give_up。任务拆成递进子任务按 0%–100% 打分,由 GPT-6 Astra(H)按三路相机录像评分。
当前模型已能完成多种真实操作,但精度与效率不足以在可接受的动作预算内可靠完成:最强模型平均得分 45%–48%,是持续的部分进展而非端到端成功;「扶正瓶子」在九个组合共 180 次试验中只有六次立起一个瓶子。弱模型主要输在抓取,GPT-5.6 Sol、GPT-6 Sol 合拢夹爪却没抓稳的比例达 64%、59%,Astra、Opus 5.5、Gemini 3.8 Flash 为 32%–39%。
进步很快:2026 年 7 月至 10 月性能翻倍时间 53.9 天;最好的子任务完成速率从每小时 12.4 个升到 54.4 个(57 天内 4.4 倍),最低每子任务 API 成本从 2.36 美元降到 0.38 美元(约 55 天内 6.2 倍)。但没有模型全面占优:GPT-6 Astra(H+UF)平均 1.1 分钟完成一个子任务却要 4.51 美元,Gemini 3.8 Flash(H)只要 0.38 美元却要 4.18 分钟;得分最高的 Gemini 4 Argon(H+PR)48.4%、0.97 美元/子任务,却只有 7.1 个子任务/小时,高推理延迟还可能让手臂过热而中断试验。作者由此提出「苦涩的教训」(Bitter Lesson)可能正走向机器人领域,这是趋势判断而非已验证结论。
对做机器人本体软件和具身策略接入的工程师,这篇评测把「大模型能操作真机」换成了可对照的工程量纲:同一台真机、同一套动作接口下的得分、每个子任务的耗时与 API 花费。40 步动作预算下最强模型也只有 45%–48% 的部分完成度,接入流程不能按「一条指令完成搬运」来设计;速度与成本明显反向取舍,选型要按自身节拍和预算匹配,而不是只挑分数最高的模型。弱模型把动作预算浪费在空夹和反复找位置上(Opus 5 平均要 6.7 个动作才把夹爪移到正确位置),提示动作接口设计、失败恢复与抓取自检逻辑可能比换模型更值得先做——这是本篇报道的工程推论,不是论文结论。文中「苦涩的教训」是作者的趋势外推,不是已验证的落地效果。
证据仅来自这一篇 arXiv 预印本全文(v2,2026 年 11 月 1 日抓取的页面),内容可滚动更新,后续版本可能改写结论,本次未包含独立第三方复现。评测只覆盖一台双臂真机上的六个任务与 40 步动作预算,结论不外推到其他本体或长时任务。53.9 天的翻倍时间只基于 2026 年 7 月至 10 月的纪录组合,95% 自助法置信区间为 36.1–59.5 天,且 45% 的重采样中 Gemini 4 Argon(H+PR)是否为纪录刷新者并不确定;速率与成本的拟合趋势分别只有四个和三个纪录组合,作者自称探索性。得分取「过程中曾达到的子任务」且由 GPT-6 Astra(H)判分,可能高估最终状态。「扶正瓶子」的结果还受该任务设置限制(如末端俯仰限于 ±0.6 弧度、瓶子离基座较远),不能当作模型能力上限。
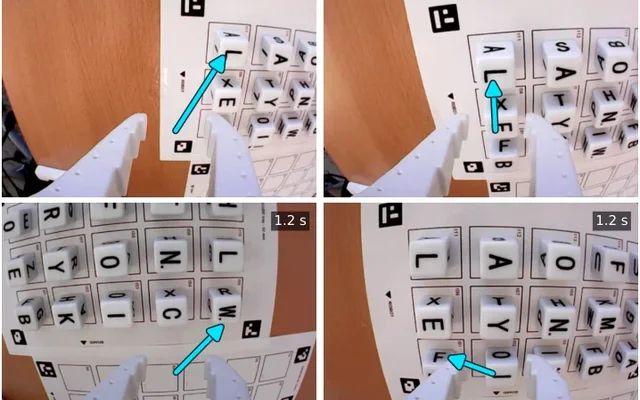 2026-10-03 · arXiv · 作者论文连接前沿推理与机器人执行:从自主示范生成到密集语言监督
前沿模型的推理与API延迟限制了机器人控制的响应速度。作者提出两条互补路径:让前沿模型生成示范、补充人工数据训练快速本地策略;部署时由前沿模型给出高层指令,本地策略负责动作执行。
第一条路径在上下文中加入纠错示范片段,展示如何依据视觉反馈修正物理误差。四项操作任务中,每项使用20条人工与20条生成示范训练的策略,与使用40条人工示范的策略均取得41/80次成功。部署时,前沿模型与本地策略组成的执行框架取得52/80次成功,本地策略单独执行为41/80次;这一结果不代表两种训练数据统计等效。
第二条路径对相同轨迹提供基元、原子子任务、复合任务三级标注,并加入多角度语言描述。在Fable 5指导下,联合监督使RoboCasa 365成功率从0.381升至0.485,BEHAVIOR-1K平均子目标进度从0.084升至0.143;两者不是同一种指标。比较采用相同预训练起点与训练步数,但评测任务已包含在训练任务集中,不能据此推断未见任务泛化。
作者实验支持将示范生成与语言接口训练作为互补环节:不仅要让本地策略执行得快,还要让它理解前沿模型的指令。
主要语言监督比较仅用两组训练/评测种子。低延迟本地控制不等于整个系统实时;物理部署耗时仅统计成功试验,并排除硬件修复时间。
 2026-10-12 · arXiv · 作者论文PINT:以共享预测意图统一机器人操作的模型
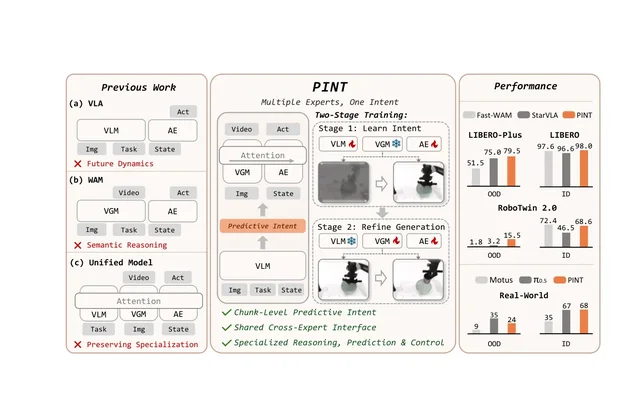
把视觉-语言模型和视频生成模型在多层共享注意力里直接融合,会迫使两者各自专长的表示兼顾跨专家协调,作者认为这反而让它们更难用出各自强项。PINT 的思路是只留一条窄接口:提炼一段共享的预测意图,让视频生成模型和动作专家读同一份,而不改写彼此。
做法是把一组可学习的意图令牌插进视觉-语言模型序列,形成这段紧凑的意图表示,同时条件化视频生成模型和动作专家(AE)。视频生成模型原本吃文本提示,现在只替换这一路的条件,其预训练生成机制保持不变;推理时它仍保留在线,只对当前帧做一次前向并缓存各层键值特征供 AE 单向读取,未来视频去噪默认不做。训练分两段:先冻结视频生成模型,用预测未来画面的损失塑造意图表示;再固定意图,适配视频生成模型与 AE。骨架为 Qwen3.5-4B 与 Wan2.2-5B。
收益集中在分布外泛化:RoboTwin 2.0 的 Hard 成功率 15.5%,Fast-WAM 为 1.8%、StarVLA 为 3.2%;LIBERO-Plus 上 79.5%,两者为 51.5% 和 75.0%。真机五个双臂任务域内 68%、域外 24%,域外高于 Motus 的 9%,但低于 π0.5(Physical Intelligence 的视觉-语言-动作模型)的 35%。消融中把意图表示换回原文本提示,RoboTwin 从 68.6%/15.5% 降到 62.4%/11.1%。单张 A100 上生成 32 步动作块,PINT 331 毫秒、Fast-WAM 266 毫秒、PINT-VA 776 毫秒。
这些数字均为作者自评:多数基线转引自各自论文或公开榜单,并非统一口径复现;真机一栏的 π0.5 与 Motus 由作者用官方预训练权重、在同一批 700 条真机演示上微调后再评。论文也承认评测只覆盖操作任务与唯一一组骨干组合,与具身预训练结合、扩大训练规模仍属未来工作。
对做机器人本体软件的工程师,可直接借鉴的是接口层面的三点:把跨模块共享信息压成一段紧凑的意图表示;只替换视频生成模型的条件入口、保留其预训练生成机制;以及“先冻结生成模型塑造意图、再固定意图适配专家”的两段式分工。推理期不做未来视频去噪、只跑一次当前帧前向,使延迟与同规模 Fast-WAM 接近(331 毫秒对 266 毫秒),本体实时性压力可控。
结果均为作者自评,本次材料未包含第三方对 PINT 的独立复现;多数基线数字转引自各自论文或公开榜单,未做统一口径复现(真机一栏的 π0.5 与 Motus 是作者在同一批 700 条演示上微调后测得);评测只覆盖操作任务与唯一一组视觉-语言模型/视频生成模型骨干组合,未与具身预训练结合,也未验证更大规模训练。
 2026-10-23 · arXiv · 作者论文ArtifactArena:用模型在物理世界里造出来的东西来评价模型
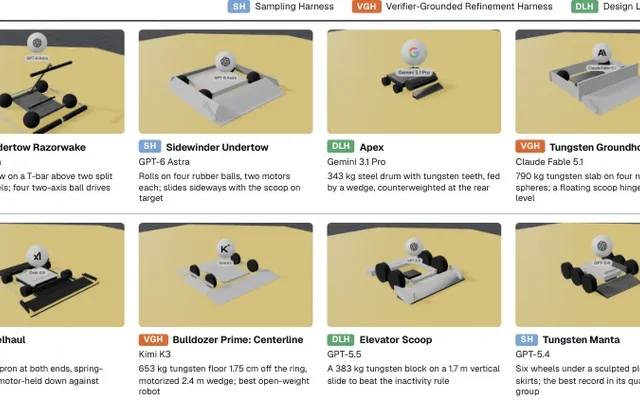
作者认为题库型基准已接近饱和,于是改用"模型造出来的东西"作为评测对象。具体任务很直接:每个模型用同一份固定提示词,交出一台完整机器人——硬件写成 MJCF XML(MuJoCo 的机器人结构描述格式),控制器写成 Python——再到 MuJoCo 仿真里推台互搏。胜负由产物的物理接触判定,而非人工偏好或大模型打分;模型必须同时处理几何、材料、质量分布、执行器与反馈控制。
三条生成路线分别是:采样套件(SH)无反馈产出 10 个产物;验证器引导的精炼套件(VGH)把模型当优化器迭代 10 轮,每轮读校验反馈与比赛回放再改设计;设计实验室套件(DLH)给它含模拟器与校验器源码、可跑 Shell 和 Python 的沙箱工作区,预算 10 次 API 调用。
结果有反直觉之处:VGH 在 21 个模型中的 15 个上拿到最高 Elo,GPT-6 Astra(1539)、Claude Fable 5.1(1310)、Gemini 3.8 Flash(1223)居前三;GPT-6 Astra 用完全不给反馈的 SH 也拿到 1352 Elo;自主权最大的 DLH 在同样预算下对多数模型落后于 VGH,前七名一件没有,三个模型没有冠军。产物也像工程代码:精炼运行中 63% 的控制器是多模式状态机,代码 71 到 1700 行不等。作者还发布了模拟器、套件和锦标赛基础设施,接受社区提交。
对做机器人本体软件的人,这是一条"模型造机器人 → 仿真对战 → 排名"的完整回路:模型交出的不是一段说明,而是一份能编译的 MJCF 结构和一段能运行的 Python 控制器,胜负由两台机器人的物理接触算出来,所以改外形、配重或策略会直接改写战绩,这与本体软件里做形态—控制取舍时的反馈回路是对应的,只不过这里的裁判是仿真物理。DLH 那种把模拟器源码、校验器和 shell 一起丢进沙箱让模型自己跑的做法,也对应大家熟悉的"跑仿真回归、让代理改控制器"的用法。评测与选型的人则可以把它当成问答榜单之外的一类观察点,但要注意分数只在 MuJoCo 这一套规则和对手集合里成立。产物与成绩全部出自论文作者自建的仿真竞技场,本文材料中没有第三方复现,应先按作者自报结果看待。
全部结论来自 MuJoCo 仿真,作者自己写明"在这里造出机器人并不意味着它在真实世界能用",因此榜单只应读作仿真中的竞争性物理设计与控制能力,不能当作真机能力;作者预期只有当仿真更接近现实时,同一套场地与套件才可能原样搬到实物对战。Elo 是用 Bradley-Terry 模型换算到 Elo 尺度的相对分,只在这一套规则、材质与对手集合下有意义;榜单持续接受社区提交,论文中的数值只是发表时的快照。模型名称按论文表格原样引用;文中数字均为作者在同一套仿真与提示词条件下自报,未经第三方复现。
做机器人本体软件的人绕不开的问题是:Hugging Face(数据托管平台)上带 LeRobot 标签的开放数据集里,究竟有多少真能拿来训练真机?LeRobot 是该平台的开源机器人学习项目,可录制演示并分享。2026 年 10 月 23 日,LeRobot 团队账号之外有 81,881 个数据集带该标签。
这份单作者普查从标签池均匀随机抽了 400 个,按自定门槛筛选:至少 10 条演示片段(episode,一段完整演示记录),再加名称不标记测试或评估、至少有一个相机、名称不标记仿真三条。389 个能读到说明卡(dataset card)的数据集中,57% 片段数不超过 10,中位数为 10;过滤并阅读说明卡后剩 148 个,占可读的 38%(95% 置信区间 33%—43%),9 个的仿真属性未判定;门槛设为 5 条时占 42%,设为 20 条时降到 30%。
可用数据高度集中:三个是大型学术数据集的重复上传,合计占可用组 95% 的片段;其余 145 个中位数为 48 条片段,61% 采自低成本 SO-100/SO-101 机械臂,最大的 10 个占 68% 的片段。作者认为多数上传不是太小、就是测试或评估、或属仿真,可用的部分由单一机械臂形态主导。
开发者可据此给公开数据集分级:按片段数、是否标注仿真、是否只覆盖同一类本体,而不是按平台标签总量估算储备。普查本身未训练或评测任何策略。
它给出一把可复用的筛子:判断一个公开机器人数据集能否用于真机训练时,先看演示片段数量、是否标注为仿真或评估、是否只覆盖同一类机械臂本体,而不是看平台上挂了多少标签。
本次只取到该 Zenodo 记录的摘要与著录页,页面列出的正文 PDF 未下载阅读,因此全部数字均为作者自述,未经独立复核;记录按滚动版本抓取,记录详情给出的 DOI 与本条目标识所用 DOI 不一致,页面为获取时快照,其日期不能证明全部文字在报告截止前已存在。结论基于 2026 年 10 月 23 日标签池中 400 个随机样本,仅 389 个能读到说明卡;片段门槛由作者自定,可用比例随门槛在 30%—42% 间移动;9 个数据集的仿真属性未能判定;普查未训练或评测任何策略,不足以支持"这些数据能训出可用策略"的结论。
 2026-10-03 · arXiv · 作者论文ResCue:用于语言条件模仿学习的残差空间提示
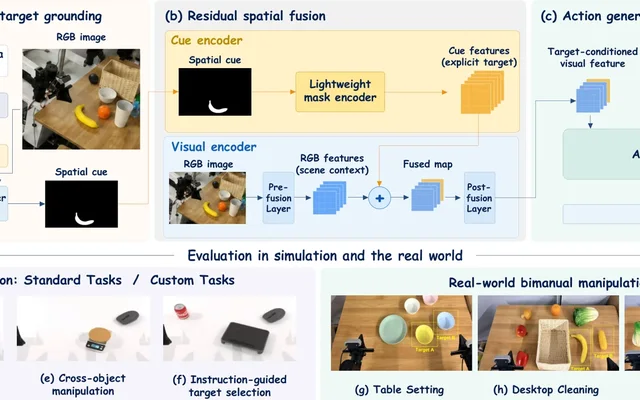
视觉模仿策略既要识别操作相关区域,也要在多个候选物体中选中语言指定目标。作者提出ResCue,将语言目标转为掩码,以显式空间提示连接目标定位与动作学习,同时保留RGB场景信息。
其关键是独立编码掩码并进行空间残差融合:语言解析器提取目标描述,SAM 3生成掩码;提示特征在后续视觉处理及池化之前,与RGB空间特征逐位置相加。作者以扩散策略(DP)实现该方法,定位模型保持冻结,训练和评测均使用预测掩码。
作者报告,15项仿真任务的平均成功率为56.5%,DP和π₀分别为33.1%和40.7%;三项真机双臂任务为60.0%,π₀为31.7%。相同掩码的消融中,残差融合优于像素叠加、输入拼接和池化后融合;测试时换成错误目标掩码,成功率降至24.6%。这些比较限定于论文协议:基线使用相同任务数据、按官方方案微调,仿真每任务评测100回合,真机20次;各任务单独训练策略,自定义仿真评测仍使用训练物体。
作者的受控消融支持:除了获得目标掩码,掩码与RGB特征的融合位置和方式也影响操作成功率,为连接预训练目标定位与动作学习提供了一种接口。
实验仅验证DP,不能据此外推跨策略架构的有效性或通用操作能力。作者报告透明、强反光及严重遮挡物体的掩码不稳定,SAM 3推理延迟也限制动态场景中的快速响应。
 2026-10-21 · arXiv · 作者论文GeoMem-VLA:把三维场景理解内化为时序记忆的视觉-语言-动作模型
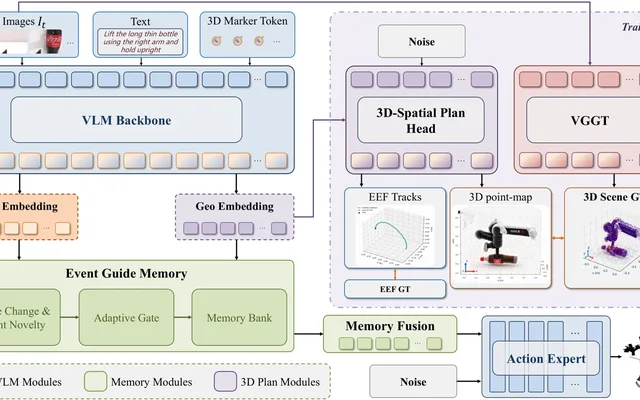
多数视觉-语言-动作模型(VLA,把图像与语言指令转成机器人动作的模型)只看当前一帧的 2D 图像,单独推断出的几何信息用完即弃,没有沉淀成可累积的任务表示。GeoMem-VLA 的判断是:动作生成需要一份紧凑、与任务相关、能持续更新的几何抽象,而不是每步都给出完整 3D 重建。
做法是把显式 3D 监督“内化”成少量可学习的几何 token(GeoPlan)。训练时冻结的几何基础模型 VGGT 提供当前场景点图目标、演示轨迹提供未来末端执行器(机械臂末端)轨迹,二者合成几何流匹配目标来监督 token;token 与观测表示一起写进整段回合的记忆,每步检索历史并与当前观测自适应融合,相似条目被合并压缩,只留特征差异明显的状态。部署时几何教师与几何解码头从动作推理链路移除,几何只以隐向量留在策略内部,检索、融合与合并逻辑仍需自行实现。
作者自测、按基准适配后:LIBERO 四套件平均 98.9%(Long 套件 96.6%);RoboTwin 2.0 清洁/随机化 91.10%/91.24%,平均 91.17%;5 个真机任务平均 78.0%。消融显示两个模块都有贡献:去掉几何分支,LIBERO 降至 97.9%、RoboTwin 降至 89.71%;去掉时序记忆分别为 98.2% 与 90.18%。真机每任务只有 10 次独立闭环 rollout,且须完成全部流程才算成功。
给机器人本体软件工程师,可迁移的是“几何监督 + 因果时序检索 + 相似条目合并”这套记忆结构:几何在训练期由冻结教师教成 token,部署期只作为回合记忆被检索,推理链路里无需挂载 3D 模型与几何解码头,但检索、门控融合与合并逻辑仍要在策略内部实现。表中领先幅度来自训练数据与协议不一致的横向对比,只能当参考;真正指向两个模块价值的是同协议消融:LIBERO 上两项差距都不大,RoboTwin 上也只在 50 个任务中的 35 与 27 个上占优。
作者自己写明:与已发表方法的横向对比因训练数据、输入和协议不同,只是提供上下文,不构成受控排名;表 1、表 2 中各方法结果引用各自原始来源并保留其协议。消融的绝对差距在 LIBERO 上很小(去掉几何分支 Spatial 掉 1.6、Long 掉 1.4;去掉时序记忆 Long 由 96.6% 降到 94.2%),50 个 RoboTwin 任务中全模型也只在 35 与 27 个任务上占优,收益并非逐任务普遍。评测规模:LIBERO 每任务 50 次试验、RoboTwin 每任务每设置 100 次;真机每任务仅 10 次独立 rollout,必须完成全部流程才算成功、部分完成记为失败,样本很小;作者另声明真机结果不能说明面向人或无约束场景下的安全性。可复现性方面,作者只承诺代码在论文发表后公开,本次核查仅拿到 arXiv HTML 正文与表格快照,未见可直接取用的代码产物,也未做独立复现。
NVIDIA 在 Hugging Face 上线了一份可直接加载的 Cosmos3-Nano LIBERO-10 操作策略权重(评测覆盖 10 个操作任务):bf16 safetensors 格式的 EMA(指数滑动平均)权重,7 个分片、约 30 GB,可由 `cosmos-framework` 策略服务器加载。它是 Cosmos Cookbook 一项受控合成数据研究中的第二个训练种子单元。
该研究的问题是:把真实演示改写成合成数据再训练,是否优于单纯重复同一批数据。训练数据为 379 条真实 LIBERO-10 演示加 1137 条来自第 1000 次迭代的重复样本,训练从第 1000 步续训到第 2000 步(全局批 2048,种子 43)。
厂商自测:标准场景成功率 93.3 ± 0.7%(10 任务 × 50 初始状态、三个评测种子;数值由训练运行自报、记录待归档);加入随机光照、纹理、天空盒与相机抖动后,扰动场景成功率 85.5 ± 2.5%,2026-10-19 在评测床上测得。
限制:对照 R(seed 43) 没做第 2000 步的扰动场景评测,该单元暂不能单独说明“改写优于重复”;模型卡要求比较时配各自的重复对照,并提示 2.5 个百分点内的差异落在种子波动内。训练数据不随权重分发,原始 LIBERO-10 见 nvidia/LIBERO_LeRobot_v3,改写集需自行生成。
这次变更是把“用生成模型改写演示数据”的收益评估,做成了可下载、可对照的公开权重:机器人本体软件工程师可直接加载这条 LIBERO-10(10 任务的操作基准)策略,在同一批初始状态上比较标准与扰动场景的成功率,并按模型卡要求配上重复样本对照,判断自己的数据流程里是否值得引入合成数据。复现成本也被写明:数据不随权重分发。该权重作为 nvidia/Cosmos3-Nano 的衍生物,按 NVIDIA 开放模型许可证发布。
两个成功率均为 NVIDIA 自报,材料中无独立复现;标准场景数值的运行记录待归档,对照组 R(seed 43) 未在第 2000 步做扰动场景评测,因此不能从这一单元读出“改写优于重复”的结论。结果只覆盖 LIBERO-10 的 10 个任务,材料中没有真机或其他基准的数据,不能外推。该模型卡是会滚动更新的页面,本条记录的时间戳来自页面末次修改而非这些数字的首次出现时间,首发日期不能证明所有文字在报告截止前已存在。
机器人能否不在控制环中调用模型,而以代码完成决策?作者提出纯代码即策略(COAP):将机器人与环境状态视为图灵机的纸带,将策略视为规则,以显式状态变量驱动动作,而非在执行时调用VLM或VLA。
方法由代码从相机图像和本体感知中测量、维护状态;感知使用NumPy、OpenCV及已知物体几何。任务程序调用共享库,同一程序跨回合运行,执行时冻结。编码智能体离线检查失败记录、提出代码修改,并在验证布局上筛选改进,形成离线改代码、在线跑代码的闭环,而非机器人运行时自行改写策略。
作者报告,在RoboDojo的42项双臂任务上,COAP整体成功率为70.24%;每项任务使用三个种子、每个种子50种布局,测试时不使用深度、分割输入或模型服务。结果全部来自仿真,感知依赖基准公开的相机参数、机器人网格和物体尺寸;新任务仍需离线开发,能力上限取决于状态表示准确性与代码逻辑稳健性,不能据此推出真机或通用操作能力。
这项作者研究将策略改进落实为显式状态、可检查代码与离线验证的迭代,为机器人递归自我改进提供了一条软件化研究路线。
证据为作者论文中的仿真实验,不是独立复现。依赖基准公开配置与资产,每个新任务都有开发成本;不将其结果外推为真机或通用能力。
 2026-10-09 · arXiv · 作者论文ARC:面向机器人基础模型的推理配方
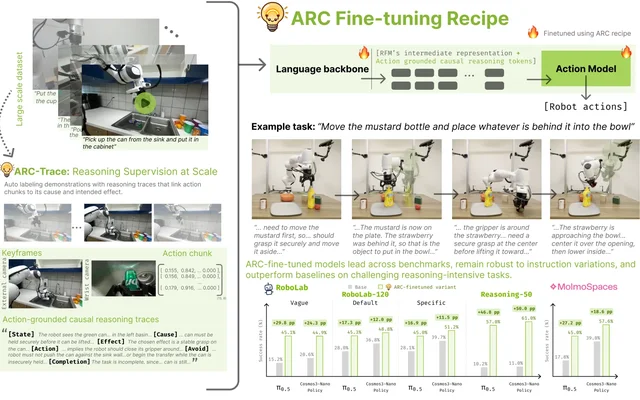
机器人基础模型(RFM,靠大规模真机示教训练出的通用操作策略)要再提性能,通常只能换更大模型、加更多示教数据、再做一轮基础规模训练。这篇论文给出互补路径:不改架构、不重做基础预训练、不新采大规模机器人数据,只加一层以动作为落点的因果推理轨迹。对做本体软件的工程师,改动集中在三处:重标注脚本、轨迹注入接口、运行时轨迹生成服务。
方法分三层:推理内容是固定七字段的轨迹(现状、原因、推论、期望效果、动作、禁忌、进度);监督来源是 Gemini 2.5 Pro 解读示教视频选帧、GPT-5.5 生成状态检查并合成轨迹,把 DROID 重标为 ARC-Trace-DROID,覆盖约 74,740 条示教、约 1.2 百万个标注帧;接入方式是视觉-语言-动作模型(VLA,直接输出动作的策略)π0.5 用两层编码器把轨迹转成 token 追加到图像-指令上下文,推理时策略冻结,轨迹由外部视觉语言模型(VLM)按相机画面异步生成。
结果均为作者自报:RoboLab-120 默认指令下 Cosmos3-Nano+ARC 成功率 48.8%(+12.0 个百分点)、π0.5+ARC 45.3%(+17.3);推理专项基准 RoboLab-Reasoning-50 上 π0.5+ARC 57.0%(+46.8)、Cosmos3-Nano+ARC 61.0%(+50.0),给 π0.5 加显式子任务的对照为 21.0%;真机配对评测 π0.5+ARC 91.7%,比原策略高 82.2 个百分点。限制:只用 DROID 一种本体,轨迹依赖外部 VLM 质量,RoboLab-Reasoning-50 为本文自建的 50 任务基准;本次材料只有作者论文,未见独立复现。
对机器人本体软件工程师,这是一条不靠堆数据的改造路径:不重新采数据、不重训基础模型,用自动生成的因果轨迹改造已有策略,改动点是标注脚本、轨迹注入接口和运行时的一个轨迹生成服务。
实验只覆盖 DROID 一种本体;推理轨迹由外部多模态模型在运行时产出,依赖其质量;RoboLab-Reasoning-50 是作者自建基准。数字均为作者论文自报,本次材料未见独立复现。
 2026-10-03 · arXiv · 作者论文学习用于稳健动态机器人行走的低频运动控制
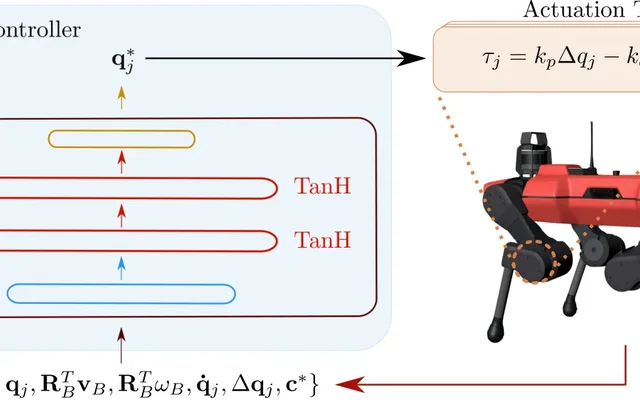
提高控制频率是否必然带来更稳健、反应更快的机器人行走?这篇作者论文以ANYmal C四足机器人检验低频控制,比较训练和执行频率为5—200 Hz的深度强化学习策略,而非跨平台排名。
方法采用运动控制器与底层执行跟踪器分层:策略根据机器人状态生成目标关节位置,底层跟踪器负责生成关节力矩;各策略使用PPO训练。低频策略对执行动态不敏感的解释有明确条件:执行器稳定时间短于控制步长,且底层能够稳定跟踪目标。
作者在真机定性评估中报告,8 Hz盲行策略实现约1.5 m/s前向速度;另一个8 Hz感知策略可跨越木制铁路枕木并上下台阶。论文还报告,低频策略对执行延迟更稳健,并展示无需动力学随机化或执行器建模的仿真到真机迁移。
结果不意味着频率越低越好:5 Hz策略只能稳定执行低速运动,反应不足;未使用执行器网络训练的策略虽可迁移,但动作不如使用该网络时平滑。作者称提供训练与部署代码,材料未构成独立复现证据。
该研究为学习式运动控制提供一种设计参照:在底层稳定跟踪的条件下,可以考察降低策略更新频率,而非默认追求高频。
证据来自作者论文中的仿真评估与ANYmal C真机演示,不宜外推为其他本体上的普遍优势;代码提供情况仅按论文陈述,未核验工程产物或独立复现。
把瓶子直立放到盘上、用海绵擦桌时,机器人需要保留任务要求,而非照搬视频轨迹。生成视频恢复出的动作通常只对应一个场景。作者提出V2-STRep,将其转成可复用的结构化任务表示,让已获取的技能适应新场景和兼容指令,无需重新生成视频。
系统用视觉语言模型(VLM)识别动作阶段、参照对象和姿态约束,再用彩色与深度图像(RGB-D)把二维线索还原成三维目标几何与候选抓取姿态。规划时联合选择抓取与完整轨迹:例如放瓶子时保持直立,但允许绕瓶身轴旋转,为满足关节限制留出余地。
作者在Panda机械臂上测试六项操作任务。基线比较共享生成视频,并统一提供可行抓取配置、跳过抓取生成与选择;V2-STRep成功25/30次,NovaFlow和Dream2Flow分别为12/30和8/30。另一组跨场景测试启用自身抓取流程,成功29/30次,但前提是源技能已成功获取,不能视为端到端成功率。更改指令后的复用仅有三个定性案例,且要求兼容原有目标几何类型和动作阶段结构。
对机器人软件开发者,其参考价值是把必须保持的任务约束与可供规划调整的运动自由度分开表达,而不是要求机器人逐帧追随全部视频姿态。
证据为作者论文实验,不能视为独立复现。跨场景结果以源技能获取成功为前提;深度误差仍可导致抓取失败,指令复用仅作定性评估。
 2026-10-02 · arXiv · 作者论文面向安全人形机器人全身跟踪的滤波器感知微调(CoFiT)
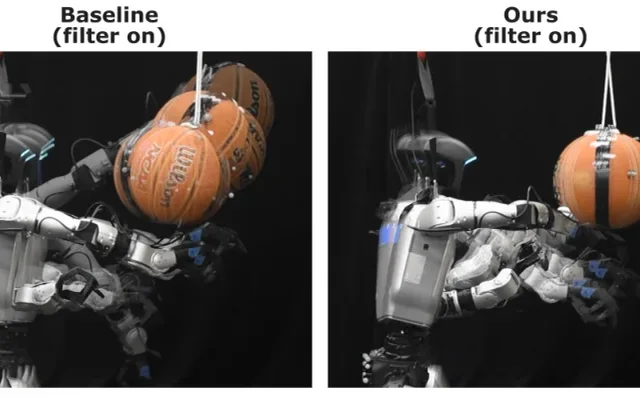
动作捕捉或动作生成器给出参考轨迹,强化学习(RL)跟踪策略转成关节指令;运行时安全滤波器(如控制屏障函数 CBF,把安全约束写成对控制输入的不等式)修正跟踪器输出,应对训练时没有出现的障碍。这两层常被当成可独立设计的组件:滤波改变了实际执行的动作和状态分布,而跟踪策略是在无滤波闭环下训练的。
作者把接口不匹配拆成三类:动力学不匹配、目标不匹配(手留在障碍外会产生跟踪误差,反而鼓励策略继续前伸)、信息不匹配(约束生效前策略看不到约束)。据此提出 CoFiT(约束滤波感知微调):在滤波器全程开启的状态下微调预训练跟踪器,输入动作空间的约束信息与修正历史反馈,并加入修正量、原始条件违反、松弛量三项惩罚。
仿真中相对只做滤波微调的基线,违规时间在 TWIST2 上降 91%、SONIC 上降 21%。真机上用 Unitree G1 做伸手够篮球的受限任务(滤波器 50 Hz 运行),TWIST2 上违规时间相对继续无滤波训练降低 83%;基线十次里有五次需要操作员急停,CoFiT 十次全部无急停完成。
代价是精度:换用 SONIC 跟踪器后,违规时间只从 7.64% 降到 5.24%,世界坐标跟踪误差却从 5.45 cm 升到 12.17 cm。
对做机器人本体控制软件的工程师,这是一条"只改跟踪器、不改滤波器"的改造路径:现有安全滤波器继续承担训练后才出现的约束,跟踪策略通过一次带滤波器的微调学会主动少让滤波器动手,真机上把需要急停的次数从五次降为零次、违规时间降低 83%;代价是跟踪精度下降,需按场景取舍。
论文明确不提供无条件安全保证(零阶保持、模型不确定性与二次规划松弛仍可能在执行中造成违规),范围也限定为局部干扰,不涉及让跟踪器绕开完全阻挡的障碍重新规划;真机每个条件只有十次重复,其中 SONIC-CoFiT 有一次日志失效被排除在连续指标统计外。证据范围限于该 arXiv v1 全文快照,摘要页与引用目录属可滚动更新页,后续修订可能改动结论。
 2026-10-05 · arXiv · 作者论文FLEX-WAM:面向长时程想象与规划的灵活块因果世界—动作模型
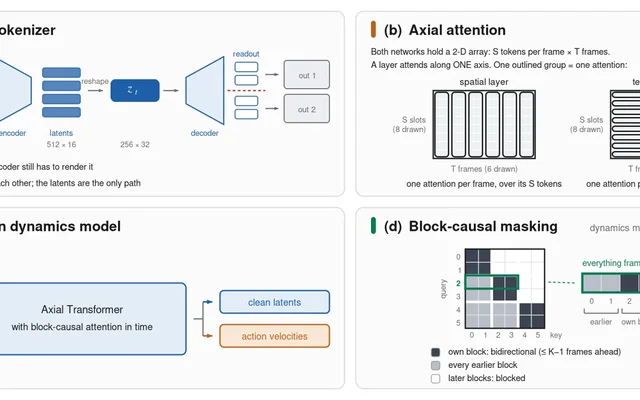
作者指出,联合视频—动作模型常采用计算较重的固定时域骨干,难以兼顾流式推理与稳定的长时程开环生成;联合训练还可能产生看似合理、却对动作响应较弱的未来。论文提出FLEX-WAM,统一动作生成与动作后果预测。
其块因果注意力在块内双向交互、跨块保持因果性,结合轴向注意力、KV缓存和分块扩散强制,无需重训即可在部署时调整延迟与吞吐量。训练先学习纯世界模型,再转向联合训练;通过平衡状态与动作损失的梯度,并以前向动力学弹性反馈调节世界模型模式采样,维护动作响应性。
作者展示了1024步联合状态—动作生成样例,所示轨迹保持视觉连贯。模型在蒙特卡洛树搜索中同时提出动作并模拟结果;OGBench视觉谜题4×4五项任务合计成功率为80%,但成功仅指想象终态达标,并非真实执行成功率。OpenArm初步部署利用预测与实际观测的差异识别纠错样本;利用这些样本持续改进仍属后续工作。上述结果来自作者论文,不应视为独立复现或通用能力证明。
该作者论文展示了由同一模型提供动作提案与想象结果的规划路径,并将动作响应性作为联合训练中需要主动维护的能力。
1024步结果是所示样例的视觉连贯性证据,不能替代长期物理准确性验证;想象计划的真实执行及利用失配样本持续改进仍属未来工作。论文注明代码与检查点因匿名评审暂未提供,将在接收后发布,不能据此认定工程已经开放。本次材料未提供独立研究复现证据。
自动驾驶策略要做闭环验证,需要一个“策略动作会改变下一帧画面”、还能同步给出多路相机与激光雷达的仿真环境。NVIDIA 在 Hugging Face 发布的 Cosmos3-Nano-Sim-Auto 官方定位是实时闭环驾驶仿真器:以文字提示加 WSM(World Scenario Map,世界场景图)控制为条件,生成时空同步的多视角相机视频与激光雷达观测;WSM 控制由渲染器把策略的规划轨迹或人工方向盘输入转换而来。
模型由 Cosmos3-Nano 两阶段得到:先用含激光雷达的多传感器驾驶数据后训练成 Transfer-Auto,再做因果蒸馏成少步模型,以小块潜帧逐块生成,靠缓存历史维持跨块的时间上下文,使后续观测反映更新后的驾驶输入;相机与激光雷达联合生成。可训练参数 16B,最多支持 11 路标准与鱼眼相机,激光雷达与相机对齐并转成 3D 点云;实测激光雷达条件下只支持一次初始扫描。
厂商自报的多视角 RGB 评测(720p、7 路相机、297 帧、4 步去噪、guidance 1;对照基线用 guidance 3 且提示词不同)中,文本生视频设定下帧级 FID(Fréchet Inception Distance,比较生成与参考的帧特征分布)为 48.6,FVD(Fréchet Video Distance,比较视频特征分布)I3D 为 480、StyleGAN-V 为 479,优于对照的 61.9、772、770;但 DOVER 视频技术质量 7.30 低于对照的 8.56。
吞吐数字基于 vLLM-Omni、4 步去噪且不带 CFG、生成 201 帧:不含激光雷达时 GB200 上 1 路 720p 为 10 fps、7 路 720p 为 1.3 fps、11 路 720p 为 0.74 fps,H20 上 11 路 720p 仅 0.1 fps;含激光雷达时 GB200 7 路 720p 为 1.1 fps、11 路 720p 为 0.65 fps。按这组自报数字,“实时”只在低路数、低分辨率下接近。
对自动驾驶与机器人软件开发者,这次的关键变化是闭环输入直接来自策略自身的规划轨迹,且相机与激光雷达是联合生成的(官方称用于支撑空间与时间一致性),因此多传感器感知栈与驾驶策略能在同一次 rollout(一次连续生成)里一起评估,而不是先出图再补点云。官方给出的推理硬件是 GB200、H100、H20 这类数据中心级 GPU,模型卡未提及嵌入式或车端部署,因此按现有公开信息,它更适合放在数据中心侧跑仿真生成数据,而不是直接装进机器人本体。
评测与吞吐数字全部出自 NVIDIA 官方模型卡自报,本次材料中没有任何独立第三方的复现实验;对照基线使用不同提示词与不同 guidance scale,比较口径不完全对齐,且 DOVER 一项反低于基线。多路高分辨率吞吐距实时仍远(H20 上 11 路 720p 仅 0.1 fps;H100 在 11 路 720p 无激光雷达一格标为 "-",按模型卡说明 "-" 表示不支持而非缺测数值),含激光雷达时吞吐进一步下降。实测激光雷达条件只支持一次初始扫描,多 GPU 优化官方称仍在进行中。材料为获取时的模型卡页面快照,其标注的首发日期不保证全部文字在报告截止前已存在。
 2026-10-17 · arXiv · 作者论文SocialCoAct:为基于视觉语言模型的人形机器人提供并评测第一视角社交协同行为
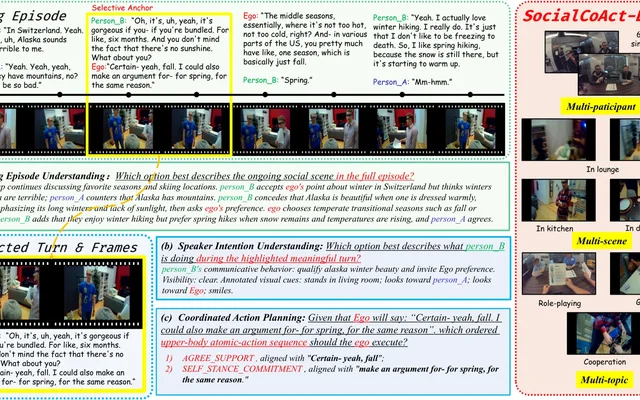
让机器人参与多人社交,说的话和身体动作要在语义上对齐;现有做法多把预生成语音直接映射成连续动作轨迹,既缺乏对复杂社交环境的感知,也没有显式的高层语义动作规划。SocialCoAct 把第一视角(egocentric,机器人自身摄像头视角)社交协同行为定义成端到端的智能体任务:其 SocialCoAct-Agent 每轮把第一视角观测与对话历史交给视觉语言模型(VLM,能看图也能读文本的模型),输出语言回应以及与话语片段对齐的原子动作序列;模型输出的关节量不直接执行,先过白名单校验再映射为关节轨迹。
配套基准 SocialCoAct-Bench 取自 EasyCom、EgoCom 两个公开第一视角数据集,含 423 道人工校验的四选一题,分为长片段理解(LEU)、说话者意图理解(SIU)、协同动作规划(CAP),难度为易 189、中 148、难 86。
评测上,Claude-Sonnet-5 与 Qwen3.8-Max 总分并列最高 77.54%,难子集最高仅 46.51%。开启扩展思考(先长推理再作答)后,Qwen3-VL-2B 从 39.48% 升至 59.10%、Qwen3-VL-4B 从 56.03% 升至 73.05%,代价是吞吐由 1.60 与 1.51 降到 0.030 与 0.075 样本/秒,慢约 53.6 倍与 20.2 倍。加视觉帧在 CAP 上并不可靠:EgoMind-7B 涨 8.79 个百分点,InternVL2.5-2B 反而降 4.18 个百分点。
部署侧用两块 RTX 5090 跑 Whisper-Tiny、Qwen3-VL-8B、Qwen3-TTS 与 Unitree G1,十次试验均产出语言回应和可执行手势,仿真端到端时延中位数 12.63 秒,真机处理时延 7.57 秒。
对机器人本体软件开发者而言,这套做法把“话语—动作”的对应关系落到一组可枚举、可校验的原子动作上:模型只负责挑动作并指明它对应哪句话,关节轨迹由白名单映射生成,下半身固定在站立姿态,因此手势可以作为中间层接口来调试、替换和审计,而不必直接消费模型输出的关节量。基准侧的两点结论也可直接用于工程决策:扩展推理能提分但吞吐下降数十倍,加视觉帧在不同模型上未必更好——这两点决定了在线社交代理的延迟预算与模型选型。
全部数字出自作者自建基准与自测,本次材料未见第三方复现;代码与基准只是“发表后公开”的作者声明,尚无可获取产物。基准仅 423 题、只来自 EasyCom 与 EgoCom 两个数据集,协同动作规划的选项由 23 类原子动作经三人多数票标注给出;真机侧只跑十次,7.57 秒时延不含相机传输、机器人通信与物理执行。本文依据 arXiv v1 全文 HTML 快照撰写(抓取时间见来源元数据),未做跨版本或跨目录核对。


该工作展示了以单目标候选生成和多目标协调分解投掷规划的路径;执行更快与在线响应更快取决于不同搜索策略,并非同一配置同时取得。
实机证据限于双物体任务,未显示命中率提升;当前手的工作空间与释放干扰限制了更多物体的实机扩展,无障碍和简化飞行模型也限定了结果适用范围。