条件轨迹峰:面向动作块的单次前向多模态策略
同一机器人观测可能对应多条可行轨迹,但并行预测多个候选仍可能出现模式坍缩,重规划时也可能切换到不兼容的行为。作者提出条件轨迹峰(CTP),尝试同时解决行为多样性与跨动作块的一致性问题。
展开阅读 具身图谱在图谱中把握具身智能
本周所选进展聚焦历史利用、动作块连续性与推理成本:长上下文需要与对应时延一起衡量,单次前向生成仍需维持跨块行为一致,任务状态条件则为反应式策略补充阶段信息。三条路径各有收益,但训练设置、监督依赖和评测协议限定了结论范围。
同一机器人观测可能对应多条可行轨迹,但并行预测多个候选仍可能出现模式坍缩,重规划时也可能切换到不兼容的行为。作者提出条件轨迹峰(CTP),尝试同时解决行为多样性与跨动作块的一致性问题。
展开阅读人形机器人在全身运动中精确跟踪末端位姿,会受到浮动基座振荡、重力、动力学耦合及行走扰动影响。作者提出 ResGAC,将几何导纳控制与残差强化学习结合:前者根据任务空间反馈生成手臂关节位置目标,后者在同一动作空间修正手臂目标,并控制其余关节以协调行走和平衡。
展开阅读大模型生成的无人机程序即使语法正确,也可能偏离任务意图、碰撞障碍或遗漏事件触发后的行为。作者提出 AeroEval 中间件,以程序检查与执行后行为验证分阶段定位错误,而非仅凭代码可运行判断任务完成。
展开阅读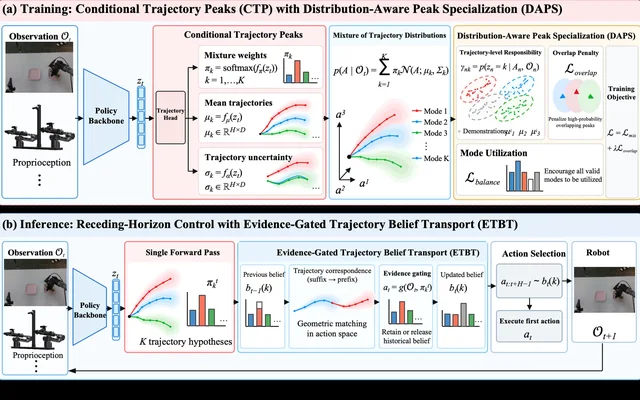 2026-10-05 · arXiv · 作者论文条件轨迹峰:面向动作块的单次前向多模态策略
同一机器人观测可能对应多条可行轨迹,但并行预测多个候选仍可能出现模式坍缩,重规划时也可能切换到不兼容的行为。作者提出条件轨迹峰(CTP),尝试同时解决行为多样性与跨动作块的一致性问题。
CTP通过一次共享网络前向传播,联合预测完整动作块候选、概率质量与尺度。训练时,DAPS以轨迹级后验责任分配和概率、尺度感知的重叠约束促进候选分工;执行时,ETBT通过几何对应传递历史行为信念,并允许当前证据较强或对应不可靠时解除历史约束。
作者报告,CTP在Push-T的覆盖得分为91.40%;冻结π₀.₅视觉语言骨干后,在LIBERO上平均成功率为97.25%。真机双盘放置任务允许任选一个盘,50次试验全部成功,左右两种放置模式均被保留。
在作者的本地LIBERO对照中,CTP与π₀.₅均预测50步、执行10步;完整策略调用平均延迟从218.24毫秒降至75.80毫秒,计时包含视觉语言骨干、数据处理与信念解码。其他论文的成功率并非严格同协议结果,不据此作跨模型排名。
人形机器人在全身运动中精确跟踪末端位姿,会受到浮动基座振荡、重力、动力学耦合及行走扰动影响。作者提出 ResGAC,将几何导纳控制与残差强化学习结合:前者根据任务空间反馈生成手臂关节位置目标,后者在同一动作空间修正手臂目标,并控制其余关节以协调行走和平衡。
方法利用左不变几何形式,在不同操作参考系间沿用同一控制律;引入地面附着航向参考系,保留平面运动,避免骨盆横滚、俯仰和升沉经参考变换传入末端目标。但经全身动力学传递的物理扰动仍需学习控制器补偿。
作者在宇树 G1 真机上测试。站立定点跟踪的位置与姿态平均误差为 6.5 毫米、1.37°,定点结果只统计稳态样本。站立插孔实验中,ResGAC 与 SONIC-Teleop-v1.1 各测试20次,成功率分别为90%与50%;目标由 OptiTrack 估计,轴孔直径间隙为10毫米。这些结果对应指定实验条件,不代表通用精密装配能力。
该研究展示了将显式任务空间几何反馈与学习修正结合的人形全身控制路径,并区分了参考系引入的目标运动与实际动力学扰动。
证据为作者论文中的真机实验,而非独立复现。站立跟踪比较中,SONIC-Teleop-v1.1 使用航向参考系,其余控制器使用骨盆参考系,不宜视为完全同协议排名;插孔结果还受目标配准误差与标记遮挡影响,不能外推通用装配能力。
 2026-10-07 · arXiv · 作者论文AeroEval:面向 AI 生成无人机任务的分阶段程序与执行验证
大模型生成的无人机程序即使语法正确,也可能偏离任务意图、碰撞障碍或遗漏事件触发后的行为。作者提出 AeroEval 中间件,以程序检查与执行后行为验证分阶段定位错误,而非仅凭代码可运行判断任务完成。
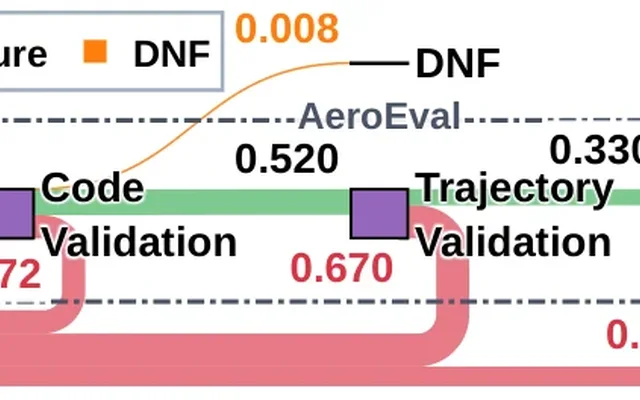
系统先结合确定性分析与上下文约束的模型智能体,检查语法、平台 API 和任务意图;通过后进入仿真,再依据轨迹、任务要求和环境信息验证行为。导航任务采用参考路径比较,无唯一参考路径的分析型任务则由智能体检查覆盖、避障和事件转换等要求。失败诊断返回生成器,供其重新生成程序。
作者报告,在 AirSim 的20项导航任务中,CLG 接入 AeroEval 后成功率由55%升至95%;在 Gazebo 的五类分析型任务、每类10次独立运行中,使用 o3-mini、最多15次迭代的流程,相较单次生成 AeroGen,运行级成功率由34%升至88%。另在最多三次重新生成的独立消融实验中,仅代码验证、仅轨迹验证和完整流程分别达到44%、56%和88%。这些指标反映预算内获得验证通过程序的情况,不等于形式化安全保证。
作者实验支持程序检查与执行证据的互补价值:前者排查结构、接口和意图错误,后者识别与轨迹及环境交互有关的行为违规。
结果属于作者论文评估,并非独立复现。轨迹验证器在15个专家标注案例中有三次误接受;真机仅覆盖一款平台、三类任务各一次,不能据此推断通用仿真到现实迁移或安全性。
 2026-10-06 · arXiv · 作者论文H-JEPA:面向视觉规划的分层世界模型端到端学习
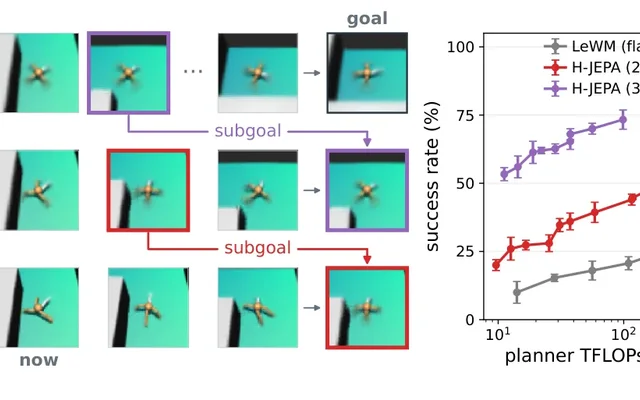
作者提出H-JEPA,将动作条件JEPA端到端训练为层级:各层在自身潜空间预测未来,高层时间步幅更粗;不使用奖励或重建目标。规划自顶向下展开,上层预测轨迹为下层提供子目标,底层输出原始动作。
作者在四个模拟导航与操作环境中,与单层LeWM基线比较。Visual AntMaze上,三层模型将成功率从18%提高至73%,同时减少规划计算量。深度比较先在平均每回合100规划TFLOPs以下选择配置,再在独立的50任务集评估,报告三个配对模型与规划器种子的均值和标准误。作者消融将收益归因于时间分解和高层目标表征。
收益不随层数稳定增加:Push-T三层模型即使在最大计算量下也表现不佳,作者推测与短回合限制训练数据有关。加入逆动力学监督后,作者在DROID真实机器人视频上报告以更少规划计算量改善离线规划保真度;该部分仅对照已记录专家轨迹评分,不是在线真机执行验证。不同深度的训练计算量未配平,选择性抽象也并非在所有环境出现。
这项作者研究提示,层级结构可能通过时间分解及高层目标距离表征两条途径帮助规划;不能将收益仅归于其中一种机制。
不同深度的优化步数与训练FLOPs未配平;选择性抽象并非在所有环境出现。DROID结果仅支持离线轨迹评估,不能据此外推在线真机或通用操作能力。本文证据身份为作者论文,不作为独立复现结论。
 2026-10-10 · arXiv · 作者论文LifelongCrossNav:用于跨楼层多目标导航的持久三维语义记忆
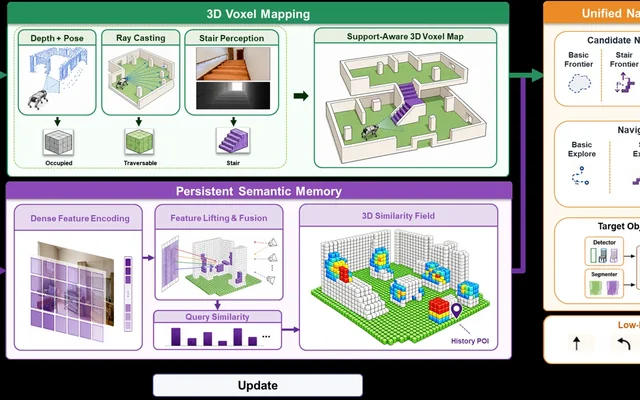
多目标导航的记忆复用与跨楼层通行往往被分开处理。作者提出LifelongCrossNav,面向未知多层室内环境中的顺序物体目标导航:智能体只接收当前目标,完成后才获知下一个。
方法以共享稀疏三维语义体素记忆保存几何、可通行状态和视觉语言特征,切换目标时重新查询,无需重建地图;结合支撑感知建图、楼梯感知与方向感知穿越,由统一策略协调同层探索、历史及实时兴趣点检索和目标接近。
作者构建HM3D-MFMON,包含36个场景、927个三目标回合,其中288个要求至少一次跨层。在该基准上,完整方法的序列SR为36.57,OneMap为16.83;必需跨层子集分别为12.50和0.00。移除跨目标记忆后,整体SPL由12.38降至11.46。
这些结果来自作者实验:每回合三个目标共享1500次动作预算,采用事后分阶段最短路径评测;OneMap是持久二维语义地图基线,并不显式支持跨楼层导航。
作者的消融结果支持跨目标几何与语义记忆复用改善后续目标的导航效率;贡献在于将可查询记忆与跨层通行统一,而非证明通用导航能力。
“终身”仅指同一环境内跨目标的记忆复用,独立回合间状态重置。楼梯规划不保证长边中间路径的连续扫掠体积碰撞认证;比较应限定于所述任务、协议和基线。
作者提出世界—动作模型ModAR,逐一去噪未来模态,以此前完成的预测为上下文,最后生成动作;无动作标签样本仅监督可用的未来目标。模型采用共享扩散Transformer与模态专属专家,按点轨迹、DINO特征、深度、RGB的顺序生成,训练时加入上下文噪声以缓解级联误差。作者实验中,点轨迹、DINO与深度平均提供互补收益,额外预测RGB无稳定增益。
RoboTwin仿真覆盖六项任务,每项固定50条带动作标签示范,在50个留出初始条件上评估。每项加入1,200条无动作示范后,ModAR平均成功率由66%升至76%,在各受测数据规模下均为受控比较方案中最高。
真机覆盖三项双臂任务,每项每种方法及数据混合测试30次。每项从100条机器人示范起,依次加入200条域内无动作人类示范、1,000条域外EgoDex示范,ModAR平均成功率由70.0%升至81.1%、83.3%。上述结果属于作者实验;任务有限且使用离散任务标签,不构成广泛泛化证据。
作者实验为先生成结构化未来、再生成动作的设计提供了支持,也表明ModAR在受测任务中可利用无动作人类示范改善表现;不据此推断通用操作能力。
实验使用离散任务标签而非语言指令,尚未建立跨任务、物体或场景的广泛泛化证据;顺序生成相较同时生成或仅生成动作增加推理延迟。仿真实现报告在每项50个留出初始条件上的最佳检查点成功率。
 2026-10-09 · arXiv · 作者论文一种用于协作机器人运动生成的物理信息碰撞学习框架
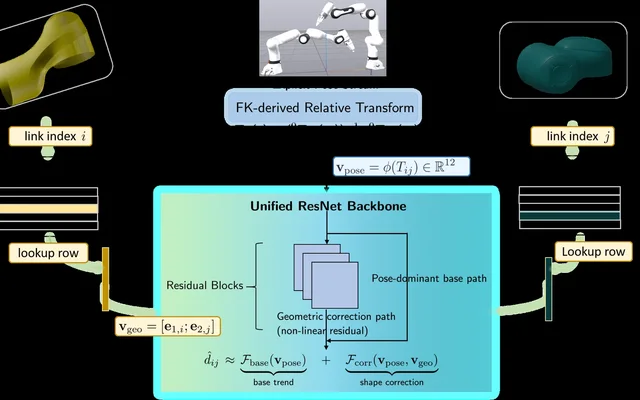
近距离双臂运动需要兼顾几何精度与可微性:传统几何检查器难以嵌入梯度式模型预测控制,保守代理几何又可能限制紧密交互。作者提出PI-UDF,直接学习机械臂之间的有符号距离。
方法以解析正向运动学、可学习连杆嵌入与共享残差网络预测连杆对距离;通过配额驱动的边界采样和非对称边界跨越惩罚,重点抑制将接触或穿透误判为安全的错误,再将距离场接入非线性模型预测控制。
在作者的固定基座双Franka静态测试中,同为50轮训练,PI-UDF与作者复现的主动数据PairwiseNet相比,漏检率为6.83%对16.47%,安全关键区域平均绝对误差为2.33对2.38厘米;同工作站训练耗时为27.8对138分钟,后者不含几何编码器预训练。
真机双臂交换记录中,模型预测与离线Drake/FCL回放的最小间距分别为6.04和7.24厘米,均高于5厘米阈值。但该阈值属于软代价,而非硬碰撞约束;结果限于所测固定布局。
为固定工作单元中的双臂规划提供可微的实体间距信号,并展示了边界监督与闭环控制结合的路径。
证据来自作者论文及其内部基线复现,不是独立研究复现。跨布局仍需相应训练;软间距代价不构成硬安全保证,求解耗时也不代表硬实时保证。
 2026-10-06 · arXiv · 作者论文HRDexDB:跨人类与多种机器人本体的4D灵巧抓取数据集
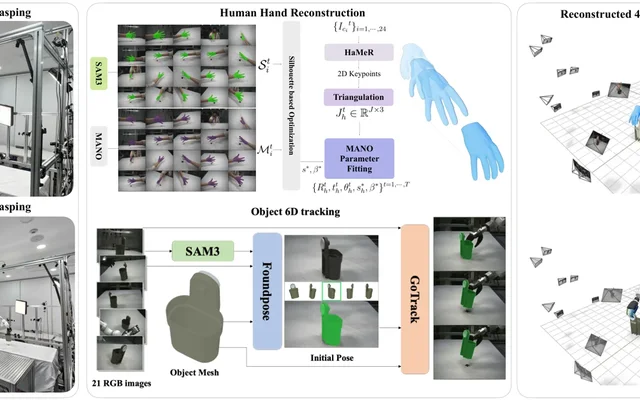
针对不同手部形态在同一物体上的抓取策略与接触模式难以统一研究的问题,作者提出真实世界数据集HRDexDB,记录随时间变化的三维手—物交互。数据覆盖100件物体、3,215次抓取试验,包括541次人类示范及四种机器人本体的2,674次执行。
采集采用人类示范引导的遥操作:操作者参考人类抓法,根据机器人形态和运动学约束调整手指配置与接触位置,而非逐帧复刻。同步多视角采集与重建提供RGB观测、手部几何、机器人状态、物体6D位姿及成功/失败标注;人机试验关联不代表逐帧时间对齐。
作者通过接触图迁移、视觉接触估计和检索辅助抓取验证用途。其中,检索方法根据局部物体几何寻找数据库抓姿,再进行对齐与接触优化。在Allegro V5上,以80件物体供检索、20件未见物体测试,相比采用相同接触优化的运动学重定向基线,仿真成功率由50/100升至73/100,真机由8/20升至15/20;成功标准为抓住并抬起物体。论文仍将数据与基准协议公开列为后续安排。
为研究共享物体上的跨本体抓取差异提供几何标注和示范—执行关联;作者实验支持将已记录机器人抓姿作为未见物体抓取的检索先验。
证据为作者论文实验,不是独立复现;检索辅助抓取的真机评测限于Allegro V5的20次试验,不能外推通用操作能力。论文中的公开承诺不等于已核实的工程开放。
 2026-10-08 · arXiv · 作者论文Long-WAM:扩展世界—动作模型的上下文
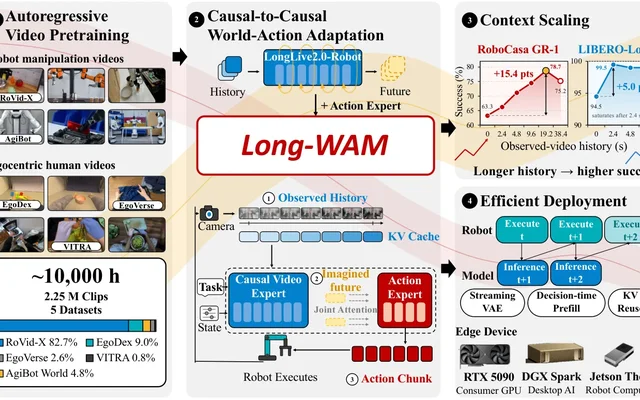
实时机器人控制需要视觉历史判断运动与任务进度,但处理历史也可能拖慢响应。作者提出Long-WAM模型—系统框架,研究如何在实时约束下利用更长上下文,强调“能访问历史”不等于“能利用历史”。
方法先用无动作标签的机器人及第一视角视频进行自回归预训练,再在动作适配中保留历史到未来的因果结构。推理采用先预测、后行动:预测未来视觉潜变量,再据历史与预测生成动作,不将未来潜变量解码为像素;部署结合流式VAE编码、异步执行与硬件优化。
作者报告,RoboCasa GR-1中,历史从0.0秒增至19.2秒,成功率由63.3%升至78.7%,双向预训练初始化则无净增益;LIBERO-Long加入2.4秒历史后,由94.5%升至99.5%。G1在3厘米/秒移动杯堆叠条件下成功19次,共20次试验,两种对照均未成功。
速度收益有条件:RTX 5090上,2.4秒历史的动作块推理耗时107.4毫秒,19.2秒历史则为341.0毫秒,不能将短上下文时延套用于长上下文结果。
作者结果支持将预测预训练、历史窗口和执行预算联合设计,而非仅扩大记忆容量;不宜据此外推通用机器人能力。
证据为作者论文,非独立复现。各历史窗口分别训练,真机上下文长度研究仍属后续工作;时延排除预处理、文本编码及控制器/进程间通信开销。GR-1的2.4秒成功率存在表文不一致。
 2026-10-10 · arXiv · 作者论文基于在线接触式几何估计的负载感知四足机器人导航
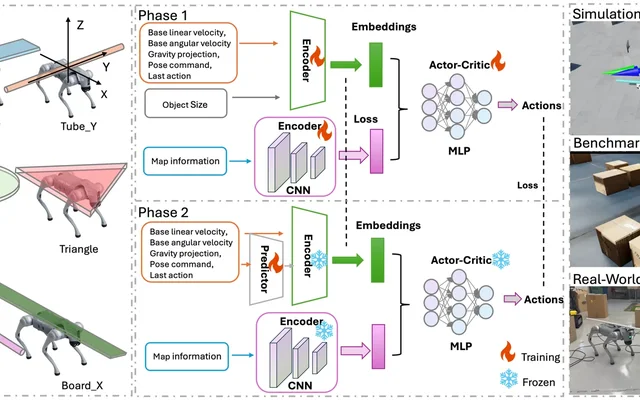
四足机器人携物穿行杂乱环境时,负载会改变可通行边界。作者指出,固定轮廓膨胀可能使导航过于保守,提出将负载几何纳入决策的两阶段学习框架,而非仅适应负载对步态稳定性的影响。
第一阶段以物体尺寸为特权信息,通过强化学习训练LOADNav,使轨迹与避障间距随负载几何变化;第二阶段冻结导航策略,以模仿学习训练CoGE。预测器通过指令速度与实际速度的偏差识别偶发接触,据此更新尺寸估计,并非主动制造碰撞。增强版CoGE-LOADNav+以循环记忆保留接触信息,缓解有限观察窗口中的遗忘。
作者在配备L1激光雷达的宇树Go2上测试横向板、纵向管和横向管三类负载,每类20次。无需预先输入负载几何的CoGE-LOADNav及增强版平均成功率分别为81.67%和90.00%,已知尺寸的LOADNav为98.33%。这些是作者真机实验结果;方法将任务定义为二维点导航,假设负载刚性固定,不能据此认定其具备任意负载或复杂地形下的通用运输能力。
将负载几何估计与导航策略连接起来,并用循环记忆保留稀疏接触信息,为未知尺寸负载的导航适配提供了研究路径。
证据为作者论文实验。负载建模采用刚性固定、动力学影响可忽略的假设;作者报告草地、沙地上的持续振荡,以及仿真与现实碰撞力分辨率差异对估计器的影响。
 2026-10-10 · arXiv · 作者论文成功但不安全:揭示视觉与语言导航中碰撞的分析性基准
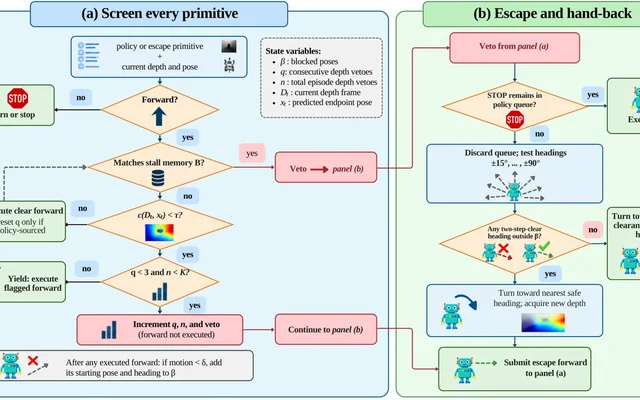
视觉与语言导航的到达率和路径指标不能说明沿途是否发生碰撞。作者提出VLN-Safe,将任务成败与接触情况联合统计,并比较滑动与阻挡两种评测机制:前者允许碰撞后沿障碍边界移动,后者拒绝越界前进。在R2R-CE的六个智能体上,滑动模式下38.5%—56.8%的成功回合包含接触;改用阻挡模式,成功率下降11.7—36.1个百分点。
作者据深度几何与运动历史设计免训练碰撞防护层,不读取策略分数、不修改权重,只拦截风险前进动作,执行脱困后交还控制权。其输入包括全景深度、里程计及控制器待执行动作队列。
作者报告,在R2R-CE阻挡模式的五个智能体上,防护层使碰撞步数减少62%—98%,成功率提高6.9—29.3个百分点;滑动模式的四个智能体上,无碰撞成功率提高4.1—12.4个百分点,成功率变化的置信区间均包含零。收益需按机制分别理解:阻挡模式主要解除卡住状态,滑动模式主要减少成功路线中的接触。这些是作者仿真实验结果,碰撞指导航网格缩短指令位移,并非真实刚体撞击。
该工作为导航评测补充了“成功是否无碰撞”的维度,也说明报告成绩时应交代碰撞处理机制,不能只凭任务成功率判断安全性。
接触指标不衡量作用力、损伤或动态对象风险;防护层是启发式方法而非安全保证,尚未经真机验证。
 2026-10-07 · arXiv · 作者论文StressDream:引导视频世界模型,用于鲁棒策略评估与改进
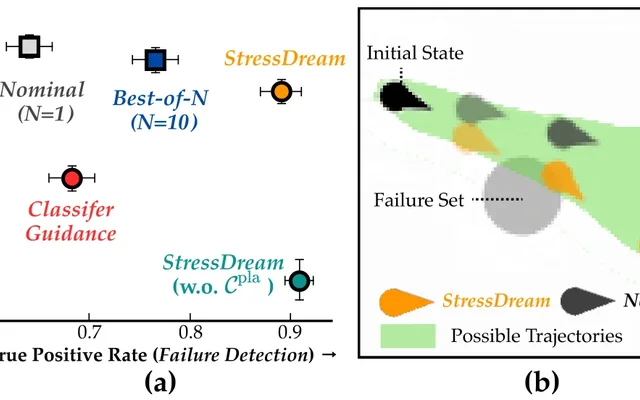
视频世界模型可按机器人动作生成未来观测,但常规生成可能漏掉高影响后果。作者提出StressDream,在推理时按文本目标引导模型寻找可能的失败。方法固定生成模型,优化扩散模型初始噪声:以视觉语言模型提供语义梯度,并约束范数、各向同性和频谱白性,使噪声保持高斯先验的典型性,减少不合理生成。
作者在已知动力学与不确定性的受控实验中报告,该方法比常规生成和Best-of-N更有效地发现可能失败;去掉合理性约束则会生成不合理失败。驾驶与操作实验分别使用Vista和Ctrl-World,均进行了任务相关微调;作者认为这对其场景中的罕见事件生成和视频质量很重要。作者还报告,以悲观生成辅助示范重加权后,π0.5-droid鲁棒微调策略在所评估各任务上的成功率均高于常规微调。
以上均为作者实验结果。风险评估针对候选轨迹,并非完整策略闭环评估。噪声优化只是局部细化;“合理”仅相对于模型已学分布,不能修正基础模型的物理错误,也不能生成其分布中缺失的真实可能结果。
该研究展示了用引导生成筛查候选轨迹失败风险、并以悲观生成辅助示范重加权的路径;证据限于作者所评估的设置,不外推为通用策略能力。
不能据此推断全局最坏情形覆盖或现实安全保证:噪声搜索是局部细化,生成受基础世界模型分布约束。作者还指出,当前模型每次未来生成可能耗时数分钟。所给材料未提供独立研究复现证据。
 2026-10-07 · arXiv · 作者论文世界模型的物理终极考试
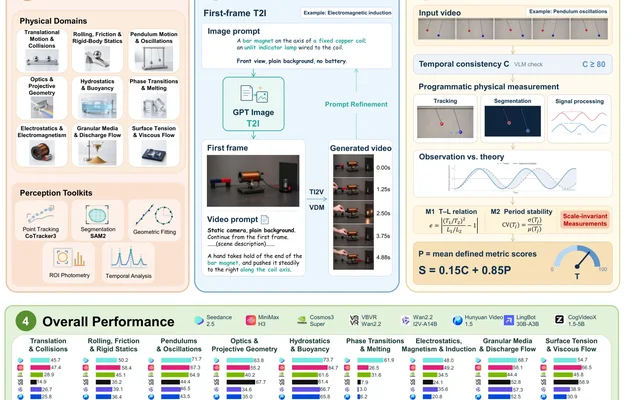
作者提出“世界模型的物理终极考试”基准,以40项受控任务覆盖力学、光学、流体、热与相变、电磁及表面张力等现象,评估视频生成中的可观测物理关系。
任务将初始图像、生成提示与预定义物理判据配对,无需参考视频。评估器区分时序一致性、任务可观测性与物理正确性,通过跟踪、分割和时序分析提取周期、角度及液位。物理测量独立于筛查尝试;只有满足一致性门控且记录了物理分数,物理分才计入综合分,通过筛查不代表物理正确。
作者对八个视频模型生成的1,280段视频进行评测。在该协议下,Seedance平均综合分最高,为57.76,模型与任务间差异明显。排除证据不足的视频对、保留并列后,评估器与人工的任务内排序一致率为51.58%,高于直接VLM的43.40%,低于人工间参考值56.60%。另在绕过门控的480段合成参考视频上,测量模块平均物理分为97.53;该结果仅支持受控合成条件下的测量有效性,不能外推通用具身能力。
将视觉连贯、任务可观测性与可测物理关系分开,为诊断视频模型的物理不一致提供可解释依据,而非通用具身能力认证。
上述结果属于作者论文内评测,不作为独立研究复现呈现。测试仅验证既定实验假设下的可观测关系,受证据可见性与提取可靠性限制;提取未解时按规则记入的操作性零分,不等于已测得物理违规。
 2026-10-10 · arXiv · 作者论文像世界模型一样思考,像VLA一样行动:将世界模型表征蒸馏到紧凑机器人策略中
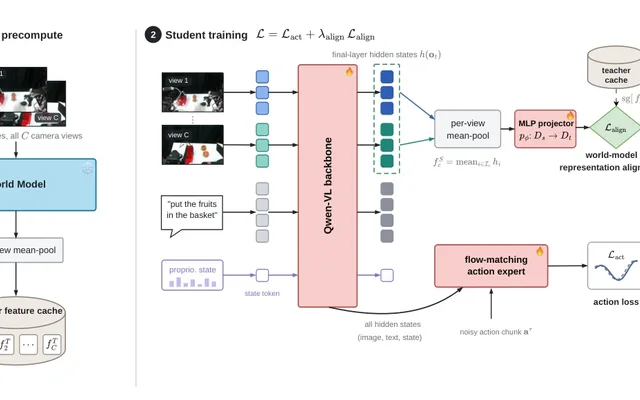
标准视觉—语言—动作(VLA)训练缺少显式建模动作如何改变环境的目标,而世界模型的未来生成又增加控制开销。作者提出将表征迁移与未来生成分离,让小型策略学习世界模型的内部特征,而不在部署时运行世界模型。
方法在常规动作训练中加入余弦特征对齐损失:冻结教师,提前提取并缓存训练画面的特征;学生通过投影器对齐缓存,训练时不加载教师权重,训练后丢弃投影器。主教师取自Cosmos 3的理解塔,部署策略与未蒸馏基线保持相同架构。
作者报告,0.8B学生在LIBERO的平均成功率达97.9%,比同规模未蒸馏基线高2.6个百分点;RoboCasa-GR1由48.2%升至50.5%。仿真主结果采用两种种子与两种GPU交叉的四次评测均值。真机单臂水果任务由83.3%升至93.3%,双臂水果交接由40.0%升至46.7%,每项每策略均测试30次。这些结果支持所测任务中的表征迁移收益,不等同于通用操作能力。
这项作者研究展示了一条将世界模型用作离线表征教师、而非在线控制器的路径:通过训练期对齐改善紧凑策略,部署时不增加网络模块。
证据为作者论文实验,不作独立复现结论。真机每项每策略仅30次试验;RoboCasa-GR1消融仅在A100上评测一次,层位置消融还缩短了训练周期。论文引用的其他模型成绩不宜据此作跨协议排名。
世界模型规划常用较大的固定搜索预算,并在迭代中重复编码不变的观测与目标。作者提出SufficientPlan,在不重训世界模型、不改变原生规划目标的前提下,分别减少多余搜索和重复计算。
其配对序贯预算认证(PSBC)在开发集上比较缩减预算与完整预算的闭环任务结果,以预设性能容差认证模型—任务专属预算,随后冻结预算用于留出评测,而非要求动作一致。静态上下文复用(SCR)则在单次规划求解内缓存观测和目标表示,保留依赖候选动作的计算。
作者报告,在16个骨干—任务组合中,PSBC平均使用完整预算的30.0%,候选评估减少70.0%;14个组合的留出成功率降幅不超过2个百分点,但Fast-LeWM/Push-T与C-JEPA/Push-T分别下降6和3个百分点。匹配预算等条件的SCR评测中,回合成功结果零翻转,规划加速最高2.18倍;另一个Fast-LeWM/Push-T深度实验在30次迭代时达到2.45倍。结果来自仿真视觉控制基准,时延实验每次使用单张NVIDIA RTX A5000,不能据此推断真机收益。
将“结果足够好”的预算校准与单次求解内的计算复用分开,为既有世界模型规划器提供部署侧优化路径,而非改进模型本身。
这是作者论文结果,不是独立复现。PSBC认证不保证每个有限留出样本都满足容差,也不代表全局最小预算;分布显著变化可能需重新校准。SCR收益取决于静态计算占比。作者仅表示计划发布实现与配置,不能视为已开放。
 2026-10-08 · arXiv · 作者论文鳗鱼仿生软体机器人的执行器控制与健康实时估计器(REACH)
针对软体游泳机器人材料与执行器易退化、健康状态难监测的问题,作者提出REACH,将执行器健康度定义为实际与期望输出扭矩之比,用于估计鳗鱼仿生机器人的执行器退化与故障。
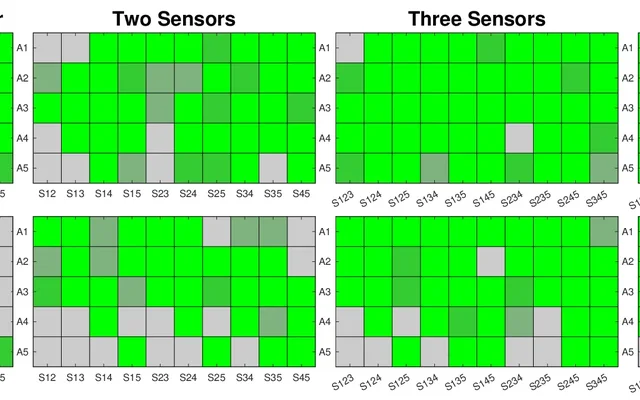
方法以软体游泳仿真平台ASSRSimP为预测模型,结合Sigma点卡尔曼滤波处理非线性,并用统计检验调节过程与测量噪声、评估滤波一致性。在五执行器机器人仿真中,作者比较GPS、IMU与弯曲传感器:后两者均能在三秒内检测各执行器故障,GPS在该测试中未能检测故障。传感器数量与布置实验显示,IMU置于A1、A4,或弯曲传感器置于A2、A4、A5,可达到论文定义的优秀估计表现。
真机验证采用三执行器软体机器人的弯曲传感器数据,先按满负荷游泳数据校准各执行器刚度,再估计其他工况。作者报告,多数工况的健康度估计准确,但部分结果存在偏移;故障状态预测较好,部分或完全正常执行器的精确健康值仍有误差。因此,仿真中的传感器配置结论与真机数据验证应分开理解。
为软体游泳机器人的执行器退化监测提供了模型驱动方案,并给出特定仿真条件下的传感器选型与布置依据。
证据为作者论文中的仿真与真机数据验证,不应视为独立复现。真机连接外部泵与外部微控制器,且需校准执行器刚度;部分健康度估计存在偏移,不能据此推断自主水下任务能力。
 2026-10-06 · arXiv · 作者论文MobileVISTA:用于移动操作位姿泛化的生成式数据增强
仅用单一底座位姿的示范训练操作策略,部署时厘米级偏移就可能使视觉观测与末端轨迹偏离训练分布。作者提出MobileVISTA,将标准位姿示范离线扩展为位姿扰动数据,核心是联合增强第一视角观测与重定向动作,而非只改变图像。
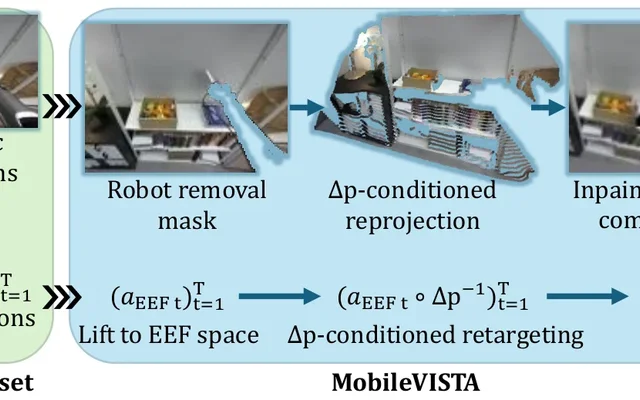
视觉分支先移除机器人、重投影场景,再合成重定向姿态下重新渲染的机器人;动作分支在末端空间补偿底座变化,必要时通过全身逆运动学求解关节配置。该配置同时决定相机外参与机器人几何,面向相机随驱动链运动、机器人身体出现在画面中的设置。
作者在仿真及真实Galaxea R1 Pro上评测。真机每项任务采集50条标准位姿示范,随机测试偏移从半径15厘米圆盘内采样,同一偏移下各策略不重新定位。书本堆叠中,MobileVISTA抓取成功17/25、堆叠成功13/25,各基线两阶段均不超过2/25。但标准位姿下,其堆叠为18/25,低于Canonical-2D的24/25和微调π₀.₅的25/25,显示扰动鲁棒性收益伴随该任务的精度代价。
作者实验支持以配对的视觉—动作合成数据改善底座位姿鲁棒性;这是数据生成框架,不是新的策略架构,也不应据此推断通用操作能力。
结论限于作者测试:平移扰动范围为15厘米、训练偏航范围为±5°,真机测试未显式控制偏航,范围外未验证。方法依赖机器人几何模型,未增强腕部相机。
人形机器人接住飞来的箱子,需要同时协调全身动作、预测物体运动,并处理第一视角下的相机运动与遮挡。作者以接箱为任务提出Reflex,探索从机载RGB-D观测到全身反应控制的学习方法。
方法采用三阶段训练与动力学潜表示:先用强化学习和人体运动先验学习基于状态的接箱控制,再从延迟、不完整的箱体观测学习动力学表示,最后用第一视角RGB-D历史及相机自运动预测该表示,保持全身控制器固定,使视觉学习与控制训练分离。
作者报告,仿真视觉接箱成功率为85.7%,同一解码器接收特权潜表示时为87.9%。视觉消融中,去掉时间历史,正中与横向偏移0.6米投掷的成功率分别下降35.6和39.8个百分点。真实宇树G1在2.5米、5米接住人抛箱子的成功率为65%和40%。仿真接箱判据要求胸前支撑、双腕分居箱体两侧且低速保持0.6秒,不只是碰到箱子;真机每种条件仅20次试验,95% Wilson区间幅度可达约±20个百分点,结果不宜外推为通用反应能力。
这项作者研究展示了通过共享动力学潜表示、冻结控制器来学习视觉接箱的路径,价值在于解耦视觉学习与全身控制,而非证明通用人形技能。
证据为作者论文实验,不作独立复现结论。任务限于人抛箱子;长距离视觉感知仍是主要瓶颈,扩充远距离视觉训练后的改进仅在仿真验证,尚未真机测试。
 2026-10-08 · arXiv · 作者论文HIL-UMI:将视觉—语言—动作模型的人在回路后训练引入通用操作接口
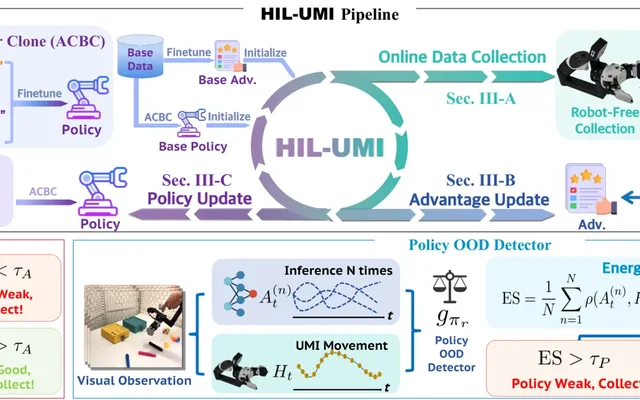
静态示范难以覆盖策略出错后进入的分布外状态,常规监督微调也不区分样本对任务进展的贡献。作者提出HIL-UMI,将人在回路后训练的数据采集移至手持通用操作接口(UMI):策略读取与人相同的观测流,但不在机器人上执行预测动作。
方法采用两条独立反馈回路:Energy Score比较人类动作片段与策略预测分布,触发针对性采集;另一回路收集优势预测偏低的片段,用于更新任务进展优势估计器,再以新旧数据混合开展优势条件行为克隆。
作者在单台Franka机械臂的四项长时程或精细操作任务上评测,每个策略检查点、每项任务测试10次,以给予子任务部分分数的任务进展分数(TPS)计量。论文报告,同等每轮数据预算下,HIL-UMI较SFT持续改善;在Clean Up Table同阶段预算比较中,最终TPS比HG-DAgger约高5分,每帧采集耗时分别为73.40和412.99毫秒。不过,针对性筛选使其每记录帧耗时高于常规SFT,不能将相对HG-DAgger的效率优势推广到所有采集方式。
其价值在于将策略感知的数据筛选与机器人执行解耦,为跨操作者、跨地点扩展采集提供路径,而非已经验证分布式训练。
证据来自作者论文,结果限于所述单臂、四任务及TPS协议,不能等同于完整任务成功率或通用能力;跨地点并行采集仍列为未来工作。
 2026-10-07 · arXiv · 作者论文RT-Safe:实时具身环境中的智能体安全基准评测
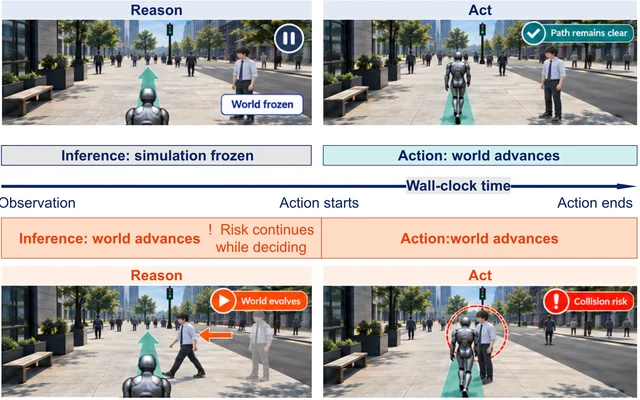
智能体观察时安全的路径,可能在推理结束前因行人或车辆移动而变得危险。作者提出城市导航仿真基准RT-SAFE,将决策延迟纳入安全评测:环境在推理和动作执行期间持续演化,分别记录推理期被动碰撞与执行期主动碰撞,并将到达目标与无安全事件的完成分开评价。
基准包含五张城市地图、36条路线。作者对八个视觉语言模型进行评测,在困难环境、厂商默认推理设置下比较288组配对模型—任务。静态模式仅在推理时暂停环境;两种模式的任务完成率分别为91.3%和94.1%,但安全完成率从19.8%降至0.7%,每回合碰撞从3.31次升至40.68次,为原来的12.3倍;实时碰撞中约84%发生在推理期间。
增加推理投入也未稳定改善整体安全:从默认提升至较高档位后,平均每回合碰撞由40.7次升至62.0次,任务完成率则由94.1%变为94.8%。这些结果属于作者的仿真实验;静态与实时对照还同时改变了提示中的时序指令,不能把行为差异全部归因于环境是否暂停。
该研究提示,导航评测应同时考察任务完成、安全事件与响应延迟;完成率相近可能掩盖显著不同的安全表现。
结论限于作者的仿真协议,不宜外推真机安全。碰撞计数允许持续接触产生重复事件;不同推理档位也不代表跨厂商等价的计算预算。
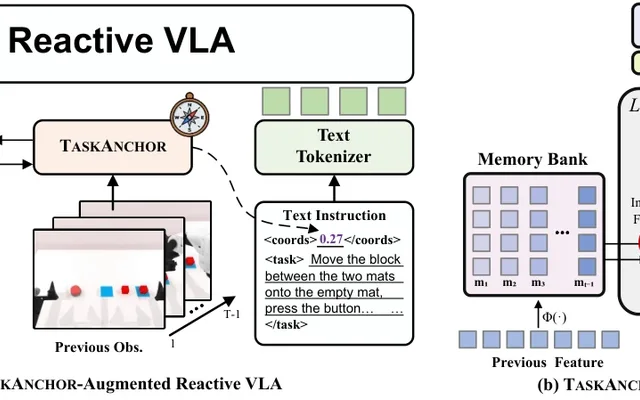 2026-10-09 · arXiv · 作者论文TaskAnchor:为长时程操作中的反应式VLA锚定任务状态
反应式视觉—语言—动作模型(VLA)在长时程操作中可能遇到“任务状态混淆”:相似画面与相同指令,在不同执行阶段却要求不同动作。作者提出TaskAnchor轻量适配框架,将历史信息转为任务状态条件。
方法采用任务状态坐标与视觉残差双通路:以里程碑监督学习语义执行阶段,将坐标前置于语言指令;用历史证据修正当前视觉特征。不引入独立规划器,也不改变原有动作生成机制;适配器与策略在后训练中联合优化,推理时不需真实阶段标注。
作者报告,在RMBench的M(1)、demo clean设置下,联合多任务训练的π0.5与X-VLA版本平均成功率分别为0.70、0.66;逐任务训练分别为0.79、0.70。RoboMemArena中,π0.5版本的完整任务成功率为50.0%、累计阶段成功率为74.2%,较π0.5分别提高28.5、35.5个百分点。真机的人类提示匹配、红块重复举起和薯片袋结账任务各进行25次试验,TaskAnchor-XVLA均完成25次;这些结果限于论文所述任务与协议。
作者实验支持将历史证据与显式阶段条件结合,用于改善预训练VLA的历史依赖动作选择,而非另设规划循环。
后训练仍依赖任务特定的语义阶段标注;对完全未见任务、新物体配置和未见执行结构的迁移尚未充分评估,不能据此推断通用长时程能力。
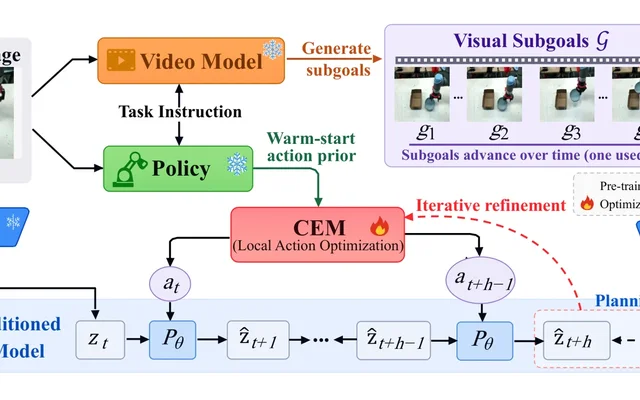 2026-10-10 · arXiv · 作者论文PILOT:利用视觉子目标与策略先验引导机器人操作的长时程世界模型规划
远期目标图像难以指导抓取等准备动作,无引导的动作采样又使局部搜索低效。作者提出PILOT,用视觉子目标与策略先验分别引导任务推进和动作搜索。
方法由视频模型生成中间视觉子目标,学习策略初始化交叉熵方法(CEM),再用动作条件世界模型评估、优化候选动作;控制器执行一小段动作后重新观测并规划,而非直接执行策略输出。
作者在UR5e四项拾放任务中,每项对各方法测试20次。PILOT总体成功率为68.8%,无策略初始化版本为55.0%,直接执行策略为13.8%,直接面向最终目标规划为0.0%。长Push-T和LIBERO-10仿真中,相比直接执行同一策略,成功率分别高30和22个百分点。Push-T局部优化中,策略初始化用4轮达到通用初始化10轮的代价水平,同采样预算下最终规划代价低24.1%。
条件上,真机视频模型与策略均用同一组40条成功示范微调,但世界模型还使用约五小时随机交互数据,系统亦依赖基础模型预训练;不能将其理解为整个系统仅用40条示范训练。
作者实验支持将任务阶段引导与局部动作搜索分工:视觉子目标帮助短预测时域规划推进任务,策略先验进一步改善搜索效率。
证据来自作者论文实验,真机范围限于UR5e四项桌面任务。不可达子目标、世界模型误判和受限探索均可能导致失败;固定子目标时序不适应交互延迟,视频生成与在线优化还会增加延迟,不能据此外推通用操作能力。
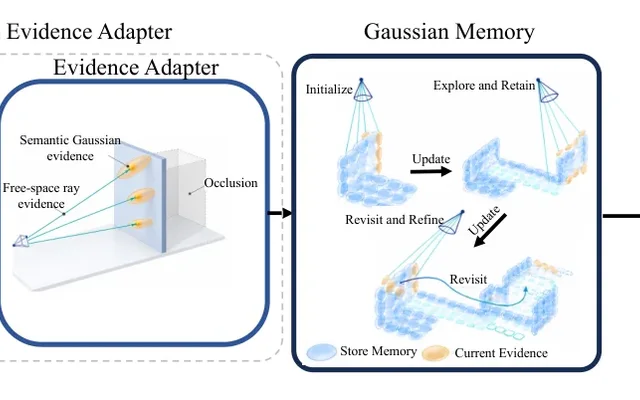 2026-10-05 · arXiv · 作者论文GEM-Occ:从视觉几何证据到具身语义占据记忆
室内探索中的单次观测往往不完整且存在不确定性,如何在离开视野、再次到访后保留并修正空间认知,是持续建图的问题。作者提出GEM-Occ,将连续观测转化为持久语义占据记忆。
其核心是联合存储占据语义高斯与自由空间射线证据:按置信度融合支持性观测,用可见空域修正矛盾占据,但不把遮挡当作结构消失;再以空间子图和建筑级连通图组织记忆。作者同时构建HIOcc,统一局部预测、房间级在线建图和建筑级建图的语义标签与评测框架。
作者报告,在Matterport3D建筑级实验中,各变体使用相同的已训练预测器和监督;相较平铺高斯记忆,GEM-Occ的语义mIoU由43.1升至46.7,重访一致性由80.8升至86.2;单位探索面积内存由1.36降至0.81 MB/m²,稠密占据查询延迟由49.5降至33.8毫秒。
这些结果限于提供相机位姿、固定语义类别的静态室内评测;查询延迟不是处理新观测的完整耗时,不能据此外推导航或操作能力。
该研究将“支持、矛盾与遮挡”区分处理,为兼顾持续占据记忆质量与存储、查询成本提供了作者实验依据。
证据为作者论文,非独立复现。建筑级预测器在Matterport3D上训练,不构成透视到全景的零样本迁移验证;代码、权重及相关脚本在文中仍为承诺发布。
预训练机器人策略具备任务知识,却可能因环境与本体差异而难以可靠执行。作者提出GLOVES,在不更新底层策略参数的前提下,用专家动作先验修正智能体提出的动作块,将任务理解与执行修正分离。
该先验从图像—动作示范中学习,训练和修正均不显式输入目标,由原始动作块提供意图线索。反向流评分门控让符合专家分布的动作直接执行,仅修正异常动作,无需另训检测器。GRIP结合部分加噪与能量引导,仅需专家流;LIFT额外学习智能体流,通过向专家分布输运进行修正,避免选择部分加噪深度。
作者在三项仿真任务及UR5的两项真机任务中评估。Slalom仿真中,LIFT将FLOWER系VLA成功率从33.06%提高至76.67%,CaP从63.67%提高至97.67%;两类智能体应各自对照无辅助基线。真机充电器插接中,GRIP将成功次数从18/40提高至40/40。这些是作者实验结果;“不更新”指适配阶段,所用FLOWER在相关任务上已先行微调,并非未经任务训练即可获得上述表现。
提供一种把任务理解留给底层智能体、以目标无关专家先验选择性修正执行动作的适配路径。
证据为作者论文,不能视为独立复现或通用能力证明。评估限于所列任务;门控的净计算收益取决于干预率和修正成本。
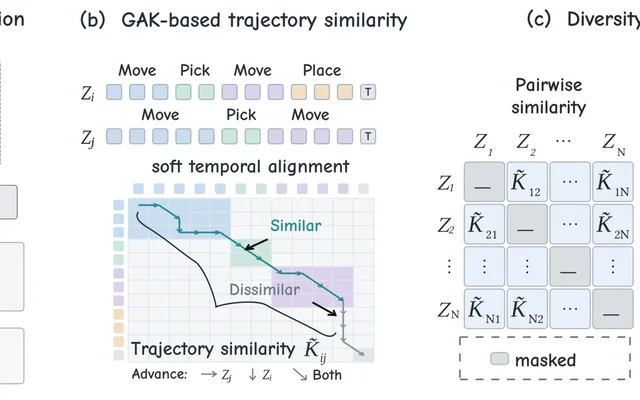 2026-10-07 · arXiv · 作者论文成功的多种路径:面向VLA泛化的多样性驱动强化学习微调
作者论文研究视觉—语言—动作(VLA)策略的强化学习微调:整体行为收缩与成功轨迹多样化可以并存,而标准二元任务奖励不能区分不同成功解法。作者据此提出DRIVE,在相同任务与环境条件下分组比较轨迹,用全局对齐核(GAK)处理时间错位,仅向成功轨迹提供相对多样性奖励,避免显式奖励不同形式的失败。
在LIBERO-Plus、ManiSkill3和RoboTwin 2.0仿真评测中,作者报告相对Vanilla RFT,π₀与π₀.₅的分布外成功率宏平均分别提升5.3和2.0个百分点。除另有说明外,同一基准—骨干设置内共享SFT初始化、训练时长、轨迹分布及PPO配置。
双臂AgileX PiPER-X实验中,作者报告分布外平均成功率由64.1%升至73.3%。策略先在对齐仿真中训练,再部署真机;测试为按铃和按订书机两项任务,包括干扰物、桌面背景和光照三类偏移,每个任务—条件组合测试20次。结论限于作者所测设置,不能外推通用能力。
这项作者研究将成功解法的多样性纳入显式优化目标,为改善所测分布偏移下的VLA泛化提供了一种训练思路;这里呈现的是作者实验结果,而非独立研究复现。
组内两两GAK比较增加计算,并依赖VLM表征能否捕捉有意义的行为差异。更长时域、更多本体及在线真机微调仍待评估;真机结果仅支持所测任务与条件下的表现,不代表通用操作能力。
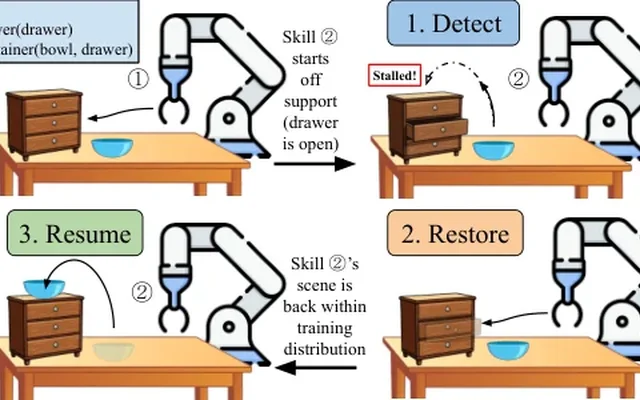 2026-10-08 · arXiv · 作者论文长时程技能衔接处观测空间偏移的诊断与恢复
独立训练的操作技能串联后,下游技能需接手前序留下的场景,可能偏离训练分布并停滞。作者通过仿真特权重置诊断这种观测空间偏移,发现主要影响来自抽屉等关节化部件及次要物体的状态变化,而非机械臂构型或下游操作的目标物体。
研究提出检测—恢复—继续执行:进度监测器识别停滞,学习策略恢复场景,再用针对恢复后交接状态的微调帮助技能继续执行。仿真部署仅使用RGB与本体感知。在BOSS-44的10条严重失效三技能链、5个种子评测中,全链成功率从7.6%升至26.5%;同等归位重试预算基线为12.9%,特权重置参照为51.8%。这些结果属于作者实验。
真机采用Franka与微调π₀.₅,但恢复动作由语言提示驱动,并非仿真蒸馏策略。闭环恢复了部分原本终止的放置尝试;作者仅将其视为概念验证,不主张成功率提升。外部相机可观测性仍限制监测,当前抽屉恢复器也无法解决自由物体移位造成的阻塞。
该研究支持在特定技能衔接故障中,先恢复阻塞场景、再继续执行,而非仅增加重试;证据用于支持故障诊断,不代表通用恢复能力。
定量核心在仿真,采用单一基础策略种子及未经多重比较校正的10条链检验;恢复可能破坏下游技能所需状态。真机仅为概念验证,不能将仿真成功率或恢复策略直接外推到硬件。
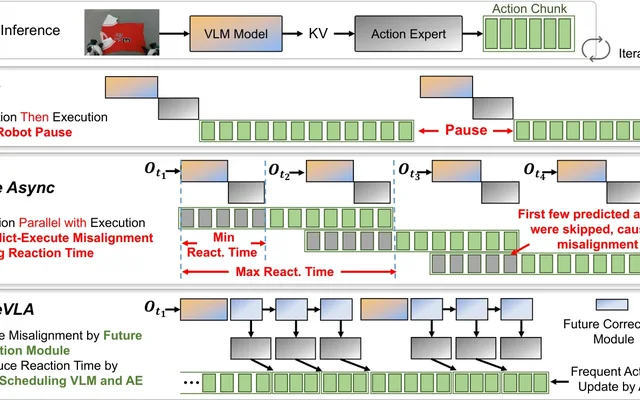 2026-10-08 · arXiv · 作者论文EagleVLA:通过前瞻对齐的异步推理迈向机载实时机器人控制
机载设备运行视觉—语言—动作(VLA)模型时,推理延迟会压低控制频率;异步执行虽能掩盖部分延迟,却仍面临感知与执行错位、反应时间长的问题。作者提出EagleVLA,结合未来表征校正、调度与系统优化,改善低功耗设备上的控制。
其前瞻对齐异步校正以已确定执行的动作为条件,预测未来的压缩VLM末层表征,让动作专家从未来时刻开始生成动作,而非直接预测未来图像。置信度调度在预测可信时跳过VLM、直接调用动作专家,置信度不足时重新观测;基于llama.cpp的引擎再通过CUDA图复用、GPU常驻中间缓冲和流匹配展开减少开销。
作者在LIBERO上报告:Jetson Orin的控制频率由朴素π₀.₅推理的0.70 Hz升至6.93 Hz,反应时间由1420.8 ms降至144.3 ms;正文报告相对朴素PyTorch的控制频率改善为9.85倍。另在以π₀.₅为基础的仿真中,按四个子数据集及不同推理延迟取平均,作者报告成功率优于VLASH 14.8%。这些结果属于作者实验,不代表独立复现。
将动作条件的未来表征预测与置信度调度结合,为缓解机载异步控制中的时序错位和反应延迟提供了一条方法路径。
比较限于论文所述模型、设备与评测设置;14.8%沿用作者表述,不改称百分点。作者指出,机载算力和带宽仍受限,模型及批量规模扩大后未必能弥合高端GPU部署差距。
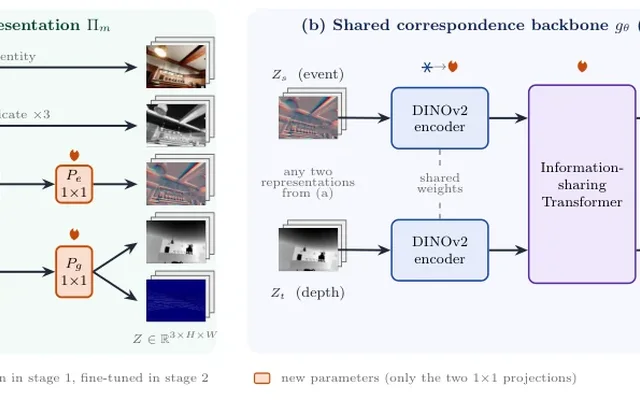 2026-10-10 · arXiv · 作者论文TartanMatch:迈向跨模态通用稠密对应
机器人融合多种传感器,但既有稠密对应方法多局限于RGB或少数模态对,逐对训练也难以扩展。作者提出TartanMatch,以单一共享网络覆盖RGB、事件、热成像、深度和投影激光雷达之间全部25种有向配对,预测稠密流与共视性。
方法基于RGB预训练的UFM,保留各传感器的测量结构,通过轻量学习投影适配输入,而非统一转为固定伪彩图。训练混合真实与合成数据,采用先冻结编码器、再端到端微调的两阶段流程。
作者报告,在真实世界零样本基准上,相对各受测模态对的最强基线,跨模态与同模态平均端点误差(EPE)分别降低61.9%和49.6%。另在TartanAirV2验证集的联合训练实验中,相对逐对训练,两类平均EPE分别降低34.1%和17.8%,15个受测配对中11个改善。
这些结果需按实验条件理解:真实基准比较限于有公开权重的可用基线;联合训练收益来自TartanAirV2实验,并非全部25种有向配对均逐项取得提升。
该工作为多传感器稠密对应提供共享模型路线,并在指定实验中显示跨模态联合训练的正迁移。
证据为作者论文实验,不是独立复现结论;跨模态里程计、跨传感器标定和地点识别仍被列为后续应用方向,不能据此认定机器人通用能力提升。
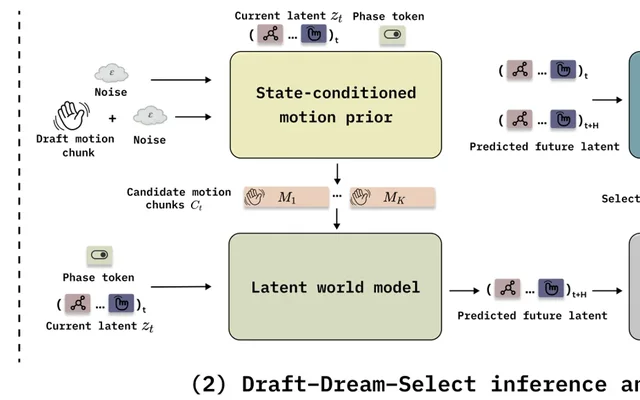 2026-10-10 · arXiv · 作者论文DexFLEX:用于指令引导灵巧操作的接触感知基础控制器
遥操作或学习策略能提供灵巧手的运动意图,却往往未指定哪些接触需要承重、何时转移支撑;运动学上合理的指令也可能破坏抓握。作者提出DexFLEX,将上游指尖运动草案视为意图线索,而非直接照搬的轨迹。
其核心是提出—预测—选择:依据触觉与本体感知状态生成短时域运动片段,由潜在世界模型预测接触后果,再兼顾指令一致性和接触稳定性选取动作。推理时,Draft–Dream–Select结合用于恢复的纯先验候选与保持响应性的草案初始化候选,最终解码为关节目标。
作者报告,同一控制器无需重训即可用于退化指令仿真、真实共享控制和视觉运动策略学习。六项真实工具遥操作任务中,平均成功率由原始遥操作的29.2%升至78.3%,DexGen为52.5%;每种方法每任务由两名操作者合计测试20次。策略学习在三项任务、每任务50条示范及相同策略骨干条件下,平均成功率为46.7%,直接关节动作预测和DexGen分别为13.3%与30.0%。这些结果属于论文作者实验。
该工作展示了将上游意图表达与接触敏感执行分离的低层控制接口:用预测的接触后果筛选动作,而不只依据动作先验或草案匹配。
作者明确限定固定机器人本体、触觉感知和统一指尖运动指令空间;触觉仿真到现实差异或草案超出所学先验支持范围时仍可能失败,不能据此推断跨本体通用能力。
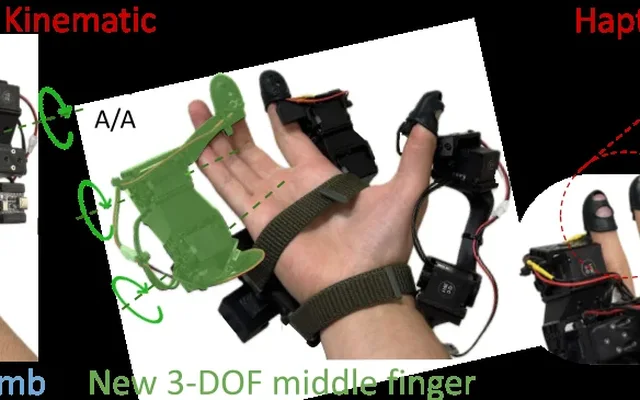 2026-10-05 · arXiv · 作者论文DITTO-X:面向灵巧操作与人工干预的正向和反向遥操作
灵巧手在任务中途交给人类控制时,操作者不仅可能因相机遮挡看不清接触,还需立即匹配机器人已有的握姿,否则可能掉落或损坏物体。作者提出DITTO-X,将接触反馈与接管前的手形对齐结合,面向示范采集和策略部署中的人工干预。
系统用电动外骨骼提供关节级力反馈,以指尖振动提示接触事件;同时支持反向遥操作,在策略控制期间驱动操作者手指匹配机器人构型,再转交控制权。作者报告,该接口无需为每种手重新设计硬件,即可驱动Sharpa Wave、Wuji 2和Inspire RH56DFX,但位置映射与反馈需按各手的运动学及传感条件选择。
在作者的六人用户研究中,相比无反馈、不能主动驱动人手的Manus Pro手套,DITTO-X的工具使用数据采集成功率为70.0%对46.7%,每次成功耗时由85.5秒降至56.1秒;策略先抓起夹钳、再由人接管的任务成功率为78.3%对27.7%。这些结果对应特定工具任务;指尖接触事件反馈仅用于具备指尖触觉传感的Sharpa,不能视为三种手均验证了同等反馈能力。
研究将接管前的人机手形匹配纳入遥操作接口设计,为保持已有抓握状态的人工干预提供了具体机制。
证据来自作者论文中的六人用户研究及任务实验,不作为独立复现结论;Wuji和Inspire虽已实现反向遥操作,但其DAgger实验仍留待后续工作。


提供了一条将轨迹级多模态表示、跨块行为连续性与单次前向推理结合的策略设计路径。
证据为作者论文中的实验报告,不作为独立复现结论。D3IL既有结果及LIBERO外部基线的协议并未完全匹配;真机结论限于文中任务,不能外推通用操作能力。