NVIDIA 扩展 Isaac:衔接机器人训练、运行时与人形参考平台
把仿真中训练的机器人技能搬到真机,开发者常需拼接仿真、训练和部署工具。在 GTC Berlin(柏林)发布会上,NVIDIA 宣布扩展 Isaac,重点是衔接这些环节。按公告,Agile Robots 发布了预装机器人基础模型平台 Isaac GR00T、搭载 Jetson Thor 的人形参考平台 Agile ONE SN;厂商称统一工具和流程可将搭建时间从数周缩至数天,这不是独立测试结果。
展开阅读 具身图谱在图谱中把握具身智能
本期重点看英伟达在 GTC Berlin(柏林)发布的 Isaac 与 Cosmos 工具链更新:前者衔接仿真训练和本体运行,后者补充数据生成、模型适配与仿真评估。研究侧则关注更具体的问题:行走时看哪里、插入时学哪一段、倒水何时停,以及生成视频是否遗漏危险后果。
把仿真中训练的机器人技能搬到真机,开发者常需拼接仿真、训练和部署工具。在 GTC Berlin(柏林)发布会上,NVIDIA 宣布扩展 Isaac,重点是衔接这些环节。按公告,Agile Robots 发布了预装机器人基础模型平台 Isaac GR00T、搭载 Jetson Thor 的人形参考平台 Agile ONE SN;厂商称统一工具和流程可将搭建时间从数周缩至数天,这不是独立测试结果。
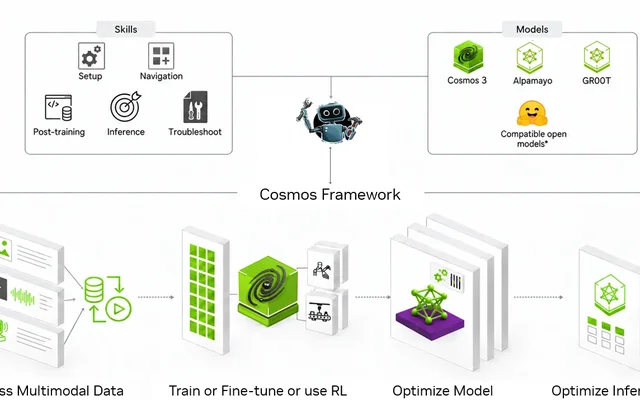
展开阅读让巡检机器人学习识别液体泄漏,或在真机测试前检查双臂机器人的控制策略,需要准备数据、适配模型并测试行为。英伟达在 GTC Berlin(柏林)期间宣布扩展 Cosmos 世界模型平台;世界模型用于帮助物理人工智能理解和模拟现实,本次变化集中在开发工具链。
展开阅读针对倒立摆训练,Isaac Lab 3.0 发布说明分别提供普通任务和带相机任务的启动示例。此次工程变化是同一套任务接口可面向多种后端,即实际执行仿真或渲染的实现:受支持任务切换后端时不必重写任务逻辑,开发者也可按需安装运行组件。物理、渲染与可视化可分别配置,但支持的组合取决于具体任务,并非每次训练都要显式选择三者。
展开阅读把仿真中训练的机器人技能搬到真机,开发者常需拼接仿真、训练和部署工具。在 GTC Berlin(柏林)发布会上,NVIDIA 宣布扩展 Isaac,重点是衔接这些环节。按公告,Agile Robots 发布了预装机器人基础模型平台 Isaac GR00T、搭载 Jetson Thor 的人形参考平台 Agile ONE SN;厂商称统一工具和流程可将搭建时间从数周缩至数天,这不是独立测试结果。
软件侧,公告称 Isaac Lab 3.0 已正式可用,以开源学习框架支持多图形处理器训练;新增 Isaac OS 运行时基于 Holoscan,连接人工智能、传感器、控制与机器人硬件,目标是实现从仿真到真机的确定性实时运行。对本体软件开发者,关注点是训练工具与硬件运行链路如何衔接,而非据此判断动作能力提升。
数据侧,SimReady 资源库提供超过两千项仿真资产;Human 1M 数据集包含同步三视角视频和三维手部跟踪,完整数据面向 Cosmos Coalition 合作伙伴开放。参考人形平台计划于2027年初供应,Halos 安全系统仍属计划集成,不能把此次公告理解为整套系统已经可交付。
 2026-10-22 · NVIDIA · 官方声明NVIDIA Cosmos 扩展世界模型的数据、训练、仿真评估与部署工具
让巡检机器人学习识别液体泄漏,或在真机测试前检查双臂机器人的控制策略,需要准备数据、适配模型并测试行为。英伟达在 GTC Berlin(柏林)期间宣布扩展 Cosmos 世界模型平台;世界模型用于帮助物理人工智能理解和模拟现实,本次变化集中在开发工具链。
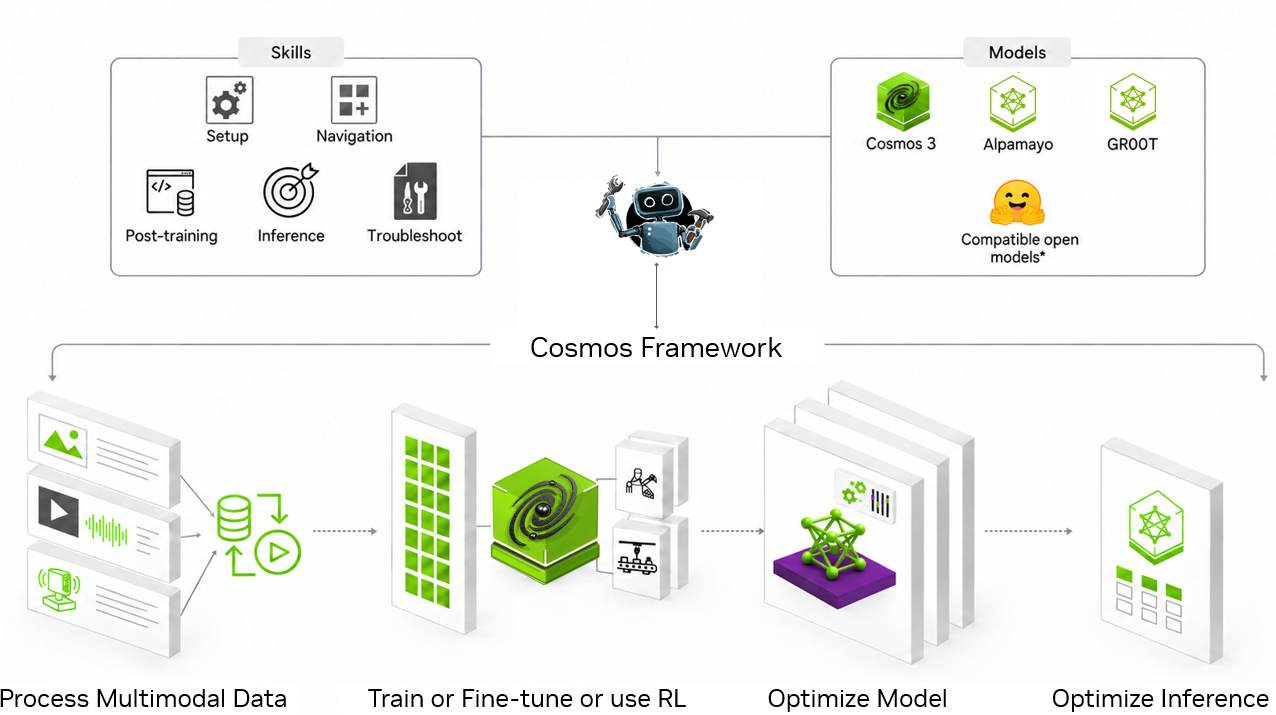
数据侧,Cosmos Data Factory 汇集标注、筛选、增强和评估工具。厂商称,ANYbotics 已生成超过1500段合成视频,并借助 Encord 整理真实数据、验证输出,用于训练工业巡检机器人识别泄漏等设施变化。模型侧,Cosmos Framework 将训练、优化和部署工具扩展到更多开放模型,支持微调、强化学习及模型压缩。
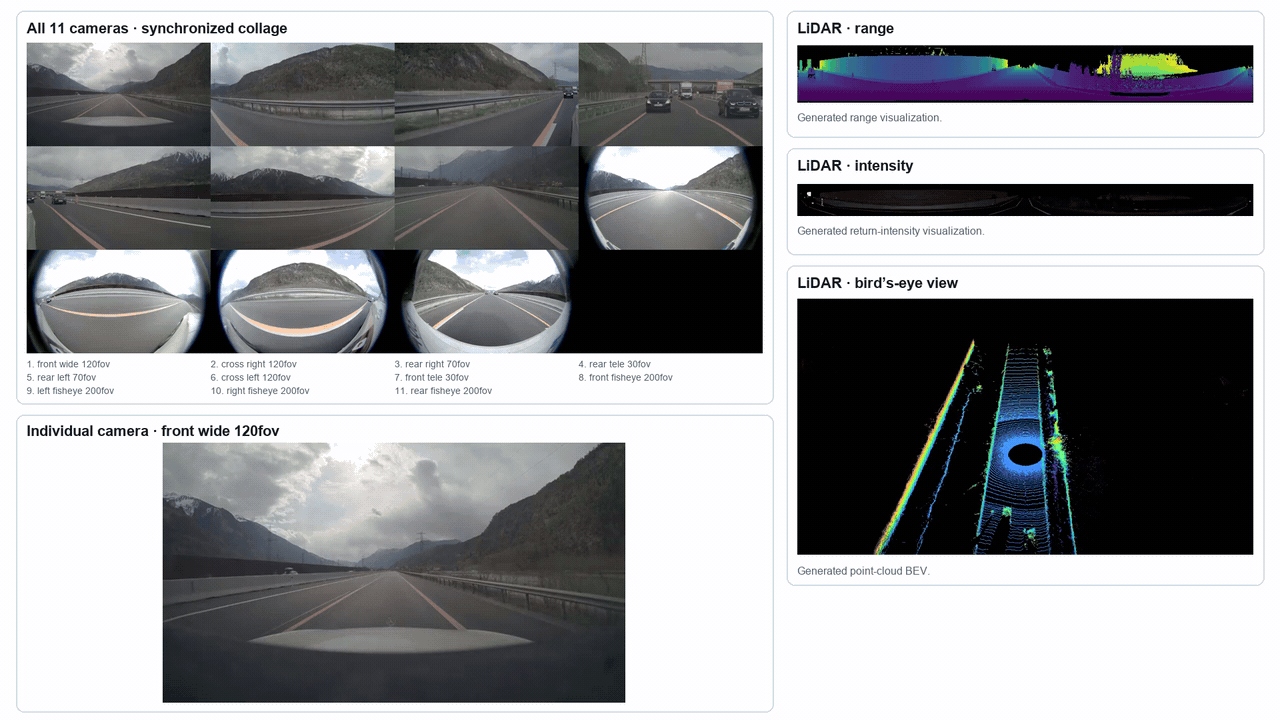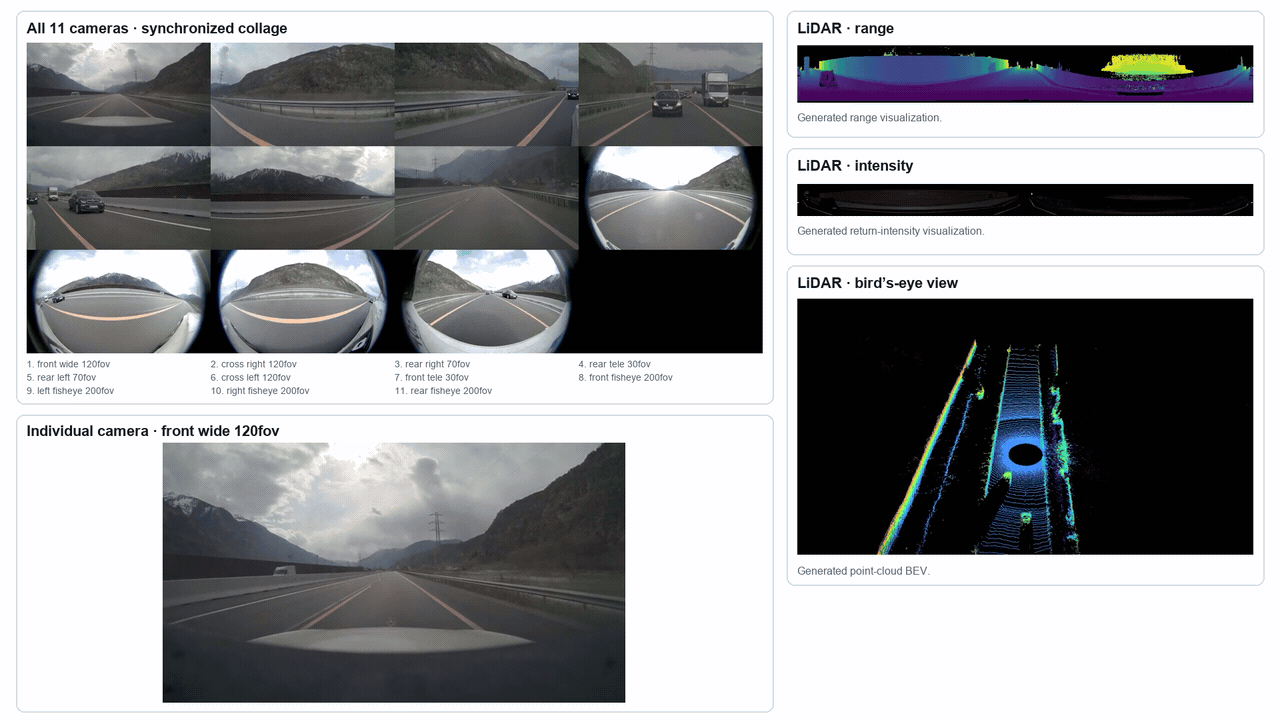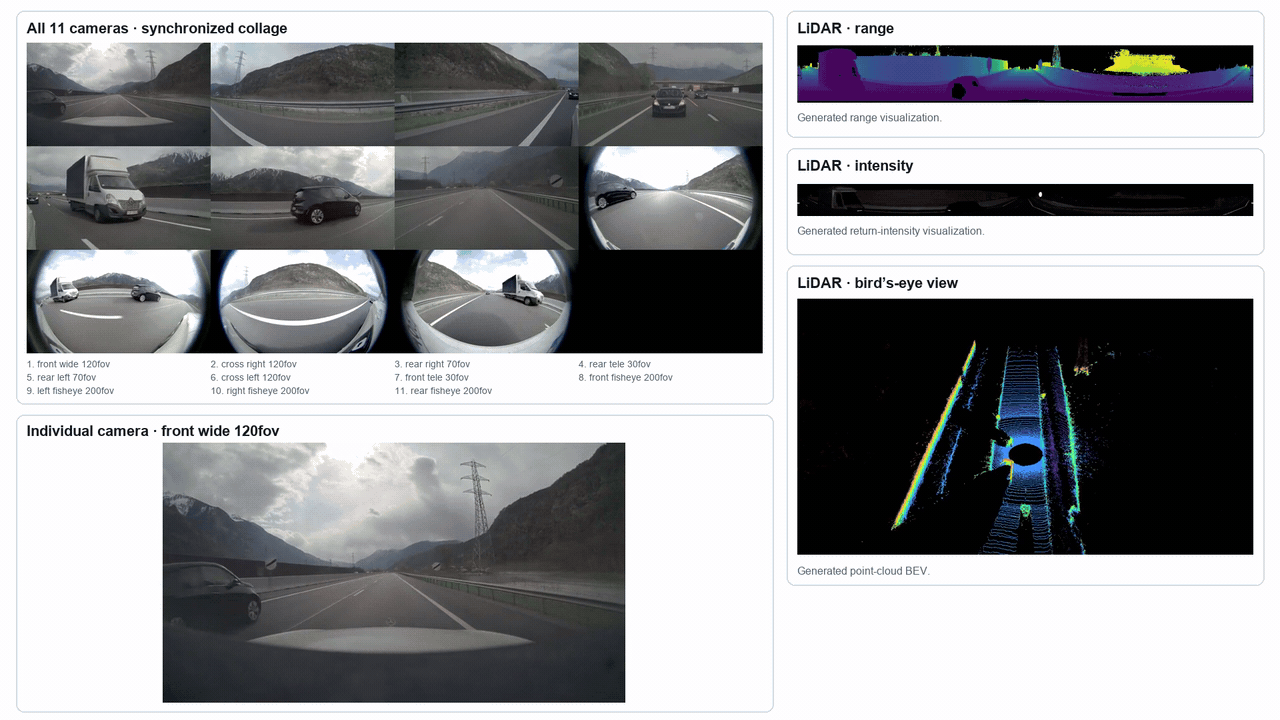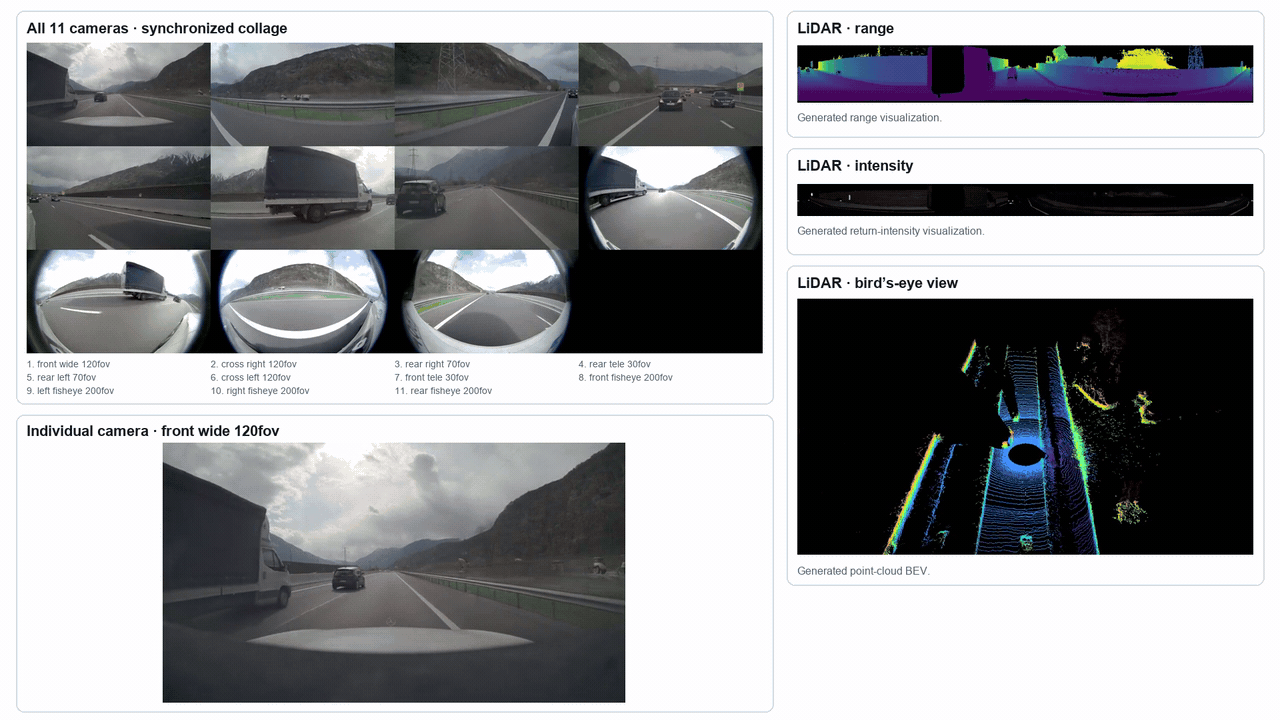
测试侧,Cosmos 3 Nano 新增仿真变体及配套代码,支持在可重复、难以采集的多视角、多传感器场景中训练和评估自动驾驶及双臂机器人策略,再进行现实测试。部署侧,厂商称更新后的 NIM 推理微服务在已验证配置中最高达到2倍推理速度且无质量损失。对开发团队,这提供了从数据到部署的模块化工具选择;上述能力和结果均为厂商声明,不代表真机通用能力或任意部署配置的收益。
对机器人软件团队,关注点是可分别使用数据生成、模型训练适配、仿真评估和推理部署工具,而非将此次更新视为机器人能力突破。开放性及工具支持范围来自厂商声明,不能等同于工程产物已被核验或独立研究已复现。
材料为厂商网页声明,所给原文未提供完整评测配置或独立复现证据;推理提速限定于已验证配置,合成视频案例也未给出机器人识别性能指标。网页为获取时快照,首发日期不能证明全部文字在报告截止前已存在。
针对倒立摆训练,Isaac Lab 3.0 发布说明分别提供普通任务和带相机任务的启动示例。此次工程变化是同一套任务接口可面向多种后端,即实际执行仿真或渲染的实现:受支持任务切换后端时不必重写任务逻辑,开发者也可按需安装运行组件。物理、渲染与可视化可分别配置,但支持的组合取决于具体任务,并非每次训练都要显式选择三者。
实现上,资产、传感器、场景和环境被分派到所选后端。官方称,多数工作流无需安装或启动 Isaac Sim;资产和传感器通过 ProxyArray 数据代理,向 Warp 与 PyTorch 提供零拷贝访问。训练和策略回放统一使用 isaaclab 命令入口。
这些是官方工程发布说明中的接口与工作流变化,不能据此认定训练提速或真机效果已获验证。需要机器人操作系统(ROS)桥接、扩展现实(XR)遥操作等能力时,仍需完整 Isaac Sim。迁移旧项目还须检查四元数这一旋转表示:分量顺序由 (w,x,y,z) 改为 (x,y,z,w),官方要求复查硬编码旋转、控制目标与观测。
对机器人软件开发者,价值主要在于按任务选择运行组件,并在受支持的后端间复用任务逻辑;这是工程接口与工作流调整,不是通用机器人能力的验证。
依据仅为所给官方工程发布说明,非作者论文或独立研究复现,不能据此确认性能提升、任意后端组合兼容或真机部署效果。页面为获取时快照;材料明确提示,首发日期不能证明全部文字在报告截止前已存在。
 2026-10-21 · arXiv · 作者论文看好脚下:面向人形机器人行走的预判式感知
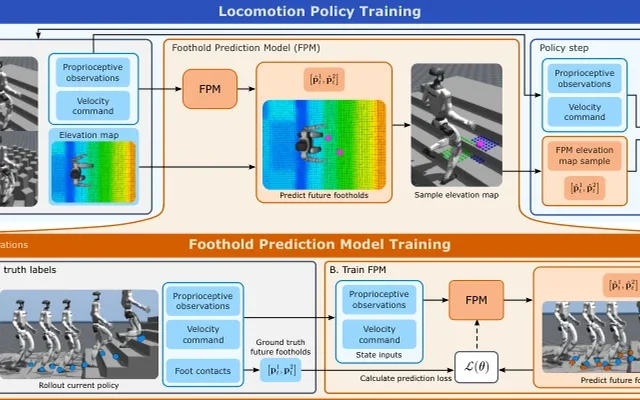
人形机器人走过踏脚石、楼梯或缺口时,整张地形高程图中不少区域并不会被踩到,却仍需策略学习筛选。本文把筛选提前到控制策略接收地形之前:只看预测落脚点周围的小块地形,为行走控制开发提供减少感知输入和训练负担的办法。
轻量级落脚点预测模型(FPM)仅依据机器人自身运动状态和速度指令,预测接下来两个落脚点,不读取地形;控制策略再利用这些位置附近的高程调整动作。地形输入由693个网格高度变为102个数值。训练中,预测模型定期用当前策略实际产生的落脚数据重新训练,跟随步态变化。
作者在统一策略架构、奖励和训练课程的仿真比较中报告,达到地形课程第5级,该方法需要7.5千次迭代,完整地图基线需要26.1千次。作者还报告,策略无需真机再训练即可迁移到宇树G1,在室内外通过多种地形,包括训练分布之外的缺口和下落台阶。
这些结果不等于全面优于完整地图:在走廊的阶梯类地形上,完整地图方法更好;侧向接近的障碍可能很晚才进入局部观察,甚至不被看到,现有走廊测试未覆盖这一风险。
对运动控制开发者,值得借鉴的是用预测落脚点筛选策略观察,而非把预测位置作为必须跟踪的落脚目标;作者实验表明,这种输入设计可减少达到指定地形难度所需的训练迭代。
证据为作者论文中的仿真比较与真机实验,不应外推为通用避障能力。作者明确指出,有效预测范围限于接下来两个落脚点,侧向接近障碍的风险尚未由该走廊测试检验。
 2026-10-19 · arXiv · 作者论文PrismWAM:解耦世界动作模型中的状态表示
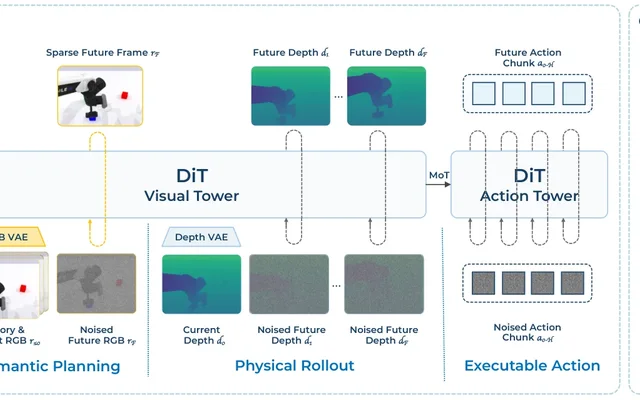
机器人双臂搬盘子、按大小排列方块时,既要理解目标,也要预测物体位置如何变化。作者提出PrismWAM,针对世界动作模型(WAM)把颜色、纹理与几何、姿态混在同一表示中的问题,将语义规划、物理演变预测与动作生成分开,为操作策略开发提供一种组织视觉与控制信息的方法。
训练时,彩色图像分支学习预测目标画面,深度分支预测中间几何变化,动作分支据此生成控制指令。推理时不生成未来彩色图像,也不必把深度特征解码成图像;模型执行部分动作后,再依据新观测重新规划。方法正文明确输入包括彩色图像历史、当前深度、语言指令和机器人自身状态,并非仅靠单张彩色图像。
作者在搬盘子、方块排序和开微波炉三项真机任务中,与OpenWAM使用相同示范数据训练。改变灯光、干扰物及物体外观或摆放的测试中,PrismWAM合并成功率为68.6%(24/35),OpenWAM为48.6%(17/35)。这是有限任务和试验次数下的作者结果;原始场景的微波炉任务仍是OpenWAM表现更好,不能据此推断全面领先。
对机器人软件开发者,值得借鉴的是让目标理解与几何演变预测承担不同职责,并让动作生成读取深度演变特征,而非必须生成未来彩色画面。
证据为作者论文实验,不是独立复现。该方法需要当前深度输入;同步深度真机数据的规模仍受限,真机结论仅覆盖三项任务。
 2026-10-21 · arXiv · 作者论文KITE:分开学习交互意图与硬件动作,迁移操作任务
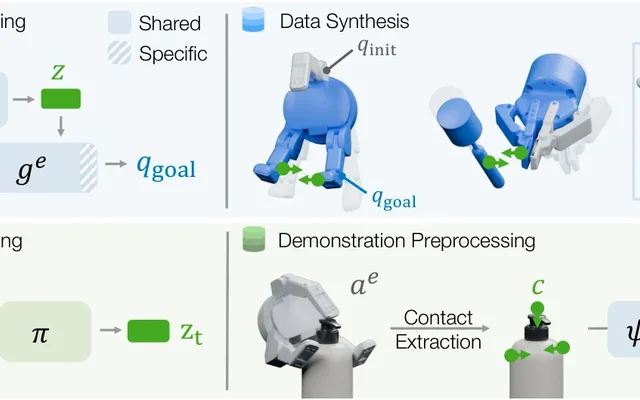
让夹爪演示的物体放置任务交给灵巧手执行,不能只照搬关节动作。作者提出KITE(跨本体运动学交互迁移),把“怎样接近、接触和操纵物体”与“这台机器人怎样运动”分开学习,供不同硬件复用任务策略。这里的零样本指不使用目标机器人的任务示范,并非无需适配。
交互策略从源机器人示范学习,用接触位置和表面朝向表达交互意图;运动学解码器则利用各机器人运动学模型生成的合成数据训练,把意图转成目标关节配置。新增本体时,保持意图编码器和任务策略不变,用新旧本体的合成数据微调解码器组。对开发者,这提供了把任务学习与硬件适配分开的接口。
作者仿真实验覆盖四项任务、六种机器人本体;真机将机器人和人手示范迁移至Wuji手,使用冻结解码器,未做目标任务示范训练或真机微调。其中,人手示范的泵瓶任务报告成功率为60%,每项真机任务仅测试10次。这些是作者实验,不是独立复现;目标必须能实现源接触模式,方法不为新硬件发明新策略,也不能仅靠运动学监督消除软垫、腱和线缆引入的仿真到真机差异。
对本体软件开发者,价值在于明确任务策略与硬件动作实现的分工:已有交互策略可以保持不变,新增硬件的适配集中在运动学解码器组,而非重新采集目标任务示范;这仍需要目标运动学模型及相应训练。
证据为作者论文实验,不能视为独立研究复现或已验证的部署成效。真机每项任务仅10次试验,物体放置和泵瓶各使用一个与仿真实例几何相近的物体。目标无法实现源接触模式的任务不在适用范围内;方法迁移已有策略,不生成适合目标形态的新策略,运动学监督也未覆盖软垫顺应性、腱松弛和线缆耦合造成的差异。
 2026-10-17 · arXiv · 作者论文HydroShear:用于触觉仿真到现实强化学习的水弹性剪切仿真
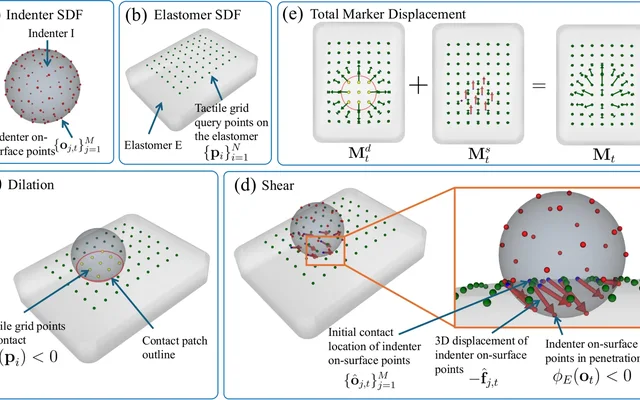
插销入孔、把书插进书架或拉动受扰动的抽屉时,机器人需要利用指尖触觉判断接触和滑动。作者提出HydroShear,针对触觉图像仿真重外观、轻受力的问题,改为模拟剪切如何随接触历史累积,以及黏着到滑动的转换,用于在仿真中训练强化学习控制策略,再迁移到真机。
方法用有符号距离函数表示物体几何,跟踪物体表面点相对传感器软膜的运动,覆盖三维平移和旋转,而非仅考虑平面运动。策略全部在Isaac Gym中训练,部署时无需修改或微调;但仿真模型仍需用真实传感器数据标定。
作者在配有双GelSight Mini视觉式触觉传感器的Franka Panda上测试插销、装箱、书籍上架和拉抽屉,每项30次。HydroShear合计成功112/120次,摘要报告平均成功率93%;触觉灰度图像基线为41/120次,作者改进重实现的FOTS触觉仿真基线为73/120次。这些是论文内各任务分别训练策略的比较,不代表单一策略掌握全部任务。
适用条件也有限:当前模型假设传感器软膜平坦,并依赖底层物理引擎支持穿透式接触仿真。
对触觉控制开发者,这项工作提供了以接触历史和滑移建模改进仿真到真机迁移的路线;工程接入需同时考虑真实数据标定与底层接触模型。
证据为作者论文实验,不应视为独立复现。当前结论限于文中任务与传感器设置;其他触觉传感器未评估,可变形物体可能需要替代几何表示。
 2026-10-21 · arXiv · 作者论文FlowVLA:学习流动感知的物理完成状态,用于机器人定量倾倒
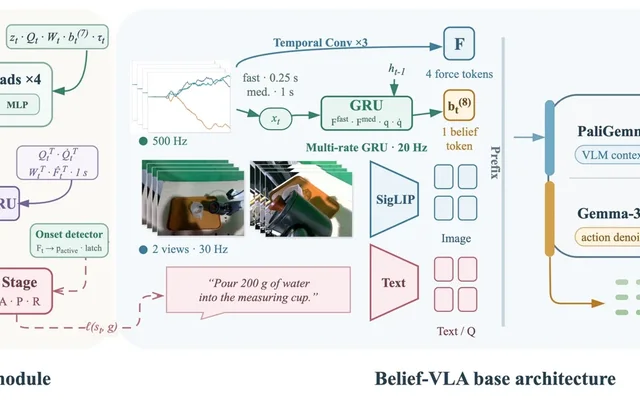
机器人按要求倒水时,画面和手臂姿态可能几乎不变,倒出的水却持续增加;把壶回正后,液体也不会立即停止流出。作者提出FlowVLA,将动作生成与倒出量估计分开,让视觉—语言—动作(VLA)策略不再独自隐式判断何时停止。
系统融合图像、关节、腕部力与力矩及历史状态,持续估计流量和累计倒出质量;当累计质量加上预计回正期间流出量达到目标时,触发回正。动作学习还专门区分继续倾倒与开始回正的阶段边界,避免同一段动作混入两种运动。
在咖啡壶倒水、目标为100/200/300克的作者实验中,已完成且记录最终质量的试验,按目标等权平均的绝对误差为13.1克;以全部尝试为分母,完成任务且质量落在目标±10%内的比例为53.7%。同一模型无需重训即可测试未参与训练和调参的150/250克目标,但这只是目标范围内插值。执行时不使用电子秤反馈,训练监督和最终评测仍依赖电子秤;其他容器与液体任务分别训练模型。
对控制软件开发的启示是:可将“怎么动”与“倒够没有”分开建模,并把回正后仍会流出的液体计入停止条件;这是作者实验支持的设计思路,不是通用部署能力证明。
证据来自作者论文,不能视为独立复现。方法仍需分容器—液体域训练和离线电子秤监督;质量误差仅统计已完成且有最终质量记录的试验,不能代替全流程成功率。
让机器人把冷冻食品投入热油,视频预测是否只展示烹饪动作,却漏掉剧烈飞溅等危险后果?作者提出ICAT(基于事故案例的自适应测试),检查以参考图像为起点生成视频的世界模型,能否预测危险操作的后果,而不只是复现动作,为开发者审查用于规划或学习的生成轨迹提供诊断工具。
方法将事故报告和安全指南整理成可追溯的结构化风险记忆,按场景及机器人能力约束生成测试,再由人工核验参考图像。909个测试单元包含初始条件、触发动作和后果;输入只给图像与动作要求,不透露预期后果。指南推导的案例不算真实发生的事故。
作者对六套系统人工评分,每个测试收集八段返回视频后择优。Veo 3.1的完整风险链严格成功率为13.3%;在保留场景且完成触发动作的515个单元中,后果达标比例为23.5%。这反映了动作复现与后果生成之间的缺口,不是现实事故概率。结果包含服务端干预,Sora 2还采用重试和改写提示流程,不能据此作同输入的纯模型排名;短视频也可能截断后果。
对将生成视频接入机器人规划或策略学习的团队,ICAT提供了分开检查“场景是否保留、动作是否完成、危险后果是否出现”的诊断思路,而非只凭视频看起来合理判断可靠性。论文未测量遗漏后果对下游决策的实际影响。
这是作者论文结果,不是真机安全验证或部署认证。八选一偏乐观,各系统条件子集不同;触发完成后的剩余视频时长未量化。论文仅计划发布资产,尚未提供公开发布链接或完整来源许可清单。
 2026-10-19 · arXiv · 作者论文弗雷歇强制:用短片段训练长时域流式世界模型
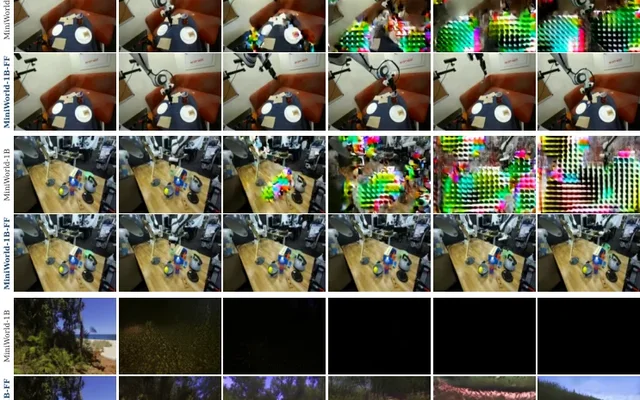
在按机器人指令生成操作视频、按相机轨迹生成探索画面时,流式世界模型会把先前生成的画面继续作为输入;短片段训练留下的预测误差因此不断累积,出现纹理破坏或画面变黑。作者提出弗雷歇强制,改变微调时的监督方式,目标是让短视频训练出的模型持续生成更长、仍响应动作的视频。
方法将模型与部署时使用的采样器一同微调,不改模型架构或采样器。训练同时约束三件事:用含自身预测误差、但以真实片段结尾的历史学习后续生成;用弗雷歇距离衡量生成与真实数据的统计差异,分别保持原场景特征和画面真实感。训练不需要教师模型、在线判别网络或长视频。
作者在机器人操作数据集DROID和相机控制探索数据集Sekai上,用381帧片段、至多36个图形处理器小时微调MiniWorld-1B,报告生成在超过4,000帧后仍保持稳定并响应动作。DROID末段相对回放参考的峰值信噪比,即图像保真度指标,为21.5分贝,基础模型为8.9分贝。
这些是作者的视频生成实验,不是真机任务成功率;DROID长程参考由片段正反向回放构造,并非连续实录。
对动作条件视频模拟器开发者,这提供了一条保留现有架构和采样器、通过短片段微调抑制长程视觉漂移的路线,而非新增机器人控制策略。
验证仅覆盖两个领域和一种模型规模;DROID评测片段参与过预训练,回放参考也只是近似。总体统计稳定不代表每条视频无瑕疵:作者人工检查中,4,000帧时无可见伪影的DROID生成序列占79%;方法也不保证久后重访场景仍一致。
 2026-10-20 · arXiv · 作者论文在关键处学习:面向局部接触密集操作的自主数据采集与离线强化学习
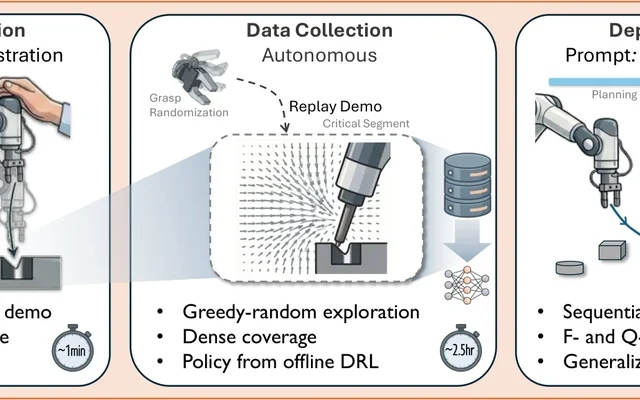
把盐盒塞进拥挤货架、叠紧乐高积木或装好风扇盖,难点不只是抓取和搬运,而是接触后的精确对齐与插入。作者提出只学习关键接触段:抓取和搬运仍交给位姿估计与运动规划,局部策略负责修正残余定位误差,为开发者提供规划与学习模块的组合方案。
采集先由人手把手带机器人完成一次含场景复位的示范,再在固定布局中回放至接触区域,混合朝目标移动与随机探索,收集成功和失败轨迹。随后用离线强化学习,即利用已采集数据训练策略。部署时,接触力触发局部策略,学习得到的动作价值估计用于判断插入是否完成。
作者在货架补货、乐高堆叠、风扇盖装配及其困难版本上评测,每个策略运行50次。四项任务平均完整成功率为96%,纯位姿估计与规划为55%,所测最强端到端基线为37%;这里的成功要求完成插入或装配,而非仅摆放到位。
这些结果来自作者真机实验。自主采集依赖固定场景,复位不正确时仍需人工介入;靠近插入点的干扰物也可能使局部策略失败,不能据此推断任意场景下的装配能力。
对操作软件开发的启示是保留抓取、搬运的规划流程,把数据采集与学习集中到精密接触段,并明确接触触发、完成判断等模块接口,而非必须端到端重训整个任务。
证据为作者论文实验,不作为独立复现结论。采集要求场景布局保持不变,仍有复位干预;近距离视觉干扰会导致失败。比较仅限文中任务与基线设置,不代表通用操作能力排名。
 2026-10-21 · arXiv · 作者论文SimPT:用于干预式视觉—语言—动作模型后训练的自动化仿真框架
机器人插网线等操作出错后,通常需要专家接管、收集纠正动作,再更新策略;人工监督和反复真机评测限制了算法开发。作者提出SimPT,将视觉—语言—动作(VLA)模型的策略执行、纠正数据采集、后训练与独立评测串成自动化仿真流程,供开发者在硬件实验前探索算法。
核心是任务进度图与状态快照:语言模型智能体预先生成并验证进度图,运行时读取仿真器内部状态、记录任务阶段和稳定快照。执行失败后,基于CuRobo的程序化专家先从较后阶段恢复,不成功再回退,保留成功纠正轨迹。在七项RoboTwin操作任务的独立采集中,相比固定间隔快照,恢复尝试总数减少75.0%。
作者还用该框架改进RECAP后训练方法,以交叉拟合避免用同一批轨迹训练并预测价值,再用低通滤波平滑预测。每个版本各进行1,400次留出仿真测试,成功率由76.50%升至79.36%;真机网线插入的25种场景中,由72%升至96%。真机后训练仍使用人工纠正;仿真独立评测则不使用进度图、恢复专家或仿真器内部状态。
对策略开发者,价值在于把失败后的纠正数据采集与算法对比放进可控仿真流程;真机验证的是由此开发的训练改进,而非自动恢复机制直接部署到真机。
证据来自作者论文,不能视为独立复现。结果限于所测任务与场景;进度图采集依赖仿真器内部状态,真机测试仍有人参与后训练,不能据此推断通用自主恢复或部署效果。
 2026-10-22 · arXiv · 作者论文CENIC:面向接触的凸误差控制数值积分
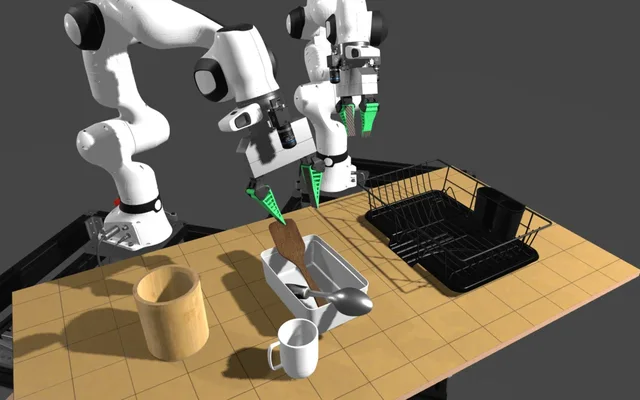
机器人把薄物体倒入塑料箱、再倾倒到金属丝碗碟架时,仿真容易出现穿透和抖动;固定步长太小又会拖慢运行。作者提出CENIC,让开发者设定目标精度而非固定步长,由积分器自动调整时间步,减少手动调参。
方法把凸优化接触求解与误差控制结合:比较一个完整步和两个半步的结果,估计误差;重点检查位置,避免碰撞瞬间的速度突变迫使仿真持续使用小步长。它还将用户定义的控制器等外部系统纳入隐式积分,即把下一时刻的反馈作用一起求解,以应对高增益控制带来的快速变化。
作者在碗碟架任务中回放真机记录的关节轨迹,用高增益比例—微分控制器跟踪。目标精度为10⁻³时,论文报告消除了视觉上明显的数值伪影,实时率为342%,即模拟时间与实际耗时之比;固定步长需降至1毫秒才消除明显伪影,此时实时率为21%。结果使用单个中央处理器线程,真机与仿真仅定性相似、轨迹并不完全一致;这不等于已验证仿真到真机迁移收益。
对接触仿真开发者,价值在于把步长调参转为精度设定,并区分数值求解误差与建模误差;作者认为其更适合离线仿真。
证据为作者论文实验,不是独立复现。方法不保证薄物体绝不穿透,也不保证固定实时率;接触参数仍需合理选择,仿真到真机迁移效果尚待系统验证。
 2026-10-16 · arXiv · 作者论文OxyGen:多任务并行下视觉—语言—动作模型推理的统一键值缓存管理
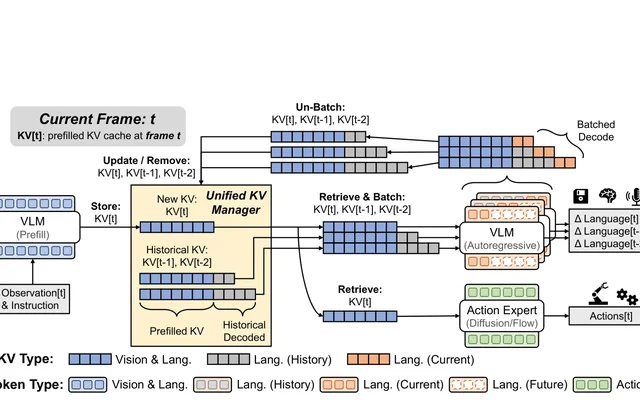
机器人边操作物体边生成文字记忆时,动作要按控制周期更新,文字可以跨周期完成。作者指出,现有系统将两项任务分开推理,会重复处理同一观测并争抢算力。OxyGen面向多专家视觉—语言—动作模型(VLA),改变的是推理运行时的缓存与调度方式,为端侧并行动作和语言任务提供优化路径。
其核心是统一管理键值缓存(KV缓存):同一观测只编码一次,结果供动作和语言模块复用;再将不同控制周期中尚未完成的语言请求合批,在每周期限定的解码步数内推进,保存状态后续接,而非等整段文字生成完再更新动作。
作者在π₀.₅模型上报告:相同输出长度下,相比逐项顺序执行,动作生成频率和语言总吞吐量提高至1.2—3.7倍。搭载Jetson AGX Thor的人形机器人实验中,动作与语言路径合计耗时由1030毫秒降至393毫秒;该设置每次生成10个动作、使用10步动作去噪,语言请求长30个词元,每周期解码5步。收益存在取舍:减少每周期语言解码步数可提高动作生成频率,却可能延长单条语言请求的完成时间。
对本体推理软件开发者,价值在于复用共享观测的计算,并让辅助语言任务跨控制周期推进;作者已基于openpi实现JAX和PyTorch后端。
结果来自作者论文实验,不是独立复现。当前实现使用固定的每周期解码步数;评估主要针对动作与语言并发,更多输出模态及端到端真实闭环应用仍待验证。
 2026-10-21 · arXiv · 作者论文λ₀:规模化开放世界第一视角人类数据,用于人形机器人移动操作
搬运箱子、把瓶子投入垃圾桶,需要机器人协调行走、姿态和抓取;只学手部轨迹不够,逐次遥操作采集又成本较高。作者提出λ₀及HumanVerse数据集,把人类第一视角视频与身体、手部运动转成机器人训练监督,补充昂贵的机器人示范。
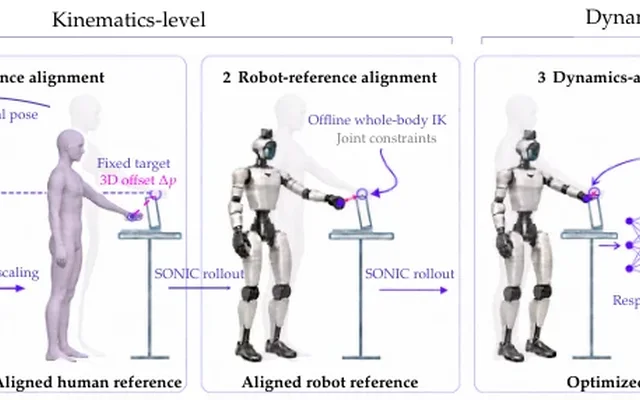
HumanVerse包含500小时原始采集数据,并非转换、有效性过滤后的时长。方法先匹配人与机器人的相机视角,把画面中的人臂替换为机器人手臂;再离线修正动作参考和控制器输入,处理体型差异与执行误差。λ₀依次学习手部运动、全身人类动作,最后用机器人数据适配;部署时不需要人类运动数据流。
作者在宇树G1上报告:投瓶、收玩具、搬箱和摆椅四项真机任务,每项使用十个固定初始配置,平均成功率为62.5%。固定机器人示范和后训练预算,增加全身人类数据时,按阶段完成度计分的平均任务进度从59.9%升至80.4%;这不是成功率。完整λ₀仍使用机器人后训练,不能把另一组无需目标任务机器人示范的迁移实验条件套用到这一结果。
对数据与控制软件开发者,这提供了把可穿戴采集的人类动作接入机器人状态—动作接口的路线:先离线对齐,再训练策略,而非直接回放人体轨迹。
结果属于作者实验。真机评测每任务十次,未报告基于训练种子的置信区间;500小时是过滤前口径。文中的SIMPLE仿真汇总按任务选择最佳配置,不能视为固定配置下的统一排名。
 2026-10-17 · arXiv · 作者论文StopWatch:面向物体目标导航的目标锚定
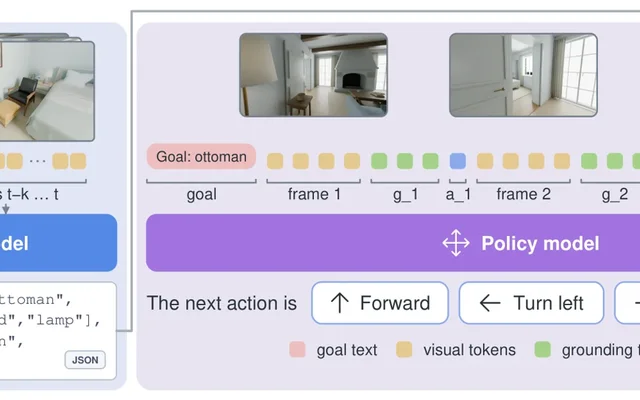
让机器人在陌生室内找到指定类别的物体并停在附近,难点不只是搜索。StopWatch作者发现,基于视觉语言模型的导航策略常已接近目标,却没认出目标或判断好距离,因而继续走过。此次改变是把目标锚定——判断目标是否在视野内、离它多远——显式交给策略,而非只靠动作示范隐式学习。
系统将感知与动作决策拆成两个独立训练的模型:感知模型从图像预测可见物体类别和目标距离,写成结构化文本;策略结合图像历史与文本选择动作。训练文本来自场景的语义和几何标注。对开发者,这个可检查的接口有助于区分感知错误与动作决策错误,感知也可独立改进。
作者报告,在修正标注后的HM3D-OVON未见目标类别验证集上,成功率为69.6%,比同协议下的LightNav-0高8.8个百分点。这里的修正包含合并等价名称、人工审核并剔除有问题的评测回合;不是直接沿用官方分数。实验仅覆盖静态室内仿真,尚不能据此认定真机部署收益。
为导航软件提供可检查的感知—策略接口:先定位“没认出目标”还是“决策没停下”,并可在不重训策略的情况下改进感知。
证据为作者论文实验,且仅在静态室内仿真中评测;训练依赖带语义和几何标注的三维场景。修正协议的成绩不能与官方协议分数混排。
 2026-10-20 · arXiv · 作者论文AWLS:面向单步生成式机器人操作策略的优势加权潜空间引导
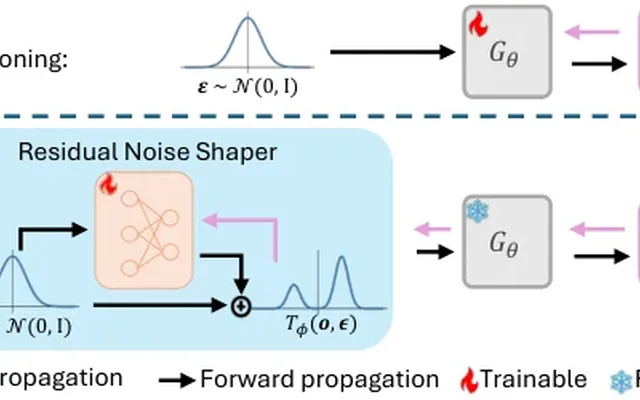
机器人学习开抽屉放方块、插管等任务时,成功的人类示范也可能包含停顿和绕路;直接模仿会一并学到这些低效动作。作者提出优势加权潜空间引导(AWLS),在已有策略上做离线后训练,让策略更偏向示范中的较好动作,不更新原有动作解码器。
方法只训练一个根据当前观测修正潜在噪声输入的模块。“优势”表示示范动作相对当前状态基准的估计价值,经尺度归一化后,仅作为动作重建训练的权重,不让价值评估器的梯度直接引导策略。作者还通过离线噪声扰动检查,选择仍能响应噪声变化的预训练检查点。部署时移除价值评估器,保留一次解码生成动作片段。
作者在五项真机任务中,每项使用70条遥操作示范训练,每种策略各测试20次;成功要求无人干预完成全部阶段。采用MeanFlow解码器的AWLS合计成功65/100,冻结基座为45/100。按任务分层并校正多重比较后,只有相对冻结基座的总体提升显著,相对其他后训练基线的优势尚属提示性结果;后训练阶段未采集真机执行数据。
为已有单步操作策略提供一种保留解码器的离线适配路径;部署端无需保留价值评估器,也不引入迭代去噪或候选动作筛选。
证据来自作者论文实验,不是独立复现。方法依赖价值评估器有效排序,只能偏向数据中已有且冻结解码器可达的行为,不用于创造新技能;重建训练也可能降低动作多样性。
 2026-10-19 · arXiv · 作者论文学习任务,而非时序安排:减少双臂模仿学习中的虚假跨臂耦合
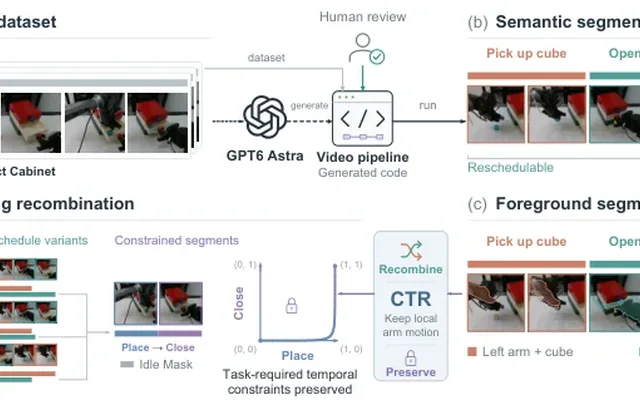
双臂机器人各自分拣字母时,一只手暂停,本不应让另一只手跟着等;但若示范总按固定顺序执行,模型可能把对侧进度误当成行动条件。作者提出约束保持时间重组(CTR),改变训练数据中的双臂时间安排,让策略少学示范者的偶然习惯,同时保留开抽屉后才能放入物体等必要配合。
方法将各臂记录切成片段,保留原有感知、动作内容和片段时长,在任务约束允许范围内调整开始时间,不新增示范。对真实机器人数据,还需合成主相机画面,并屏蔽重组引入的人为等待所对应的动作监督;无需改变策略架构或部署流程。
作者在四项仿真和四项真机任务上测试三类策略。使用π₀.₅策略进行真机字母分拣时,在六种双臂进度初始状态中,CTR的最低成功率为76%,只混合典型时序的基线为56%;每个状态评测50次。这说明收益不仅体现在标准起点。但方法依赖任务专用处理与约束,合成画面也只是近似,不能据此认定任意重组都能在真机安全执行。
对双臂策略开发者,这提供了一条不改策略架构、从训练数据时间安排入手减少无谓等待的路线;目标不是让双臂完全独立,而是在需要配合时仍保持依赖。
结果属于作者论文实验,诊断仅覆盖特定跨臂关系。处理流水线出错可能生成无效重组,物理与观测检查不构成闭环执行保证;摘要仅预告将发布代码,不能据此认定工程已公开。
 2026-10-19 · arXiv · 作者论文PhantomTac:利用部署后无需值守的标签劫持机器人触觉系统
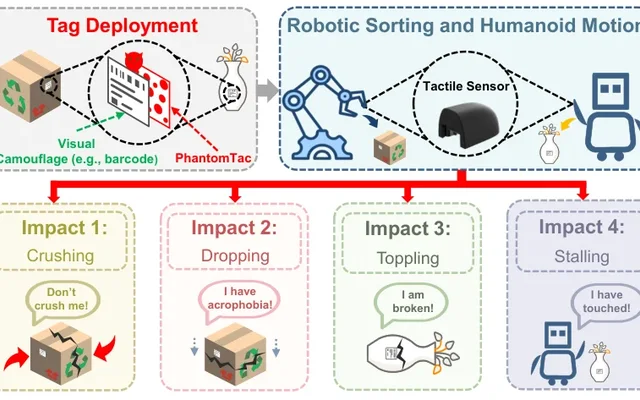
机械臂搬运纸盒时,需要根据接触力调节夹爪,既不能夹碎,也不能松脱。PhantomTac作者报告:无需侵入机器人软件,只需在物体预期接触区域贴上磁性标签,就能欺骗磁式触觉传感器,干扰依靠力反馈实时调整动作的闭环控制。这把安全检查的关注点从机器人自身扩展到了待抓取物体。
方法利用外部磁场被误当成接触力的漏洞:近距离磁场在传感器阵列中分布不均,无法被原有的相邻读数相减机制充分消除。作者先离线测量同型号传感器的响应,再设计无需电池、磁体厚约0.5毫米的标签,可藏在普通贴纸下。
在作者的机械臂纸盒搬运实验中,虚增垂直接触面的力读数会让夹爪过早认定抓稳,造成掉落;压低读数则使夹爪继续收紧,挤坏纸盒。针对虚增读数的测试,在四个指定方向、各偏移距离分别进行20次抓取时,偏移不超过8毫米,攻击成功率高于95%。该结果限于论文实验配置,不能泛化到任意抓取。作者另提出将触觉与电机电流、关节力矩等信号交叉核对的防御思路。
对本体软件开发者,论文提示应检查触觉反馈与电机负载、运动状态是否一致,而不只依赖单一触觉阈值;这是作者提出的防御方向,并非已验证的部署效果。
结果来自作者的受控实验,不作为独立复现结论。确定性力注入仍需针对传感器型号离线表征与定制标签;不直接适用于纯光学、电容或电阻式触觉传感器。作者声明开放的材料不含完整型号专用标签设计与部署参数。
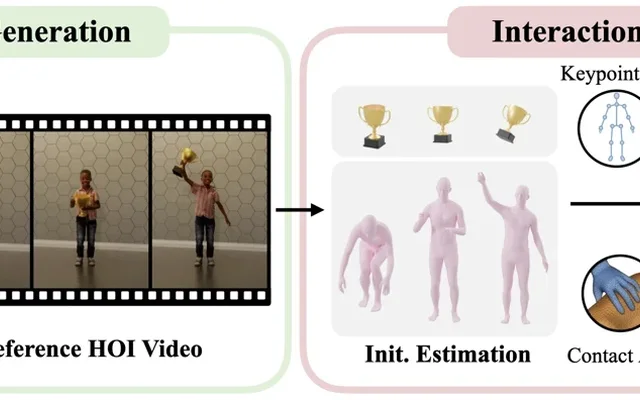 2026-10-19 · arXiv · 作者论文GRAIL:从世界模型生成人形机器人移动操作
让人形机器人走近物体后拾取、或登上楼梯,需要机器人可执行的动作示范;遥操作和动作捕捉依赖实体布景与人工采集。GRAIL将示范生成移到虚拟环境,为仿真训练和真机迁移提供数据,避免反复搭建实体场景或遥操作机器人。
关键改变是先确定三维场景,再生成交互视频:物体几何、相机、尺度、环境深度和接近机器人比例的人物均预先已知。系统据此恢复随时间变化的人体与物体三维轨迹,联合修正深度和接触关系,再将动作映射到机器人。操作任务用适配模块补充物体感知和手部动作;地形任务用局部高度图微调整身控制器。
作者生成了超过20,000条序列,涵盖拾取、全身操作、坐下和地形穿越,并用生成数据训练第一视角视觉策略。在宇树G1真机拾取评测中,每种物体测试10次,5种已见物体的平均成功率为84%,5种未见物体为80%;爬楼梯成功率为90%,所给材料未说明其试验次数。部署依赖连接桌面显卡计算机,并非纯机载运行。这些是作者论文实验结果,不是独立复现,也不能外推为任意物体、地形下的通用能力。
对开发者的价值是提供一条从已知三维资产生成动作参考、转成机器人动作数据、再训练视觉策略的路线;作者将其定位为遥操作和动作捕捉的补充,而非替代。
流程依赖三维资产、可仿真的场景及遵循交互要求的视频模型;严重遮挡、快速运动或外观不一致会降低重建质量,部分序列需丢弃。动作类别明显变化时仍需训练或微调。拾取的逐物体试验次数不能套用于爬楼梯;真机结果属于作者论文证据,不是独立研究复现。


工程关注点是数据、训练、运行时与参考本体之间的接口和工作流。公告可作为工具链选型与接入评估的线索,但不代表集成收益或机器人通用能力已经得到独立验证。
证据为厂商官方声明,开源状态、可用性与提速均按公告表述,本次未核验工程产物,也没有独立研究复现证据。来源是滚动网页的获取时快照,抓取晚于报告截止时间,首发日期不能证明全部内容在截止前已存在。原文称完整 Human 1M 数据向 Cosmos Coalition 合作伙伴开放,未明确其他访问途径。