Ego2Sim2Humanoid:把第一视角眼镜录像转成经物理验证的人形机器人移动操作训练数据
要解决的是人形机器人移动操作(边走边操作)策略的训练数据来源。以往这类数据靠遥操作真机示范采集,每条都要一名受训操作员实时操控真机并穿着可穿戴动捕设备;第一视角眼镜能免掉机器人,但只跟踪头部和视野内的手,人机身高、臂展和手部形态不同,照搬动作产生不了可行接触。
展开阅读 具身图谱在图谱中把握具身智能
本期选出的进展集中在三处:训练数据来源从遥操作真机转向第一视角人类视频;接触与力开始被当成可观测信息接入策略与感知;相机偏移、新约束和接触失败这类现场偏差,则被放进决策回路就地修正,不必重训已有模型。
要解决的是人形机器人移动操作(边走边操作)策略的训练数据来源。以往这类数据靠遥操作真机示范采集,每条都要一名受训操作员实时操控真机并穿着可穿戴动捕设备;第一视角眼镜能免掉机器人,但只跟踪头部和视野内的手,人机身高、臂展和手部形态不同,照搬动作产生不了可行接触。
展开阅读人形机器人开圆形门把手,失败往往不在对准几何,而在于多指能否建立摩擦接触、能否在不滑移前提下产生足够扭矩、推门时能否控力并保持平衡。这些接触状态在视觉和本体感知里几乎看不见:接触刚稳住与即将打滑时的观测可能一样,动作相同结果却不同。Amazon 与 Rice University 等机构提出 TMA(触觉驱动的电机自适应),把触觉历史当作推断接触条件的信息源,全程只在仿真训练,零样本迁移到装配 BrainCo Revo2 多指手的 Unitree G1 真机。
展开阅读要解决的问题很具体:学习出来的仿真器(原文称 world model,即世界模型)可以在没有真机的情况下打分,例如看它的预测与已记录数据偏离多少。但这类分数能否说明“完全在该仿真器里训练出来的行走策略(policy)真的会走”?一位独立研究者对 Robotic World Model(RWM,arXiv:2501.10100)及其不确定度感知后继 RWM-U(arXiv:2504.16680)做了这项独立研究;模型卡写明该研究与原作者、Robotic Systems Lab、ETH Zurich 无关联,也未经他们认可或审阅,研究所依赖的 RWM 动力学复现另在单独仓库中。
展开阅读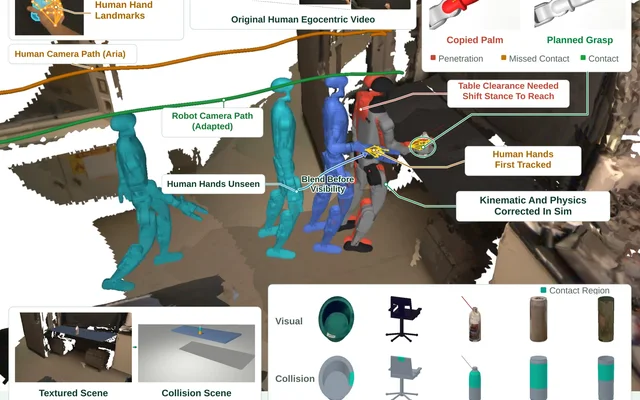 2026-11-14 · arXiv · 作者论文Ego2Sim2Humanoid:把第一视角眼镜录像转成经物理验证的人形机器人移动操作训练数据
要解决的是人形机器人移动操作(边走边操作)策略的训练数据来源。以往这类数据靠遥操作真机示范采集,每条都要一名受训操作员实时操控真机并穿着可穿戴动捕设备;第一视角眼镜能免掉机器人,但只跟踪头部和视野内的手,人机身高、臂展和手部形态不同,照搬动作产生不了可行接触。
Ego2Sim2Humanoid(E2S2H)把眼镜录像转成经物理验证的机器人训练轨迹:智能体分阶段重建碰撞体与贴图网格,必要时补全未观测表面,并在被操作物体上定位目标接触带;抓取规划把接触带转成可行的机器人腕姿与手指闭合,双层优化规划无碰撞且手部可达的站姿,全身运动生成器补出下肢行走与视野外的手臂动作;再以运动学方式混合可见性切换,并在物理仿真中用智能体设计的语义奖励训练强化学习跟踪策略,物体移出画面后仍能完成操作阶段。图像、本体感知和动作都来自同一条仿真轨迹,视觉与控制不需要另外对时。
采集只用 Aria Gen 2 眼镜、不用机器人和动捕:抬瓶任务 219 段、戴帽任务 154 段,各配一条语言指令;过筛后分别剩 189 段和 59 段,主因是帽壁只有几毫米厚,抓取碰到帽子却夹不住。真机是 29 自由度 Unitree G1,配 Dex3 灵巧手和头部相机。只用转换数据微调 GR00T N1.7(3B)、不用目标任务的真机数据:抬瓶 20 次自主试验成功 9 次(45%),戴帽 20 次成功 5 次(25%),失败集中在抓取环节。
作者用两个基线的公开代码在同批戴帽录像上做对比:EgoHumanoid 与 EgoHumanoid-V2 的路径比例中位 0.5–0.6、手距接触区中位 70.8–112.9 厘米、可行抓取数为 0;E2S2H 的路径比例为 0.9、手距 0.8 厘米,71 段中 57 段找到可行抓取(完整版 EgoHumanoid-V2 只在其完成的 8 段留出录像中的 6 段上评估)。复制人手掌的对照显示:71 段里有 65 段,复制人手掌让拇指和食指陷进帽壁更深,穿透中位从 0.8 厘米升到 1.8 厘米;两者成功次数接近(56 比 53),差别在接触质量而不是成功率。
人形机器人开圆形门把手,失败往往不在对准几何,而在于多指能否建立摩擦接触、能否在不滑移前提下产生足够扭矩、推门时能否控力并保持平衡。这些接触状态在视觉和本体感知里几乎看不见:接触刚稳住与即将打滑时的观测可能一样,动作相同结果却不同。Amazon 与 Rice University 等机构提出 TMA(触觉驱动的电机自适应),把触觉历史当作推断接触条件的信息源,全程只在仿真训练,零样本迁移到装配 BrainCo Revo2 多指手的 Unitree G1 真机。
做法三层:奖励只承认“拇指加至少两根对向手指压住旋钮边缘”这类可触觉观测的进展;每指三维触觉力按摩擦锥拆成法向载荷、锥角和剪切方向;适配编码器再从最近约 2 秒触觉历史回归出隐变量,在线更新并驱动策略。上半身操控右臂与手,下半身交给冻结的预训练行走控制器维持平衡。仿真用 PPO 在 8192 个并行环境训练,物理 200Hz、策略 50Hz。
真机用四种市售圆形把手,每种 10 次、不做真机微调。TMA 开门成功/抓取成功为 8/9、6/8、6/7、7/8;不用触觉的 RMA 为 0/1、0/0、0/0、0/0,只用二值接触三帧的反应式策略为 3/7、1/6、0/4、2/6。仿真消融中完整锥坐标信号最好,抓取 91.3%、开门 80.9%,换二值接触或只留剪切分量都更差。
限制也清楚:只有这一类门把手、一个本体、每旋钮 10 次试验;旋钮位姿靠 AprilTag 估计,边缘还贴胶带增摩;库仑摩擦限定剪切力上限,法向力不足时所需扭矩物理上不可达,指端垫损坏后性能明显下降。作者说明这是研究实验,不代表生产部署。
给机器人本体与控制软件工程师的用处在于两点:一是把触觉从“有无接触”的开关信号升级为带方向的力信息(法向载荷、锥角、剪切方向),二是用约 2 秒的触觉历史做在线适配,让策略在接触条件未知时自己调整发力方式。门把手这类接触主导任务可以纯仿真训练后零样本上真机,省掉真机数据采集与微调环节;但结论目前只覆盖该任务、该本体和很小的试验规模。
证据来自作者论文与实验报告,无独立复现。覆盖面窄:单一任务类型(圆形门把手)、单一本体(Unitree G1 + Revo2)、每旋钮仅 10 次试验;旋钮位姿依赖 AprilTag 外部定位,旋钮边缘贴胶带增摩也影响了接触条件。指端垫损坏后性能明显下降,说明结果对硬件状态敏感。作者明确声明为研究实验,不代表生产部署。
要解决的问题很具体:学习出来的仿真器(原文称 world model,即世界模型)可以在没有真机的情况下打分,例如看它的预测与已记录数据偏离多少。但这类分数能否说明“完全在该仿真器里训练出来的行走策略(policy)真的会走”?一位独立研究者对 Robotic World Model(RWM,arXiv:2501.10100)及其不确定度感知后继 RWM-U(arXiv:2504.16680)做了这项独立研究;模型卡写明该研究与原作者、Robotic Systems Lab、ETH Zurich 无关联,也未经他们认可或审阅,研究所依赖的 RWM 动力学复现另在单独仓库中。
检验覆盖 19 个仿真器(原作者发布的模型,加上 18 个按不同微调量得到的版本),判定规则事先预注册。策略既不在真机、也不在原作者的 Isaac Lab 仿真器中测试,而是在按 ANYbotics 公开描述(BSD 3-Clause 许可)用 MuJoCo 重建的 ANYmal D 四足模型上测试,电机模型按记录的关节力矩拟合。
结论是未定。18 个微调版本的一步与八步预测都比发布模型更准;原文写这两项分数“把行走排序排反了(ranked walking in reverse)”,并给出约 −0.4 的 Spearman 秩相关,但原文没有说明该系数对应哪一对量,也没有真机对照可作基准,因此只能读作“仿真内的预测精度分数与行走测试结果排序不一致”,不能当成有真机基准的定论。18 个版本中 13 个按注册规则计为失败。把原作者自己的行走策略放进各仿真器运行这一项次要测试,排序表现良好(+0.79)。
对开发的用处主要在工程产物侧:仓库按研究脚本预期的 runs/... 路径摆放 490 个文件、596 MB,除各次运行的仿真器与策略权重外,还包含压缩变体下的策略(fp16 数值取 16 位精度、int8w 权重取 8 位、u10–u50 按 10%–50% 比例置零权重、s192/s128 把循环层裁到 192 或 128 单元);研究里从零训练的仿真器(Option C,使用 10,000 或 6 million 条 MuJoCo 转移数据)未通过行走测试。
给做本体软件与仿真评测的工程师:仿真器的预测精度不能直接当作“策略会走”的证据,需要另加策略闭环测试作为另一类证据;同时要分清证据层级——在仿真器里闭环跑一遍策略仍不等于真机验证。本次材料里全部结论都止步于 MuJoCo 仿真内。
全部测试在 MuJoCo 中进行,没有真机验证;模型卡只给出 −0.4 和 +0.79 两个相关系数,未说明前者对应哪一对量,因此不能据此推断与真机表现的关系。秩相关、失败计数等结果由该独立研究者自行报告,材料中没有第三方复现或原作者确认。详细统计表(results/d_stats.txt)与预注册文件在代码仓库中,不在本次取材的模型卡内,因此只能引用卡片上的汇总数字。证据是模型卡在抓取时的快照,页面日期不证明全部文字在报告截止前已存在。
 2026-11-19 · arXiv · 作者论文原地卡住:JEPA 规划器的停滞诊断与补救方法
JEPA(联合嵌入预测架构,预测未来帧嵌入而非像素的世界模型)配合模型预测控制(MPC)从像素直接规划,却常在自己模型本该能完成的任务上失败。既有做法把失败归因于分布漂移下的模型误差并在当前回合更新权重,却从未与规划回路对照。这篇论文沿实际执行的规划回路追查原因。
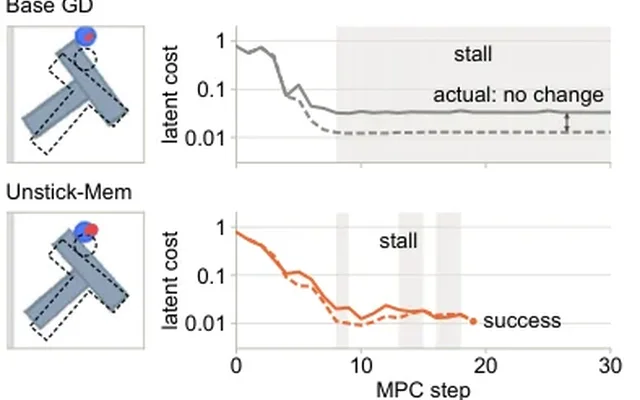
在推物任务上,作者发现不论有无分布漂移,至少 96% 的失败是停滞:物体停在原地,模型却预测出进展;暖启动的梯度下降(GD)规划器随后几乎返回同一个计划,陷入智能体基本空转的不动点。他们提出 Unstick:部署前用规划器自身执行数据做同策略微调,再加一个权重固定的“破环”部件——把本回合预测残差加回预测的残差记忆,或每次重规划随机重初始化。
在 PushObj 与 PushT 上,Unstick 拿到测试时适配方法 AdaJEPA 的大部分收益(四个设置 80% 与 82%,其中 Unstick-Mem 在 14 个设置合计 84%),已见 T 形块的成功率从基线水平明显抬升,部署时不更新权重也不计算参数梯度。开销接近基线:PushObj-T 上每个 MPC 步 7.4 秒(记忆)、6.8 秒(重初始化),基线 6.7 秒,逐回合更新权重的 AdaJEPA 8.3 秒。
收益有边界:视觉漂移下重初始化只拿到 31%;红色方块的失败源于编码器丢失方块角度(R² 由 0.95 降至 0.49),PointMaze 的失败出在规划目标的局部极小值,残差记忆最多只改变 5.3 个百分点。作者建议先在闭环中检查“状态有没有动、计划有没有重复”。
对机器人本体软件工程师的价值:把“卡住”从模型精度问题重新判为规划回路问题,并给出两种不改权重、不算参数梯度的低成本修法——残差记忆与随机重初始化;配套的闭环诊断(看状态是否移动、计划是否重复)可直接当作 JEPA 规划器的调试步骤。
结论只覆盖一个 JEPA 家族、三个基准,且主要针对暖启动 GD 规划;CEM 下残差记忆增益有限。记忆随回合增长,长回合需设上限;同策略微调需要额外准备与评测回合分离的规划器执行数据。编码器丢失角度、目标陷入局部极小的场景(红色方块、PointMaze)两类修法基本无效。
 2026-11-14 · arXiv · 作者论文ActionUNet:冻结 VLA 主干、只改动作头的多尺度微调模块,提升杂乱场景下的鲁棒性
解决什么问题:给已有 VLA(视觉-语言-动作)模型做任务微调时,常见现象是环境里多一个干扰物、换灯光或背景,成功率就明显掉。作者的解释是时间尺度错配——把粗粒度多模态语义直接映射成细粒度动作序列会严重失配,模型因此过度依赖抽象语义,抓不住抵抗局部扰动所需的细粒度时间线索。
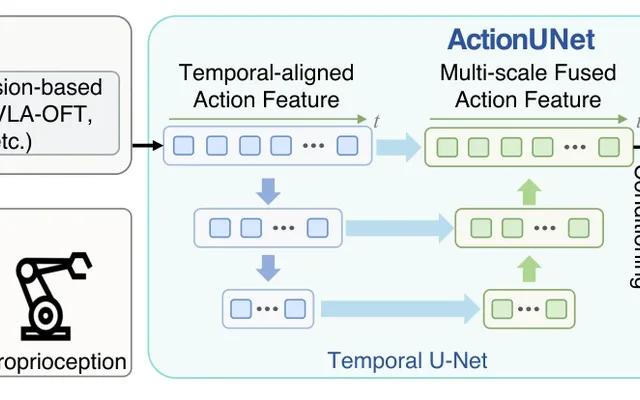
这次改了什么:不动主干。预训练主干冻结,只微调动作专家,动作专家沿用基座原有的训练目标,所以直接回归和流匹配两种策略都能接。第一段改造是在时间对齐的动作特征空间里加一个轻量时序 U-Net,显式编码多尺度先验;第二段是条件 SIREN 解码器(以正弦为激活的隐式网络),把多尺度融合后的动作特征当作条件输入以保持内在时间对齐,并用显式二阶平滑约束保证时间连续性、抑制高频抖动;各局部场再按归一化 Matérn 核加权聚合成连续动作轨迹。
结果(均为作者自报):RoboTwin 2.0 的 12 个任务上(基座 π0.5),easy 设置平均成功率提升 8.8%、hard 设置提升 9.8%;LIBERO-Plus 各类扰动下平均成功率从 65.8% 升到 71.9%;真机双臂评测 easy 从 76.0% 升到 88.7%、hard 从 57.3% 升到 68.7%;消融中补上 Matérn 核后,四个消融任务上为 easy 77.8%、hard 46.5%。代价是策略级单次调用平均延迟从 60.947 ms 变为 64.886 ms。
对机器人本体软件开发者来说,这篇给的是一份“主干不动、只换动作头”的改造点清单:
- 插在哪:预训练主干冻结、只训动作专家,沿用基座原有训练目标,回归式与流匹配式策略都能接,感知与语言侧不用动。 - 改哪里:在“时间对齐的动作特征”上做 U-Net 式多尺度融合,而不是在图像或语言语义层做多尺度,因此不必为不同基座重做感知/语言结构。 - 怎么出动作:把动作块当作连续时间上的轨迹建模,条件 SIREN 出局部场、Matérn 核做加权聚合,二阶平滑约束用于压抖动、保时间连续。 - 部署侧的账:策略级单次调用 60.947 ms(±0.251 ms)→ 64.886 ms(±0.376 ms)。这是纯策略计算口径,论文明确提醒不能当作端到端机器人执行延迟——机械运动、低层控制器约束、安全限速、夹爪动作和接触交互都要另算。 - 选型提示:消融显示补上 Matérn 核后四个任务为 easy 77.8%、hard 46.5%,两段结构需配合使用。
证据性质:所有数字都来自作者论文自报(arXiv 预印本),本次材料中没有第三方独立复现,摘要与正文的提升幅度属于作者自己的口径,不能当作已被独立验证的结论。
评测口径:RoboTwin 2.0 只选其中 12 个任务评测,每个任务用 50 条干净演示训练、按 100 次 rollout 评估,easy 与 hard 的差别在于干扰物、背景、光照、桌面高度和语言的变化;LIBERO-Plus 是模型在 LIBERO 上训练后直接放到扰动环境里评的。样本与任务覆盖有限,不能等同于完整基准上的表现。
延迟口径:附录给出的只是策略计算时间,不含机械执行、低层控制、安全限速与夹爪动作,不能当作整机端到端时延。
改造范围:改动集中在动作特征与动作解码一侧,主干保持冻结。
 2026-11-15 · arXiv · 作者论文ContactGuard:基于动作条件潜空间世界模型的接触前执行监控
接触密集操作里,失败常在夹爪碰到物体之后才被发现:腕部相机虽便于观察接触,但一次偏差的接近可能已经推开、错过、打滑或扰动了物体。ContactGuard 换了个问法——不问“是否已经失败”,而问“即将执行的动作块会不会失败”,并在接触前中止。
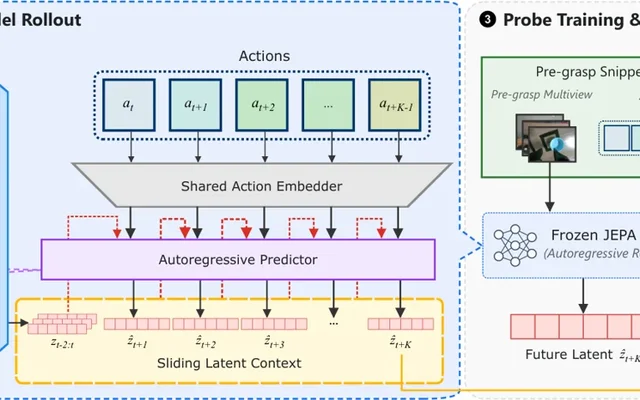
它是一个挂在策略旁的旁路检查器:把分块视觉运动策略(一次给出整段动作块,如 ACT)当黑箱提议者,只读当前观测和策略已输出的动作块,不改策略也不需联合训练。内部用动作条件的潜空间世界模型从无标注轨迹学习多相机紧凑视觉嵌入在动作下的演化,避开像素级视频生成;再用少量标注的接触前片段训练线性探针,只对预测出的“接触后潜变量”打分。部署时在计划闭合前 15 帧(30Hz 即 0.5 秒)锚定,按策略自己的动作滚动 30 步到闭合后 0.5 秒,失败概率超阈值即在闭合前否决。
在 14 自由度 AgileX Piper 双臂、三路同步 RGB 相机上,团队用杯、盒、铅笔、毛巾四个抓取任务评测:AUC 为 0.960 / 0.966 / 0.930 / 0.904,高于同编码器改读当前潜变量的对照(0.829–0.862)与单相机版本(0.890–0.930),盒任务也与直接预测基线接近(0.966 对 0.963)。固定观测、只换动作的反事实扰动显示失败分数随具体动作变化:把失败回合的动作移植到成功回合,失败概率平均上升 0.20–0.54。
条件与边界:最终评测只用每任务 50 次单独采集的真机回合;闭环中机器人在本该中止时暂停 5 秒再续做以记录结局,属代理观测;触发器只覆盖夹爪闭合;中止只是弃权,不自行恢复。
对做本体软件的开发者,它可以当一个策略外的门禁模块:夹爪闭合前先问一次“这段动作块会不会失败”,不行就在接触前否决,底层策略不用改,单卡即可实时(RTX 5090 上完整判别约 22 毫秒)。代价是每个任务要凑一批带标注的接触前片段来训那个线性探针,并针对具体接触事件设计触发器。
只覆盖夹爪闭合这一种触发线索,且仅适用于结果能在下一个动作块内确定的接触事件;中止只是弃权,不会自行恢复或完成任务;闭环数据来自暂停 5 秒后续做的代理观测,不是真实拦截后的成功率;最终评测每任务 50 次单独采集的真机回合,样本量小。全部结果出自作者论文(arXiv v2 预印本),材料中没有第三方复现。
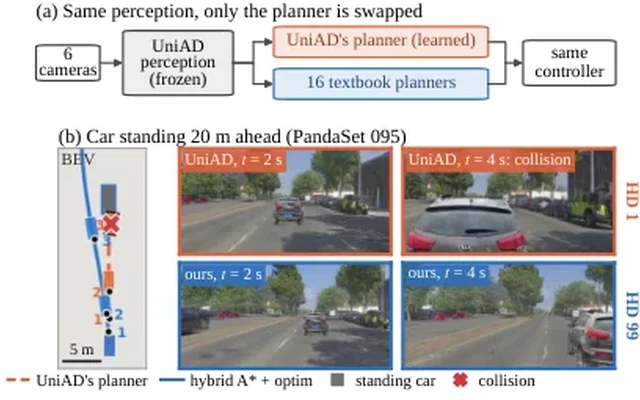 2026-11-19 · arXiv · 作者论文老式规则规划器有时比学习到的规划器开得好:在 UniAD 感知上替换规划器的对照实验(作者论文)
这是一次“替换实验”:检验端到端模型 UniAD 里那个从数据学出来的规划器,是否真比教科书写法的手写规则规划器更会开车。作者实现十六个规划器(四种路径来源 × 四种轨迹方法),在 nuScenes 开环、nuPlan 闭环(真值目标物与 HD 地图)、HUGSIM 照片级闭环(436 个场景、四档难度)三个基准评测。HUGSIM 上只替换 UniAD 的规划器、感知冻结、不给 HD 地图,输出仍是同样六个路点交给同一控制器,因此差异可归因到规划器。结果:同一份感知下十六个规划器中九个优于 UniAD 的学习规划器,最好的“混合 A* 路径 + 非线性轨迹优化”把 HD-Score 从 32.0 提到 41.8;nuScenes 开环 L2 误差 0.735 米对 0.947 米;nuPlan 摘要给 79.3 对规则基线 PDM-Closed 的 76.1,而表 II 中同一对照写作 75.2。
把它当接口设计的样例来读。
一、替换成本低。规划器每周期只读 UniAD 的跟踪目标(含 6 秒运动预测)、车辆占用预测、可行驶区域的鸟瞰掩码、自车速度/加速度/横摆角速度和导航指令,输出 0.5 秒间隔的六个路点,正是 UniAD 自己的输出格式,换实现不用改控制器。
二、两个规划器读同一份感知,差异就落到规划层。UniAD 规划器在 HUGSIM 上有 182 次运行撞上车辆,其中 31 次换成教科书规划器后在同样感知下能跑完路线,说明这批碰撞出在规划而非感知;另 131 次两者都撞,作者明说无法分摊。
三、增益有明确边界。静止车(+18.8 ± 4.2)与对向车(+17.8 ± 4.1)最明显,分别对应路径搜索绕开静态障碍、轨迹方法对照运动预测;面对主动朝本车转向的车辆没有增益(13.9 对 12.9,增益 −1.0 ± 2.8),因为依赖的预测没料到这种行为。
可迁移做法:把端到端模型当“感知+预测”的提供者,其后接一个可解释、可单独替换与评测的规则规划器,并让两者共享同一输入,才能定位问题出在感知还是规划。
引用时需一并说明的边界:
· 学习感知上的结果只用一个端到端模型(UniAD),学习规划器更强的模型可能表现不同,不能外推为规则规划器普遍优于学习规划器。 · 未用仿真器真值目标框复跑,因此两者都撞车的 131 次运行无法在感知与规划之间划分。 · HUGSIM 场景是固定基础场景的变体、彼此不独立,而标准误假定它们独立,误差估计偏乐观。 · HUGSIM 只插入车辆,评分主要看规划出的路点而非实际行驶运动;且忽略行驶方向,占用对向车道不扣分。 · 对照条件不对称:规则基线 PDM-Closed 用真值目标物与 HD 地图,模型内规划器只看到学习来的、带噪感知。 · 数值需注意:摘要写 PDM-Closed 为 76.1,表 II 为 75.2。 · 全部为仿真中的对比,未涉及真车部署、算力与时延,论文也未把结论表述为已验证的落地效果。
 2026-11-17 · arXiv · 作者论文面向具身操作的零样本组合泛化:用几何监督跨机器人复用演示
问题:机器人演示分散在不同本体上——一台机器学会把杯子放上架,另一台学会把容器放进抽屉,让第二台去放杯子就是"熟悉机器人 + 熟悉技能"的缺失组合;在每台机器人上把每个任务都采一遍,开销是两个集合规模之积。难点在于动作标签是关节向量,它绑定在演示者自己的运动学链上,条目含义取决于关节数、连杆几何、关节约定和安装方式,因此合并多本体数据时缺的正是跨本体的物理对应。
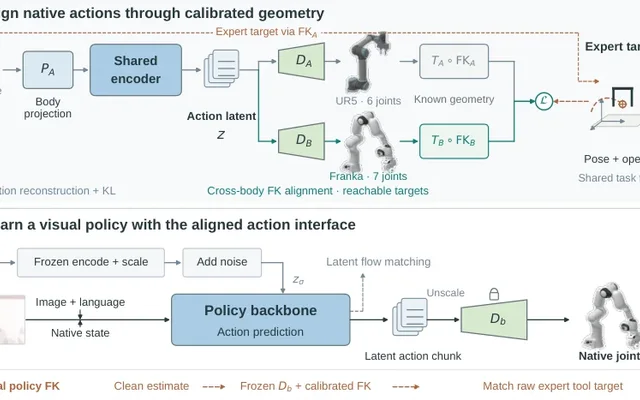
做法:作者提出几何监督训练框架。共享编码器把关节指令映射到共享动作坐标,每个机器人配一个原生解码器,把共享坐标还原成本体的关节指令;标定后的正向运动学(FK,即由机器人几何、关节限位、安装变换与工具标定算出末端位姿与夹爪开度)把解码结果换算到统一任务坐标系,与源演示给出的末端目标比对,因此即使没有外机关节标签也能训练外机解码器。只有当数值逆运动学(IK,即在关节限位与位姿容差内搜索可达解)找到有限解时,该末端目标才被用作跨机器人监督。接口训练结束后冻结编码器与全部原生解码器,策略随后在共享动作坐标上重新训练——保留各骨干原有的流目标(flow matching,即由噪声向目标动作预测速度场)、观测条件与训练曝光量,只把动作接口换成这一层——再通过目标机器人的原生解码器执行;Full 变体还会额外开启一条策略阶段的几何(FK)损失,这条损失会直接更新策略参数,需要在策略训练中单独开启与评估。
结果(全部来自仿真):覆盖两个仿真系统与三个策略骨干,表 1、表 2 中每个任务评测 1,000 回合,并分别对已见与留出组合的任务平均成功率取平均。RoboTwin 上 OpenWAM 的留出组合成功率由原生关节基线的 34.8% 提升到 46.5%(已见由 75.3% 提升到 78.7%);ManiSkill3 上 Full 的已见成功率 79.7–81.3%、留出 28.6–43.5%,而直接预测关节坐标的原生策略在留出组合只有 3.1–11.6%。消融中,跨机器人接口监督(Cross)相对只用原生重建(Source)把留出成功率提高 9.5 个百分点(OpenWAM)与 8.6 个百分点(FastWAM)。
对做本体软件和部署的工程师,实用价值是把"关节标签"换成一个可标定、可冻结的中间层:共享动作坐标 + 每台机器人自己的原生解码器。带来的变化是,以前没采过的机器人—技能组合,可以由别的机器人的演示提供监督,而三个策略骨干沿用自己原有的动作模型结构、流目标与观测条件,改动集中在动作接口这一层。
但要说清落地成本:这不等于"策略侧不用动"。策略必须在新的共享动作坐标上重新训练(接口只提供共享动作目标与原生实现,观测相关的技能判断仍由策略主干从图像、指令和本体状态中学习),训练完成后由目标机器人的解码器把预测动作还原成本体的关节指令去执行;若采用 Full 变体,策略阶段还要额外开启几何(FK)损失,这项损失通过冻结但保留梯度的解码器与 FK 更新策略本身,需要单独训练与评估。所以准确的描述是:骨干架构、流目标、观测条件与训练曝光量不变,动作接口与策略训练适配需要做。
接入点也很明确:每台机器人的运动学描述、关节限位、安装变换与工具标定必须已知;接口层训练完即冻结,运行时按机器人身份切换对应的原生解码器与归一化,动作生成路径不变。另外该方法要求每台机器人都有自己的原生演示数据(每台被评测机器人都出现在策略训练中),因此不能直接用于完全没有任何本体数据的机器人。
另外两点有助于判断能否落地:一是跨机器人监督只是位姿级约束,轨迹连续性、避碰和是否真正接触成功仍要在实际执行中检验;二是论文自己分析指出,只做原生重建不足以确定外机解码结果的物理含义,这正是必须显式引入几何对应的原因。
证据范围:本文是 arXiv v1 预印本(作者自述),全部实验在两个仿真系统中完成,每个任务评测 1,000 回合;本次材料中未见真机实验,也未见第三方复现的证据,因此这些结果不能直接当作真机落地效果。
前提与约束:方法要求每台机器人的运动学描述、关节限位、安装变换与工具标定已知,且每台机器人需要有自己的原生演示数据;方法包含两个训练阶段(动作接口训练与策略训练),策略需在共享动作坐标上重新训练,策略阶段的几何损失要单独开启和评估。
尚未解决:跨机器人监督是位姿级约束,轨迹连续性、避碰与成功接触仍需在执行中检验;留出组合成功率仍明显低于已见组合(RoboTwin 上 OpenWAM 的 Full 为已见 78.7%、留出 46.5%)。
引用说明:表 1 中第一行骨干的名称(π0.5)在原文中以公式标记形式呈现,无法逐字核对,因此本报告不引用该行数字;表 1 其余两行(OpenWAM、FastWAM)以及正文以文字给出的跨骨干区间均可逐字核对,本报告的数字均取自这些部分。
 2026-11-16 · arXiv · 作者论文WorldOracle:对照真实执行评测动作条件世界模型
动作条件世界模型(ACWM:给定初始观测和一段底层机器人动作序列,生成后续画面)的常见问题是"看起来对、结果错"——真机夹爪没抓到水果,模型却画成抓取成功。已有的具身世界模型基准多按文本或任务级指令评操作视频,或在仿真里评数据引擎、策略评估等功能,缺少"同一段动作在真机上到底发生了什么"的成对对照。
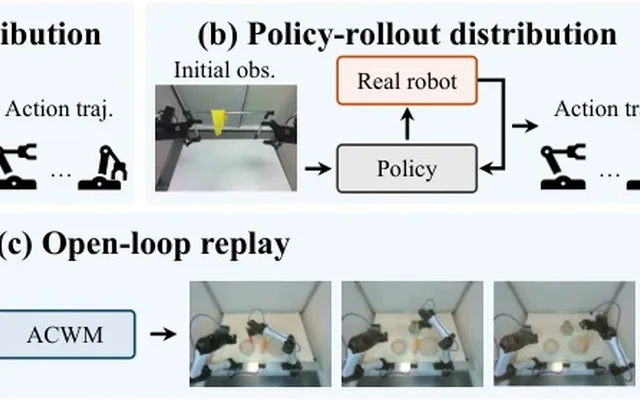
WorldOracle 补的正是这一环:给定相同初始观测与底层动作轨迹,判断模型预测的未来是否与真实执行一致。做法是开环回放——把录下的动作序列原样喂给模型生成预测 rollout,再与配对的真实执行在四个维度上比较:物理状态正确性(由 VLM 先生成物理状态判据,再据此判断预测结果是否满足)、交互空间对齐、关键交互区域保真度、多视角动作一致性。物体、机械臂与人手的逐帧掩码由 SAM3 分割模型给出,把评测聚焦到动作相关区域而非背景。任务覆盖摘水果、挂毛巾、倒水、拉抽屉,分别对应刚体、柔性物体、流体和铰接物体;评测集共 335 条,包含人工操作与策略 rollout 两种分布,后者是在 AgiBot G2 上由闭环策略产生的动作,其分布中带有犹豫、抖动和修正。
被测模型的分数随预测变长普遍下滑:在 AgiBot G2 上,GE-Sim 2.0 的单视角总分 WorldOracle-SV 从 73.86 降到 63.33,DreamDojo 从 50.56 降到 27.08,Cosmos 3 从 53.99 降到 26.60。动作对齐好不等于结果对:GE-Sim 2.0 全程交互空间对齐 73.49、多视角动作一致性 96.96,物理状态正确性只有 60.26、关键交互区域保真度 56.24。指标诱导的偏好与人类判断的整体一致率为 88.1%–93.2%。
需要注意的是三种本体的适配条件并不相同——AgiBot G2 用专属训练集、YAM 依赖公开数据因而训练—测试差距更大、人手是零样本评测——论文明确说这些结果不应被当作本体难度的受控对照,比较主要在各设置内部进行。
对做机器人本体软件和模型训练的人,这套基准给出的是一个可直接上手的流程:把真机录下的动作序列开环回放给自己的世界模型,再把预测画面与配对的真实执行逐项对比,从而把"动作跟上了吗""结果对了吗""随时间退化多少"分开看。GE-Sim 2.0 在 AgiBot G2 全程评测中多视角动作一致性 96.96、物理状态正确性只有 60.26,说明只看画面质量或只看轨迹贴合都会漏掉真正的失败。作者声明提供覆盖四项指标的评测工具包与排行榜,这属于作者自建的评测体系与开放产物;本次材料只包含该论文及其排行榜说明,未见独立第三方的复现或交叉验证。
覆盖面仍有限:目前覆盖三种本体、四个操作任务,评测集 335 条。三种本体的适配条件不同(AgiBot 用专属训练集、YAM 依赖公开数据因而训练—测试差距更大、人手零样本),跨本体的分数不能直接比,只能在各设置内部比较。指标实现依赖标注流程:物理状态正确性依据 VLM 生成的物理状态判据判定,其余三项依据逐帧分割掩码(物体、机械臂、人手),因此结果的可复现性也取决于这套标注与判定流程本身。本次材料只有该作者论文及其自建排行榜的说明,属作者自评,未见独立第三方的复现;评测工具包与排行榜的实际可用性本次未能核验。
 2026-11-18 · arXiv · 作者论文CoRA-VTLA:面向触觉后训练的接触引导注意力与可查询响应记忆
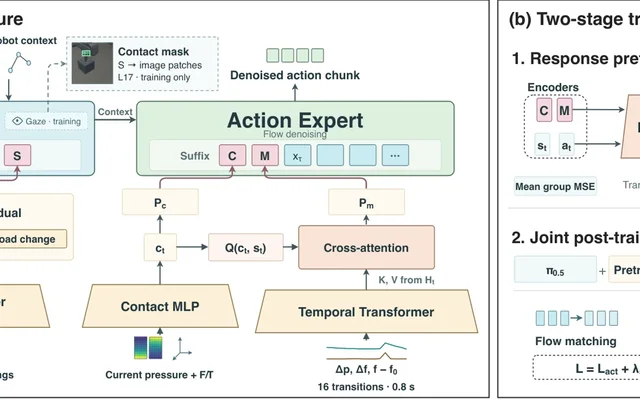
精密装配中,对齐或受力的小误差就足以让工件卡住或变形,纯视觉看不出这种隐藏阻力。这项工作瞄准预训练视觉-语言-动作模型(VLA,把视觉与语言映射为机器人动作的通用策略)在接触后的纠错能力,指出两个障碍:单次触觉读数说不清近期动作造成了什么后果,把触觉直接融合进动作专家会打散其视觉注意力,减少分给接触区域的份额。
做法是给预训练 VLA 加轻量触觉模块,分两层。动作层是可查询的动作—响应记忆:记录每条指令执行后的载荷变化,按当前接触与机器人状态形成查询,从历史中检索与下一步最相关的响应送入动作专家。感知层是接触引导的凝视监督:把指尖接触投影到主相机图块,要求触觉语义 token(承载触觉语义的向量)的注意力落在该区域。训练先用一步响应预测初始化两个触觉编码器(不跑 VLA 主干,作者称额外开销很小),再联合优化动作、语义与凝视三个损失。
三个 MuJoCo 任务平均成功率 73.33%,同传感器输入的直接融合基线为 50%,差值的 95% 配对自助法置信区间为 14.67 至 32 个百分点;公开基准 UniVTAC 的 Insert Tube(改用光学触觉图像)达到 67%,基线为 46% 与 51%;UR5e 真机(Robotiq 140 夹爪、双指电子皮肤)上的三个任务平均 66.7%,最强基线 44.7%。消融中去掉记忆 token 降到 54%,去掉凝视监督降到 49.33%。
这些数字都出自论文自身的评测;本次可用材料只有该论文的 arXiv v1 全文,未见第三方复现。
对做机器人本体软件的开发者,这是一条可复用的触觉接入路径:触觉不必整体拼进动作专家,可以先编码成按当前状态检索的响应记忆,再用指尖接触的投影约束视觉注意力落点。两个模块都在预训练 VLA 上做后训练,响应预测阶段不启动主干,只训练两个触觉编码器。
结果全部来自该论文自身的评测与统计口径,本次可用材料只有 arXiv v1 全文,未见第三方复现;其四次安全失效全部出现在钉子插入任务,插头插入与旋钮任务没有安全终止记录。
 2026-11-17 · arXiv · 作者论文HubEgo-100K v1.0:真实工位熟练劳动的第一视角视频数据集(作者发布版)
机器人操作策略用模仿学习训练后,换到训练时没见过的地方和物体上通常明显掉点。论文引用的已有研究认为,泛化能力主要随训练环境与物体的多样性增长,而不是靠同一个环境里多录演示;机器人数据要跨很多环境采集,成本高,而第一视角(头戴视角)人类视频可以大规模野外采集。问题在于,现有第一视角数据集大多拍的是日常生活,几乎没有真实工位里的熟练手工劳动。
HubEgo-100K 的首个发布版 v1.0 补的就是这块:10,124 小时 1080p 第一视角视频,带每帧对齐的惯性数据(IMU,惯性测量单元),由 12,227 名贡献者用头戴手机在自己的工位或家中录自己未脚本化的指定任务;覆盖 15,548 个环境、11 种场景类型、30 个工作类别、56 个任务类型、35 个动作族,83% 的时长在工作场所。数据按 72,754 个片段(episode,即数据集的基本单位)切分,每段带机器生成的动作、难度和语言标注,以 LeRobot v3 数据集加 MCAP(一种传感器归档格式)发布,许可 CC BY 4.0。
采集后走一条以自动为主的流水线:头戴检测(剔除没戴在头上的画面)、按时间分段只保留双手在执行指定任务的片段、手部可见性门控、隐私检测与剪除、片段组装、完整性与时间同步检查,以及跨任务类型的时长再平衡,人工复核结论优先于自动判定。60 fps 录制的片段占 15.9%,被重编码为恒定 30 fps,其余保留手机原始码流。
对接训练管线的方式比较直接:目录表和标注表无需下载视频即可读取,单个片段可按需拉取;每个片段一行帧级表格,timestamp 是相对首帧的采集时刻,observation.state 是六个 float32 值(加速度计读数含重力、陀螺仪读数),由原生采样线性插值得到。论文给出的定位是 GR00T N1 训练金字塔底层的“人类视频”,用法是与少量机器人数据共训、先在人类视频上预训练再在机器人数据上微调、或只用它训练视觉编码器;作者还提供按任务类型分层的贡献者不重叠训练/验证/测试划分(按需申请),用于评估对未见贡献者与环境的泛化。作者自报的分布统计显示时长很分散(没有贡献者超过 0.22% 的时长,中位贡献者只录 21.3 分钟),在 v1.0 内随机排列片段时,最后 10% 的时长仍带来 356 名新贡献者和约 84 个新名词词元;手部可见率与在任务上比例都是模型估计(至少一只手出现在 94.7% 的采样帧、双手 76.3%、在任务上比例 96.9%),并非人工审核结果。
对做机器人本体软件与训练管线的工程师,这份数据最实用的是交付形态:目录表(逐片段一行,含任务类型、工作类别、贡献者与录制标识、时长、设备信息、手部可见率和完整性信号)与标注表(描述、指令、动作族、技能组、难度、场景类型、在任务上比例)可以直接读取用于筛选和配比,不必先下载全部视频;需要细看时再按片段拉取 MP4 视频和 MCAP 原生传感器流,而视频与传感器共享同一条时间轴,帧级 observation.state 里带加速度计与陀螺仪读数,可直接用于头部运动估计或视觉-惯性里程计一类的预处理。按任务类型分层的贡献者不重叠划分(按需申请)能让“对未见贡献者与环境的泛化”这句话被真正测到,而不只是看同一批人的新场景。
需要区分清楚的是:以上用法是论文提出的定位与建议,论文本身没有给出任何用该数据训练出的模型或机器人实验结果,本篇只做统计;手部可见率和在任务上比例是模型估计,标注由模型生成且未经人工审核;清洗与标注流水线未公开,论文里的统计全部由已发布的目录表与标注表算出,分析脚本需向作者索取。
本文只做统计分析,没有训练任何模型或跑机器人实验,实验留待后续版本;文中的数字均为作者从发布表格计算所得,未涉及独立第三方复现。标注由模型生成且未经人工审核,手部可见率与在任务上比例是模型估计;5.5% 的片段存在超过 1.5 倍标称间隔的帧间隔,重编码片段可能含重复帧,单集时间漂移的中位绝对值为 0.017 s;原生惯性采样率因操作系统而异(iOS 约 100 Hz,Android 中位约 497 Hz);素材来自 56 种手机型号,未提供相机标定,相机与惯性传感器之间的残余时间偏移也未测量。清洗与标注流水线未公开,分析脚本需向作者索取。隐私过滤会剪掉检出儿童、他人面部或私人文字(文件、屏幕、卡片、车牌)的片段并留 5 秒余量,面部占画面比例过大的录制被剔除。任务类型的时长经再平衡,其占比不代表该任务在现实中的出现频率,模型应在实际使用条件下评测。
 2026-11-19 · arXiv · 作者论文Homeward:没有哪个视角比训练时的视角更好
机器人本体和任务都没变,只是第三人称相机被碰动、重装或换了镜头,冻结的视觉-语言-动作(VLA,把图像与指令直接映射为动作的策略)就会大幅失效:LIBERO-Plus 扰动基准把相机视角偏移列为对冻结策略最致命的因素,OpenVLA-OFT 在 1,599 个相机变体上总体成功率仅 62.5%,最大偏移下只有 22.0%。
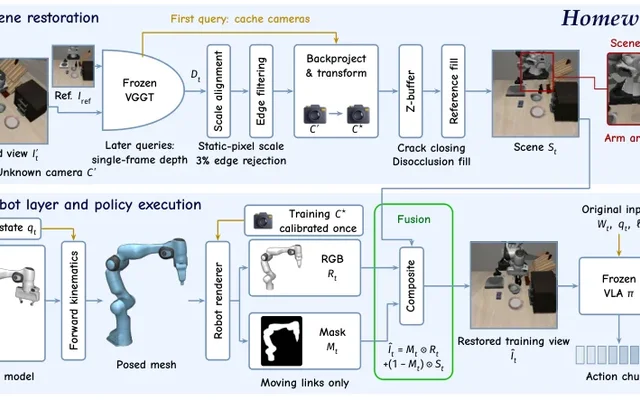
Homeward 是免训练、即插即用的观测适配器:不改策略权重,把未标定部署相机的画面还原成训练视角。它源于一个闭环悖论——用仿真器特权几何重渲染能救回大部分性能,换成现成的前馈 3D 模型 VGGT 后成功率反而降到 72.8%,比完全不校正还差,因为这类模型会把又细又反光的活动机械臂撕裂、打散,而机械臂的三维位姿本就由运动学模型给出。据此分工:估计未知的相机参数与静态场景深度,直接渲染已知的活动连杆。
在约 300,000 次闭环回合、四个冻结 VLA 上,1,599 个 LIBERO-Plus 相机变体的成功率从 62.5%、76.5%、68.0%、3.6% 提升到 77.6%、95.1%、91.2%、26.4%。无需场景微调与部署相机标定,它还覆盖 6 自由度随机摆位和焦距变化,配合逐步位姿估计处理回合内相机漂移;在 LIBERO-Plus 上对四个策略中的三个持平或超过需标定、需场景训练的视角合成基线。结果全部来自仿真。
对做机器人本体软件的工程师,这是一条不动模型权重的兜底路径:现场相机被挪动、重装或换镜头后,只要备好机器人运动学模型、一张训练视角参考图和一次性的训练相机标定,就能在不改动冻结策略的前提下把画面拉回策略熟悉的视角,保住闭环成功率。相机参数与场景深度由现成的单目 3D 基础模型在运行时估计,部署相机本身不需要标定,也不需要任何场景微调数据。代价是每次策略查询约 0.21 秒的额外开销(作者说明这是由还原与冻结两种闭环回合的墙钟时间差间接推得,而非直接测量的还原延迟),对 8 步动作块(一次决策输出多步动作)的策略摊到每个控制步约 27 毫秒。系统还有一层兜底:首次查询(t=0)的相机估计若满足旋转小于 0.5°、平移小于场景中位深度的 1%、焦距变化小于 10%,整回合直接透传未经还原的原始帧。
全部结果来自仿真;作者把迁移到真机列为重要下一步,需要处理 URDF(机器人模型描述文件)与真实成像的外观差异、机械臂前方遮挡和接触丰富的夹爪—物体交互。大范围环绕视角下,单目几何的平移估计误差由小轨道的 2 厘米增至大轨道的 7 厘米,作者认为宽基线平移漂移是瓶颈,因此需标定、需场景训练的视角合成在这一设定下仍有优势;而对已被微调策略掌握的视角,做还原也没有必要。最轻微的 Level 1 扰动档上,OpenVLA-OFT 反而下降 6.1 个百分点(87.4% 对 93.5%),说明该方法并非在所有扰动强度下都带来增益。
 2026-11-14 · arXiv · 作者论文先认证,再选择:面向冻结扩散策略的可行性感知运行时转向(CAST)
部署从演示学来的扩散策略(diffusion policy,一次生成一串短动作)后,机器人会遇上演示里没有的约束:有人伸手越过桌面、货架装在工作区上方、指令力度有上限。为每条约束重训不现实,常见做法是安全过滤器,把策略的动作按需改到满足约束为止;但修改只回答“这个动作安全吗”,不问任务能否完成,改得一大就落在策略没有数据的区域而卡住。
作者的 CAST(Certified Action Selection at Test time,测试时认证动作选择)不重训策略:每个决策批量采出若干段动作序列,先用屏障条件逐条认证,再由价值集成(value ensemble)排序,执行分数最高且通过认证的那一段;只有没有任何样本通过认证时才退回过滤器。先认证后排序,评分器不会拿安全换任务进展。
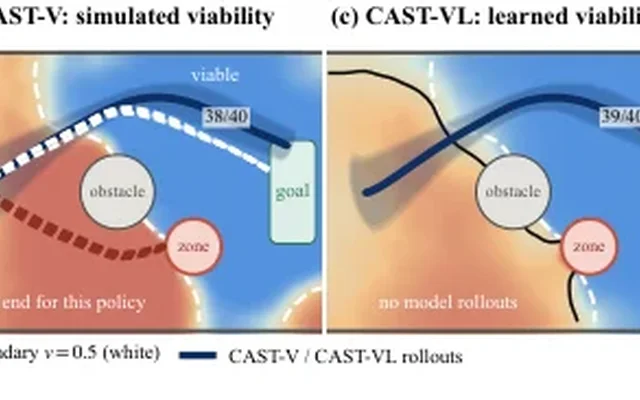
只认证下一段不够:生成式控制器此刻可能有安全动作,之后就没有了。论文因此引入策略条件下的可行性(viability),CAST-V 偏好那些执行之后仍可能持续采到认证动作的候选段,在线用模型 rollout 估计这一可行性;CAST-VL 则直接从控制器自己的日志里学,不做模型模拟。理论上给出三组结论:认证步是否安全与评分器无关;存在认证样本时执行动作与“可行条件下的策略”相对熵不超过 log N 纳特,投影式过滤可能落到策略支撑集之外;排序收益可精确拆成可得性、离散度和评分器目标。
在 robomimic 操作、四旋翼、人形和单轮车四类系统上用冻结策略评测,CAST 在十种设定里的九种中联合成功率高于输出过滤器(第十种打平)。编辑幅度大的力度预算下顺序决定结果:Can 上 b=0.15 时 CAST 为 0.53,先排序后过滤只有 0.16;路线被禁区挡住时 CAST-V 把单轮车成功率从 0.81 提到 0.99,CAST-VL 在四旋翼上 0.98,同场景 MPPI 为 0.61。CAST 无需重训,每次决策一次批量采样,Can 上约 15 ms。
对机器人本体软件工程师来说,这套做法的吸引力在于不碰策略权重:只在决策循环里加一层“采样—认证—选择”,冻结的扩散策略遇到新约束时还能把任务做完,不必为每条约束重训。代价在算力——CAST-V 的前瞻让决策时间变成 CAST 的 10–50 倍。另外要自行训练任务评分器;当请求改变“哪种行为能成功”时,还要改用能看到请求参数的评分器。文中所有数字都来自仿真。
证据只有这一篇 arXiv 预印本(作者自评),没有独立复现,也没有真机验证。安全只是被动安全,只覆盖通过认证的动作段及其备份,不覆盖危险源在机器人静止后靠近的情况。选择无法造出策略从不采样的行为;编辑幅度很小时先排序后过滤持平甚至更好;CAST-V 在 CAST 自己的选择已经可行时会损失进展。文中所有实验均为仿真。
 2026-11-19 · arXiv · 作者论文PILOT:用想象出的子目标与策略先验引导机器操作的长时程世界模型规划
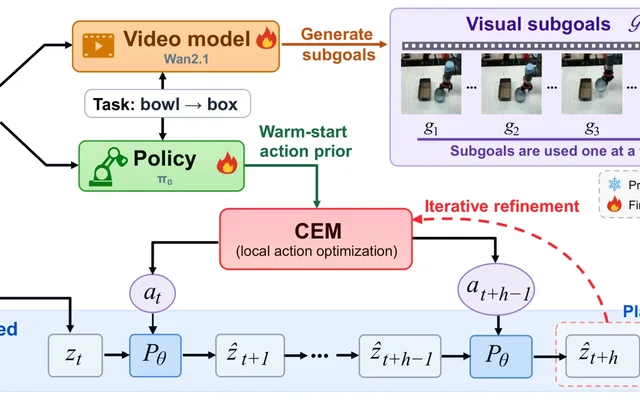
机器人做"把杯子放进碗"这类取放任务,要经历接近、抓取、搬运、放置多个阶段;这类任务难在三点:只给出最终目标图像时,对"准备动作"几乎没有指导;中间子目标图像靠人工准备不现实;动作采样从通用分布起步,搜索效率低。PILOT(Policy-Initialized Local Optimization with Temporal subgoals)把两个预训练基础模型的先验引入世界模型规划:视频生成模型把一句语言指令变成一串视觉子目标,负责下一步去哪;视觉-语言-动作策略(VLA,把图像与语言直接映射为机器人动作的模型)为交叉熵方法(CEM,一种无需对动力学模型求导的采样优化器)提供初始动作序列,负责在哪儿搜;CEM 再用动作条件世界模型的预测,把动作序列朝当前子目标精修。因为子目标由语言生成,测试时不需要目标图像,只给指令和当前画面。
开销的节奏要分清:视频模型在每个回合开始时生成一次子目标序列并按序处理,之后每次规划调用才在线跑一轮 CEM 优化。
真机部分在 UR5e 的四个取放类任务上评测,视频模型与策略用同一批 40 条专家示范(每个任务 10 条)微调:PILOT 成功率 68.8%,去掉策略初始化、只用生成子目标为 55.0%,直接执行同一策略为 13.8%,直接朝最终目标规划为 0.0%。仿真中,长 Push-T 任务上比直接执行同一策略高 30 个百分点,LIBERO-10 上高 22 个百分点(PILOT 达 60.0%)。两个先验互补,且策略先验不必强:单独只能在 3.3% 的中等长度 Push-T 任务上成功的策略,拿来当初值依然有效。
限制也很直接:作者列出的失效模式包括生成子目标不可达、世界模型误差把动作排错、策略中心采样限制探索;视频生成加在线优化相比直接执行策略会带来额外时延;真机只验证了 UR5e 的四个任务,仿真只有 Push-T 与 LIBERO-10。以专家轨迹帧作子目标时 LIBERO-10 达 88.0%,提示时序引导仍有改进空间,但作者明确说明这一对照并不是严格上界。
对做机器人本体软件的工程师,可落地的思路是在规划层加两段适配:用视频模型把语言指令变成分阶段视觉子目标,用现成的 VLA 策略给 CEM 热启动,不必人工准备目标图像或中间子目标;策略本身再弱也能当先验用。代价要按部署节奏估:每个回合需要在线生成一次视频子目标,每次规划调用再在线跑一轮 CEM,比直接执行策略多出时延和算力;子目标按固定日程推进,执行落后时不会自动调整时序,失败抓取后的恢复较难。
文中数字均为作者在自有设置下的报告,未经独立复现;真机只覆盖 UR5e 的四个取放任务,仿真只有 Push-T 与 LIBERO-10 两个基准。已知失效点是生成子目标不可达、世界模型误差导致动作排序错误、策略中心采样限制探索,以及视频生成加在线优化带来的额外时延。固定子目标日程无法应对延迟交互。用专家轨迹帧替换子目标只是对照实验,作者明确说明它不是严格上界,因此不能据此断定瓶颈位置。
 2026-11-13 · arXiv · 作者论文PingpongDuo:带安全团队协作的敏捷人形乒乓球双打
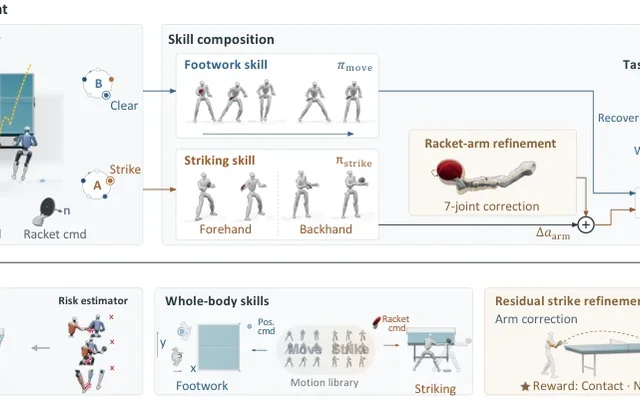
人形机器人打乒乓球双打的难点很具体:两台机器人要在同一侧狭窄球台上严格轮流击球,队友动作不同步就会带来碰撞风险。
PingpongDuo 用分层结构处理。团队层,一个强化学习规划器每来一球就依据预测的击球指令,同时为两台机器人选择横向站位目标;执行前用风险过滤检查这组目标,改写目标时按角色加权,对击球方的站位施加更大改动代价,优先保住当前击球方的目标。个体层,步法与击球拆成两套技能,参考动作取自真人双打全身动作记录,切成约 200 段覆盖不同移动距离的步法片段;每套技能都从另一套技能留下的身体状态开始训练,以支持移动—击球—让位的连续交接;击球后由球拍手臂上的残差(小幅修正)继续调整,训练信号来自经真实动捕标定的球体仿真器。
仿真中,回球成功率相对作者所称当时最优基线提升 13.2%,让位时定位误差约 2 cm;同一风险滤波器下,学习站位相比固定规则站位把平均连续回合数从 3.79 提到 4.87;名义技能固定时加上手臂残差,触球成功率从 55.2% 升到 67.4%,合法回球率从 44.2% 升到 55.6%,让位性能不变,因为修正只在击球阶段生效。
真机为两台 29 自由度 Unitree G1,用外部动作捕捉(MoCap)估计机器人与球的状态;机器人完成 2.15 m 让位—回位循环用时 2.4 s,峰值速度 2.23 m/s,两台机器人维持 10 次以上严格交替的连续击球。
对做机器人本体控制和策略上线的工程师,这套做法把“多台机器人共享狭窄空间”的协调问题拆成了可分层实现的结构:上层用带风险检查的联合站位选择加按角色加权的回退来管互撞;下层把移动与击球分开训练,并显式用彼此产生的身体状态做初始化,以支持技能之间的连续交接;手臂残差那条路还给出一个具体提醒——球拍跟踪误差更小未必回球更好,需要按实际回球结果来修正击球动作。
证据身份为 arXiv 预印本(作者论文,未见同行评审信息),抓取到的是该条目的第二个版本,未与首版或其他发表版本交叉核对。关键数字均为作者自报的仿真与真机结果,未见独立复现。真实系统依赖外部动作捕捉来估计机器人与球的状态,当前感知装置不提供球的自旋测量,自旋效应未纳入轨迹预测与球拍—球交互模型。所有结果都在作者自己的实验设定下取得,不能外推到其他本体或场景;“state-of-the-art 基线”是作者对其所比较基线的表述,跨协议比较需另行核对。
 2026-11-17 · arXiv · 作者论文从温度受限到电池受限:不测温度的 Unitree Go2 步态策略
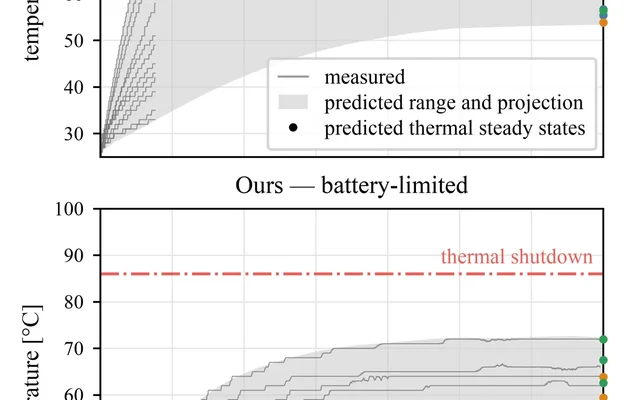
论文要解决的问题是:长任务跑下来被打断的原因不是电池耗尽,而是关节电机先过热停机。论文给出的例子是原厂自带运动控制器的 Unitree Go2——在 27 °C 室内以 1 m/s 空载行走,约两小时(7.7 km)就过热停机,此时电池还有电。
难点在时间尺度:电机热时间常数比强化学习(RL,即让策略靠试错自行训练的方法)能分配信用的时间范围长出多个数量级,用温度做奖励时信用分配超出了单个回合的范围。作者的做法分两步。第一步是先辨识机器人自身的热模型:一个 22 参数、13 节点的集总 RC 热网络(把电机各部位抽象成"热容 + 导热通路"的电学类比网络),辨识时先用电气量(静态功耗、焦耳加热系数等)把参数钉在物理量纲上,再去拟合温度;该模型只用 Go2 一台机器人的两段运行数据辨识,参数在论文中完整列出。第二步是把奖励里的"当前温度"换成"稳态温度",即持续步态下电机最终稳定到的温度:它只取决于步态平均的关节力矩平方和关节速度,做一次小规模线性求解就能算出,并在一个步态周期内对力矩或速度变化作出响应,于是信用分配的时间尺度从热尺度压回步态尺度;策略输入不用加温度,评估也不依赖电机初始冷热状态。奖励本身惩罚这些稳态温度的软最大值,鼓励降低最热关节并把热负载分散到其他关节。
热模型本身要先站得住:在未参与辨识的运行上,该网络预测全部十二个电机温度的平均 RMSE(均方根误差)低于 1 °C,覆盖第二台 Go2、学习得到的步态、载荷至 10 kg、速度至 1.4 m/s、持续行走与走停交替等工况。
真机结果:5 kg 载荷、1 m/s 平地上,一个学习得到的基线策略 19 分钟(1.1 km)就热停机,新策略跑满 174 分钟(10.0 km)才耗尽电池,最热电机距停机阈值还有 14 °C;这两次运行的室温分别是 22 °C 和 26 °C(基线那次更凉),同速度下新策略耗电 142 W、基线 244 W,单位运输能耗 0.71 对 1.24。空载工厂环线(含楼梯和坡道)上,基线 25 圈(6.2 km)后过热,新策略用一块电池跑完 47 圈(11.2 km),余量 22 °C(对应 111 分钟对 193 分钟,最热关节峰值 64 °C,每圈 8.8 Wh 对 13.4 Wh;环线两次室温 23 °C 与 25 °C,基线那次更凉)。代价是楼梯上的速度跟踪误差增加 18–19 %(0.8 m/s 指令下约 0.02–0.03 m/s)。
对做机器人本体控制与部署的工程师,可借鉴之处很具体:电机热约束可以在训练阶段用奖励解决,不必把温度塞进策略观测,也不必等真机过热再补救——路径是"先为自家机型辨识一个热模型,再把模型预测的稳态温度作为一项奖励加进现有的行走策略训练",策略输入和部署代码不需要大改,评估结果也不受电机起始冷热影响。
落到工程上有几个前提。其一,每款机型都要自己采数据做辨识:本文热模型只用 Go2 一台机器人的两段运行数据辨识,22 个参数在论文中完整列出,可以照着复现;辨识时先用电气量把参数锚定到物理量纲,再拟合温度。其二,要跑通仿真到实机的迁移,并保证步态能力不被牺牲:论文把新奖励加进原有的行走策略训练流程,并在真机上跑通了含楼梯和坡道的工厂环线。其三,奖励权重要在热余量和跟踪精度之间自己权衡:论文部署的权重在楼梯上多出 18–19 % 的速度跟踪误差,权重再往更激进的方向调时楼梯、粗糙地形和下坡的误差继续上升,而热余量只多 2–4 °C。
范围也要说清:验证只在 Go2 这一种四足机型上做,跨机验证仅涉及另一台 Go2,不能直接外推到双足或人形;带载时按实测步态统计预测的最热稳态温度仍比仿真均值高 4.6 °C(空载高 0.8 °C)。
证据仅来自论文本身(arXiv v1 全文与摘要),属作者自测结果,本次材料未包含第三方独立复现,也未包含厂商发布的独立验证数据。适用范围限于 Unitree Go2 一种四足机型,热模型按单机数据辨识(另一台 Go2 只用于验证);对照基线与实测均在作者自己的室内条件下完成,且基线那次室温更凉(平地 22 °C 对 26 °C,环线 23 °C 对 25 °C),比较时需注意这一条件差异。方法本身有明确代价:楼梯速度跟踪误差上升;带载时按实测步态统计预测的最热稳态温度仍比仿真均值高 4.6 °C(空载高 0.8 °C)。本次材料为 arXiv HTML 全文解析结果,公式与表格存在格式损失,数值以上述原文表述为准。
 2026-11-17 · arXiv · 作者论文让心构想,让手实现:面向长程操作的接地动作与进度评估耦合
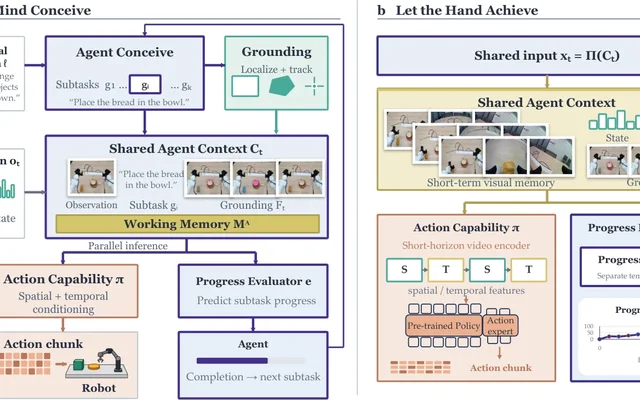
执行"先掀开积木盖、再盖回去"这类多步指令时,机器人要按顺序操作正确物体,并在场景变化后自己判断当前一步是否做完、何时进入下一步。作者的动机数据是:π0.5 策略在单个原子任务上成功率 85.0%,但拿到一条含 6–18 个子任务的完整指令后,平均只连续完成 0.93 个子任务。
Orchestra 是一个把任务规划与执行管理从动作生成中分离出来的智能体框架(agent harness):DeepSeek-V4.1-Flash 把多模态指令拆成有序子任务并维护共享上下文,MolmoPoint-8B 配合 SAM3 在头部相机图像上定位当前子任务涉及的物体,动作策略(π0.5 微调,每相机 6 帧历史)输出动作块,另一个独立训练的评估器输出 11 类子任务内进度;一旦判断当前子任务完成,框架丢弃待执行的动作、在当前场景重新定位下一子任务的物体,并开始一段新的视觉历史。
结果:RMBench 九个任务平均成功率 68.22%,比 Mem-0 高 26.22 个百分点;RMBench-Compose 上平均连续完成长度(ASL)7.35 个子任务,HarnessVLA 为 2.99。消融中去掉任务编排 ASL 由 7.350 降至 1.502,去掉动作策略的最近帧降至 3.758,去掉空间接地降至 6.014;而把学习到的进度判断换成仿真器真值完成信号,ASL 仅由 7.350 变为 7.374。真机四个任务上,加入空间与时间条件后子任务成功率 SSR 从 72.77% 升至 82.09%,ASL 从 2.20 升至 2.75。
条件:评估器用 6 帧历史把"按时切换"率从 77.0% 提到 96.6%(每方法 500 例);真机四个任务的指令长度只有 3–5 步,每任务每配置 20 次 rollout。
对做本体软件和集成层的工程师,这套思路的价值在于:保留预训练 VLA 当动作策略,在外部加一层负责拆解指令、重新定位物体、判断"这步做完没有"的编排层,子任务边界重置视觉历史并重新接地,完成记录按 episode 保留。作者的消融提示,编排与空间接地各贡献一部分增益,而"何时切换"即使换成仿真真值也几乎不改变序列长度——瓶颈仍在动作执行本身。
结果全部出自作者论文及其自建基准与自建双臂真机平台,本次材料中没有独立第三方复现。真机四个任务的指令仅 3–5 步、每任务每配置 20 次 rollout,样本与序列长度都偏小;作者统计的 65 例真机失败中 87.7% 属动作执行问题,且即使换成仿真真值完成信号,Pick Up Object 也只完成 10 步中的 2.20 步。arXiv 摘要与 HTML 为滚动更新页,本条按 v2 修订版全文撰写,未核验后续版本与公开代码仓库内容。
 2026-11-15 · arXiv · 作者论文SALA:用语言描述对齐人机隐式动作,让通用人类视频成为可扩展的机器人策略监督来源
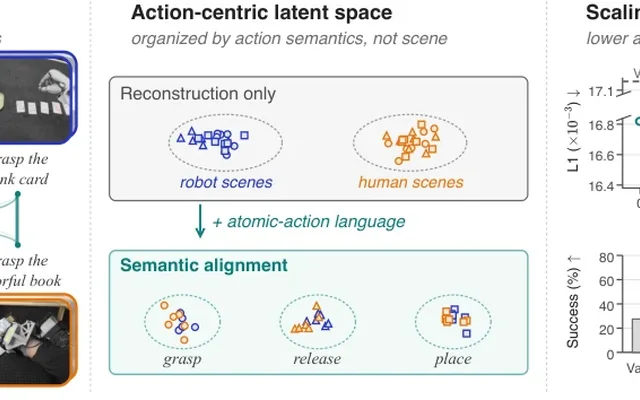
任务:让机器人策略从"别的本体的视频"里学——用大量真人第一视角视频(采集不需要机器人)来补充昂贵的真机遥操作数据,训练控制机器人本体的策略。已有的通用做法是隐式动作模型(LAM:从前后两帧学出一个动作编码),但多数 LAM 只做视频重建,学出的编码容易按画面外观(例如场景)而不是按底层动作聚类,于是人做的动作和机器人做的同一件事在编码空间里对不上。
SALA 的改动:用每个片段"原子动作"的自然语言描述,在不要求人机数据配对的前提下估计语义相似度,把它转成"软邻域"目标;机器人一侧的隐式动作由动作重建锚定在控制上、充当锚点,人类一侧单向移动过去(stop-gradient 保证锚点不被反向拉动)。分词器训好后只看视频帧就能给人和机器人视频打上同一套隐式动作标签,成为在两类视频上训练策略的统一监督信号。
作者自测结果:仿真 RoboTwin 2.0 上,用来代替真人视频的是另一台机械臂的视频,SALA 的平均成功率高于用同样数据训练的已有 LAM 与 WAM。真机为 Sharpa North 轮式人形机器人,配两只 22 自由度灵巧手,63 维关节动作;四个下游任务各 20 次试验,SALA 平均 72.50%,OpenWAM-α 63.75%,同架构但去掉隐式动作的基线 27.50%。预训练阶段把通用人类视频加到 2,678 小时,机器人动作预测误差持续下降且不需要新增机器人数据;后训练阶段固定遥操作演示、逐步增加任务相关人类演示,平均成功率从 53.75% 升到 72.5%。
对做机器人本体软件的工程师,有用处的有两点。一是监督来源可以按小时计量:先用一批带原子动作描述的数据训一个跨本体的隐式动作分词器,之后人和机器人的视频都被映射到同一套语义对齐的动作编码上,策略用同一套编码同时从两类数据里学——预训练阶段可以用通用人类视频补充机器人数据而不必新增遥操作采集,新任务则能在固定遥操作预算之外用便宜的人类演示补强(真机上固定遥操作演示、逐步增加任务相关人类演示,平均成功率 53.75%→72.5%)。二是部署侧不增加负担:教师分词器和未来帧只在训练时使用,部署时策略只看当前观测。代价是流程里多了一个要单独训练和维护的分词器环节,它要求为训练片段准备原子动作描述,而策略本身不吃这些描述、只从视频帧学习。需要提醒的是,本次核查材料中的所有数字都出自作者自测的仿真与单台真机实验,没有独立复现证据。
全部数字均来自作者自测实验,条件有限:真机只有 Sharpa North 一台轮式人形机器人、四个下游任务、每任务 20 次试验;仿真的证据只来自 RoboTwin 2.0,且其中的"非目标本体视频"其实是另一台机械臂的视频,不是真人第一视角视频;分词器训练仍需为片段准备原子动作描述(策略本身只从视频帧学习),预训练扩展分析只做到 2,678 小时,更大规模是否延续仍未知。以上为作者自述的限制,结论不宜外推到其他本体、任务或数据条件。
 2026-11-17 · arXiv · 作者论文《Lazy-MOSAIC:用学到的技能效果世界模型加速以技能为中心的操作规划》
在杂乱货架上取扳手这类任务里,机器人要连着做好推、抓、搬运等多个技能,每个技能还带一组参数。以技能为中心的规划器 MOSAIC 会把每个候选技能都先放进物理仿真器跑一遍,不管它最后是否进入解里,这一步占它 80% 以上的规划时间。Lazy-MOSAIC 改的就是这条流水线:先用便宜的学习模型预判技能会不会成功、会把物体带到哪里,再决定哪次仿真值得花。
预判由技能效果世界模型完成:用 Deep Sets(一种对输入对象顺序不敏感的集合编码结构)编码器把技能提案特征、机器人自身状态和逐物体特征合成场景上下文,输出头预测成功与否、机器人位形变化和物体状态残差;若干独立初始化的模型组成集成,用彼此的分歧表示不确定性。规划时并行维护两张图:乐观图存预测,认证图只存仿真中跑通的技能;候选路径的前驱都已兑现时,才把下一个技能送进仿真做认证;预测与实测不符时只修掉依赖它的分支,保留实测状态,其余预测照用。于是返回计划的每个技能都经过仿真验证,学习模型的误差只影响搜索效率,不影响计划有效性。
评测用 UR10e 机械臂配平行夹爪,在 ManiSkill3/SAPIEN 仿真里做三个货架任务(任务 1、任务 2 各含易/中/难,任务 3 无易档),每档 20 个相同随机配置、规划超时 600 秒。Lazy-MOSAIC 成功 104/160 次,MOSAIC 81/160 次;在两者都解出的设置上,规划时间最多快 6.6 倍,仿真器调用从 46.4/67.9/134.5 次降到 16.9/21.7/41.3 次(易/中/难)。不做仿真认证、只按学习模型执行的 WM-MOSAIC 在它能解出的试验上很快(1.7–8.1 秒),但 160 条已执行计划里只有 33 条到达目标。真机演示作者只给出配套视频,正文未提供真机量化结果。
对做机器人本体软件的工程师,这套做法是把「便宜模型筛选、物理仿真把关」接到技能库规划器上:便宜模型决定哪些技能值得占用一次仿真调用,仿真器保留最终验证权,因此能压低仿真调用量而不放弃基于物理仿真的安全前提。前提也很明确——工作空间几何和物体类型须预先已知,学习模型针对该半结构化环境离线训练,作者把跨工作空间泛化列为下一步。
本次材料为 arXiv v1 的公告条目与全文 HTML 快照(非滚动页、非持续更新目录),未包含第三方复现或后续版本记录;表 I、表 II 的成功率和时间数据均来自 ManiSkill3/SAPIEN 仿真,真机部分作者只指向配套视频,正文未给出真机量化结果。方法只针对工作空间与物体类型预先已知的半结构化场景,跨工作空间泛化被作者列为下一步;最难的设置上加速幅度较小,乐观图的维护与修复开销也随图规模增长。任务 3 的困难档成功率仍然很低(4/20),其余方法在该档全部失败。
 2026-11-17 · arXiv · 作者论文每台相机都在「长大」:交互式视频世界模型中的相机高度回归
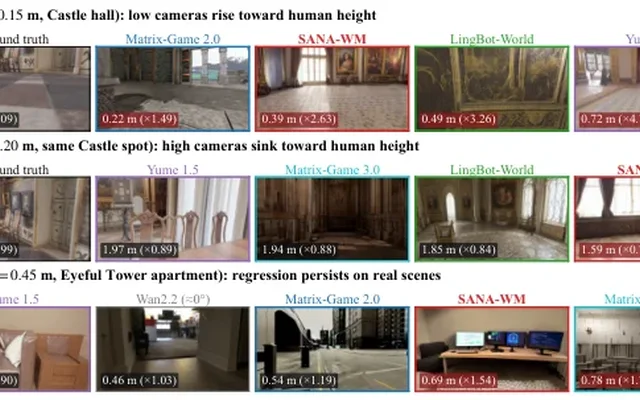
这篇 arXiv 预印本评测六个近期开放权重的世界模型(交互式视频世界模型:用起始画面加相机轨迹生成后续画面的生成模型)。起始画面同时锁定相机离地多高——地面机器人约 0.15 米、俯视相机约 2.2 米——忠实的仿真器必须在相机移动中守住这个高度,而这六个模型全都守不住:运动用生成内容替换起始画面后,相机被拉向人眼高度,低机位升高、高机位下沉,作者称之为「相机高度回归」。为此作者提出基准 EyeHeight:用恒定高度、恒定俯仰的轨迹驱动模型(渲染起始 0.15 至 2.2 米,外加标定的多高度真实照片),再用与尺度无关的多视角三维重建从生成帧反推相机高度。在「转身再向前走」的片段上,从 0.15 米起步只有 0–20% 的片段结束时高度落在起始高度的 1.3 倍以内,推断出的视点收敛到 1.1 至 1.5 米的人眼高度带,而同一脚本下的真值渲染只偏几个百分点。作者把这种拉力归到训练视频的人眼高度先验:公开互联网与游戏视频集中在 1.6 米附近,近地视角几乎不存在;在 SANA-WM 上,把高度写进提示词不起作用,微调出的地面视差分支对反事实的高度缩放几乎无响应(斜率仅 0.03,忠实使用应为 1);而更强的无分类器文本引导(CFG)会加深回归,影响主要来自去噪的前半段。缓解只在 SANA-WM 上评估:无引导采样加高度平衡微调能恢复更多高度保持,但 MUSIQ(感知质量评分)要掉 5 分,损失恰好发生在同样决定相机高度的早期去噪步。
对写机器人本体软件的人,最直接的影响是:世界模型生成的第一人称画面,未必是这台机器人的视角。起点画面锁的是相机自己的离地高度,一旦转身去补画背后的房间,相机高度就被拉向人眼高度带;把这些画面当作导航策略的评估输入时,策略看到的其实是一个并不属于自己的视点。这不只是观感问题:仅姿态漂移本身,就把视觉导航策略预测的路径终点推移了 0.12 至 1.18 米。可直接做的两件事:一是评测时把相机高度保持性与轨迹一致性一起报告(作者也这样建议),「画面看着对」不等于「视点对」;二是检查采样配置,去噪早期开着文本引导时可考虑先关掉一段引导,并用高度平衡的微调补上缺失的低视角画面。另一个容易被忽略的细节是:Matrix-Game 生成的片段在几何上自相矛盾,地面纹理以恒定仰角旋转,新补画的墙面和家具却暗示更高的相机。需要注意,全部干预实验只在 SANA-WM 上做,论文没有验证这些做法在其他世界模型上是否同样有效。
全部结论来自作者自己的一篇 arXiv 预印本:本次材料只有其 v1 全文页面,没有更新版本,也没有第三方复现;六个模型的评测、指标与缓解实验都由作者完成。生成视频没有真值三维几何,主指标依赖多视角地面重建并要求画面中出现可见地面,作者用 VGGT、单目度量深度和无学习的地板单应做了交叉验证。导航影响只在开环下衡量预测路径偏移,闭环后果尚未测试。训练与引导干预只覆盖 SANA-WM,对流式因果模型的补救留待后续工作;作者也指出,把微调与无引导采样组合时,质量损失出现在同样决定相机高度的早期去噪步,属于用一项换另一项,并建议世界模型评测同时报告相机高度保持性与轨迹一致性。
 2026-11-19 · arXiv · 作者论文SixthSense:仅靠本体感知的全身接触力旋量估计(人形机器人)
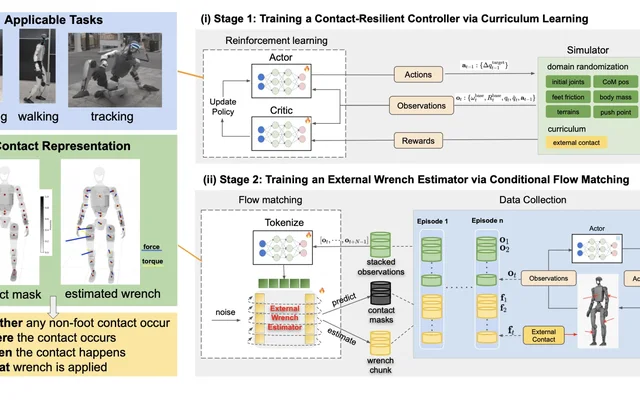
人形机器人要与人、物体真实交互,得先知道何时、碰到哪里、用了多大力;但物理接触多被当作要压制的扰动,而非被感知的对象,浮动基座又让"只凭本体感知(关节与IMU自测信号)反推外力"天然歧义。论文《SixthSense》把全身接触估计写成条件生成推断:用条件流匹配(一种生成式训练方法)建模"连杆级接触门控 + 六维力旋量(wrench,三维力加三维力矩)"的稀疏时空场,条件只有本体感知与IMU历史;同一组权重覆盖躺、站、走、动作跟踪四类控制器。
仿真上作者收集 100,000 段单接触回合:仅用本体感知的方法中,检出率 91.94%、误报率 0.15%、精确连杆定位 34.96%,平均力误差 9.42 N 最低;观测噪声放大到训练水平 5 倍时在所有被评方法中最稳健。真实 Unitree G1 上作者自采 372 段数据(站立 312、行走 30、躺卧 30)建立基准,站立工况用 24 段微调、288 段评测,误报率 0.66%、精确连杆定位 66.89%、时间覆盖 57.14%,力与力矩误差 4.61 N 与 0.63 N·m,但检出率 86.70% 低于去掉流匹配的对照 91.04%。
歧义实验中,同一段带噪观测采样 200 次给出多个动力学上成立的接触位置(左肩偏航 37%、左肘 58%、左腕滚转 5%),双模态稳定覆盖 20/20,对照 CVAE 为 4/20;作者同时说明这并未测量后验校准。单次推理约 50 ms(24 步积分,与观测窗口延迟分开计算)。
对机器人本体与控制软件工程师,这套方案把"接触感知"做成可独立接入的模块:输入只有已有的关节编码器与 IMU 历史,输出是连杆级接触门控和六维力旋量,作者在 Unitree G1 上用它做了碰撞检测与接触触发的人机物理交互演示,也可作为下游判断的输入。要留意的是,这些数字全部出自作者自测,真机接触真值只覆盖站立工况,空间分辨率止于连杆级。
作者预印本,全部指标为作者自测、无独立复现;真机定量扳手评测只覆盖站立工况,行走与躺卧段没有力或力矩真值;共享权重并不等于能迁移到未见控制器,单接触训练也不代表可零样本恢复多接触;空间分辨率止于连杆级,且只依赖本体感知;后验校准未被测量。本次依据的是 v2 修订版的 HTML 快照,正文与数字可能随后续修订变化。
 2026-11-20 · arXiv · 作者论文论智能体式操作策略(On Agentic Manipulation Policies)
机器人操作过去主要靠示教数据训练“专才”策略:视觉-语言-动作模型(VLA,把图像与语言直接映射成动作)和世界-动作模型(WAM,先预测世界变化再输出动作)。这篇 arXiv 预印本提出另一条路——把通用大模型留在控制回路里,由它直接指挥机械臂,并在任务推进中修改动作,作者称之为“智能体式操作策略”(AMP)。
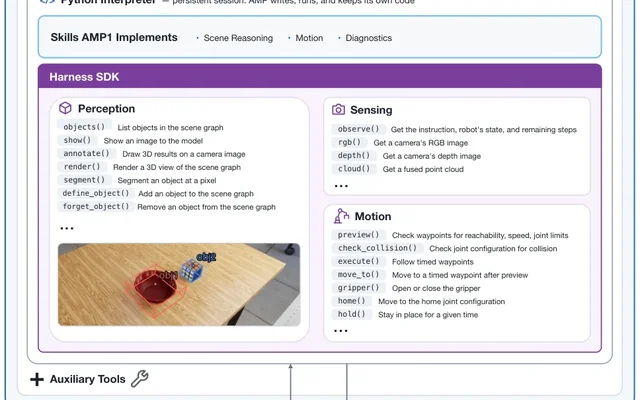
对做机器人本体软件的工程师来说,这次的具体变化是一个“薄外壳”参考实现 AMP1:同一套代码不改就能跑单臂、双臂和移动操作;外壳不提供抓取、推送、放置这类动作原语,动作由模型每个回合自己写出来;再配一个跨回合的持久记忆库,模型权重保持不变,只累积观察、策略和代码。
结果均为作者自评、尚无独立复现:RoboLab-120 零样本成功率 85.6%,而对照的 VLA、WAM 是 49.2% 和 42.9%;真机十二个任务、三台机器人共 108 次试验成功 104 次,作者称失败率比 VLA、WAM 基线低 20 倍和 15 倍;CaP-Gym 的 LIBERO-PRO 子集为 95.2%,同为零样本智能体的 CaP-Agent0 为 18.2%。带记忆版在 RoboDojo 的 42 个双臂任务上,未见布局成功率从 26.4% 升到 84.1%,顺序单遍连续学习升到 57.6%。外壳实现细节会直接改变结果:启用错误恢复(RfE)时真机成功 104/108,去掉该接口后为 94/108;辅助性的抓取/放置例程则对模型强弱作用相反,强模型加辅助外壳最多掉 7.5 分,弱模型最多涨 17.6 分。
85.6% 不宜直接当作策略能力上限:作者逐条复盘失败回合后称,约三分之二来自基准本身(121/173 与 135/206),主要是物体宽度或质量分布与标准平行夹爪不兼容,以及校验器误拒已满足指令的终态。作者自陈的限制是策略慢、轨迹执行中无法改写、评测以准静态场景为主。
给机器人本体软件工程师,有三件事可以直接用。
第一,动作原语可以不给。AMP1 的外壳只提供感知与运动接口以及错误恢复,抓取、推送、放置由模型在每个回合现场写成代码;同一套外壳因此能覆盖单臂、双臂和移动操作,也不需要示教数据或任务特定训练。这把“能力不够就往技能库里加动作”的思路,换成“外壳保持稳定、强度交给模型”。
第二,外壳接口的容错约定直接计入结果。启用 RfE(错误恢复)时真机是 104/108,去掉该接口后是 94/108;而辅助抓取/放置例程对不同模型的作用方向相反——最强的四个模型加了辅助外壳反而更差(最多掉 7.5 分),最弱的六个模型反而更好(最多涨 17.6 分),中间的模型没有收益。做本体软件的人需要自己划定接口边界、错误恢复与辅助例程的取舍,而不是默认“多给点能力总没错”。
第三,记忆库是低成本的能力增量。模型权重不动、不做梯度更新,只记录观察、策略和代码,RoboDojo 双臂任务上未见布局的成功率就从 26.4% 提到 84.1%,单遍顺序连续学习到 57.6%,并且能迁移到还没尝试过的任务而不抹掉已有收益。
需要保留的判断:这些数字目前只有作者自评的预印本支撑,没有独立复现;对照的 VLA、WAM 成绩取自公开榜单条目,不是作者在同一环境下统一复测,而且当时榜单上最强的条目本身也是智能体(SenseNova-RoboRSI,57.1%),最强学习策略 Lakeside 为 51.0%。另外作者自己指出,LIBERO-Goal 上失败的回合几乎都是智能体自认为已经成功,人工复核认为它对指令的理解与人类一致、却与基准校验器不一致——基准分数与实际可用性之间仍有一段距离。
证据等级:arXiv 预印本、作者自评,尚无独立复现。对照项取自公开榜单条目,不是统一环境下的复测。
对比口径:85.6% 与 49.2%、42.9% 是作者自评与榜单条目混列的结果,不是同一批重测;LIBERO-PRO 上更高的 96.5%(HarnessPAI)并非零样本,它在评测集内部的种子上演化程序,不能与零样本结果直接并列。
数字解读:作者称约三分之二的失败来自基准自身(121/173 与 135/206),原因是物体宽度或质量分布与标准平行夹爪不兼容,以及校验器误拒已满足指令的终态,因此 85.6% 不宜直接当作策略能力上限;RoboDojo 的 26.4%→84.1% 是逐任务练习后的未见布局结果,与零样本条件不同,不能混为一谈。
方法边界:策略慢,机器人大部分时间在等模型推理;轨迹执行过程中模型无法重新决策;评测以准静态场景为主,移动目标或滑落物体要等模型下一轮才能响应。
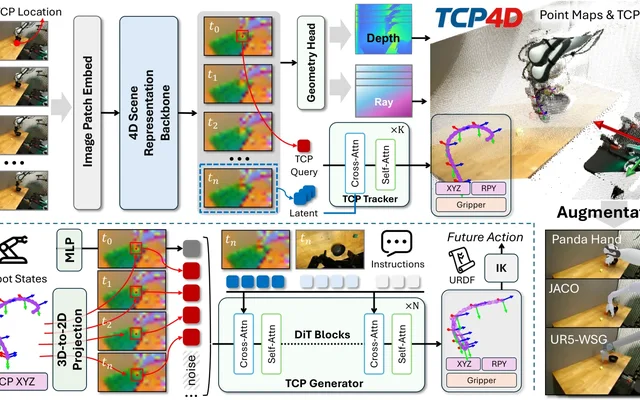 2026-11-18 · arXiv · 作者论文TCP4D:面向机器人操作的统一工具中心点跟踪与生成模型
机器人操作视频很多,但多数没有同步的动作标注,只凭 RGB 视频反推末端位姿和夹爪状态仍然困难。TCP4D 把工具中心点位姿(TCP,末端工具坐标系下的六自由度位姿)当作与机器人本体无关的动作空间:同一个位姿在不同机器人上代表同一个任务空间目标,各自用自己的逆运动学(IK)到达。
模型是一个前馈统一框架:单目 RGB 视频加首帧的一个二维 TCP 查询点,经共享的 4D 场景表征同时解出米制 TCP 位姿、夹爪状态、场景几何和相机参数,不需要额外的机器人先验和后处理;生成器沿恢复出的 TCP 轨迹采样局部特征,结合机器人观测与语言指令预测未来 TCP 状态。恢复出的轨迹经逆运动学重定向后,能把现有 RGB 视频转成其他本体的演示数据,不需要源机器人的状态记录。
作者论文中的结果:跟踪绝对轨迹误差(ATE)在 DROID 上 7.60 mm、RoboLab 上 16.07 mm,换到 UR5 本体微调十条演示后为 8.85 mm;RoboTwin 48 个任务干净环境平均成功率 69.19%,环境随机化下只有 10.94%;真机两个任务平均 78.33%,对照 DP3 的 63.33%、ACT 的 31.67%,且推理阶段不需要深度测量;跨本体数据上,ARX-X5 只用增强数据时平均成功率 30.5%,源数据与增强数据联合训练后为 72.0%。
对做本体和数据的工程师,最实用的变化是动作监督的来源:不必为新本体重新录制带状态标注的演示,一段 RGB 视频经 TCP 跟踪与逆运动学重定向就能变成该本体的训练数据。TCP 位姿在这里同时充当跟踪、策略和数据增强的公共接口,真机推理只需 RGB 相机、不依赖深度传感器。
数字均出自作者自测。环境随机化下 RoboTwin 平均成功率只有 10.94%,生成器的场景泛化尚未解决;跟踪预训练数据只覆盖 Franka 机械臂和 Robotiq 夹爪,换到其他本体仍需少量演示微调;真机只有两个任务,对照基线是 DP3 与 ACT。
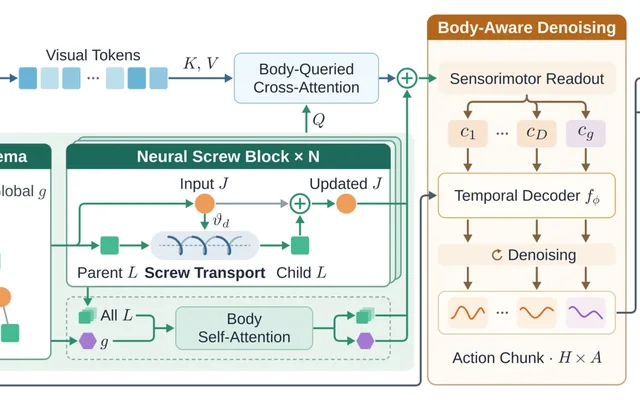 2026-11-17 · arXiv · 作者论文Body Schema Policy(BSP):把“身体图式”写进视觉—动作接口的小型全身策略
这篇论文处理的是一个很具体的工程问题:人形或轮式机器人做“边走边操作”的任务(论文里的 whole-body loco-manipulation,移动与精细操作必须同时进行)时,策略通常只能靠把模型做到几十亿参数、再逐个任务微调才拿到能力。作者 Body Schema Policy(BSP)想试另一条路:把人体运动控制里的“身体图式”(body schema,大脑对自身身体结构、姿态与运动的内部表征)做成策略内部显式的结构,而不是指望网络从示范数据里自己猜出来。
机制上做了三件事:把关节和连杆做成 token(向量化的身体部位标记)放在机器人的运动学树(刻画父子连杆关系的树)上,用学习到的螺旋运动(screw motion,把绕轴旋转与沿轴平移合成一个变换)在连杆之间搬运特征;每个身体部位用自己的 token 到预训练视觉编码器的图像分块特征上检索证据,检索到的证据只给自己那几维动作去噪。这样“哪个关节在动”与“画面哪块区域跟这个关节有关”在网络里是显式分开的。
作者自报的结果(arXiv 预印本,未见独立复现):在九个仿真 Unitree G1 全身任务上,表中部署参数量 35.0M 的 BSP 总分 221,与 2.63B 参数的 Ψ0 的 220 基本持平,参数少约 75 倍,单个动作块 13.9 ms;真实 G1 的两个任务各 10 次试验合计成功 16 次(Ψ0 为 13 次,Diffusion Policy 为 3 次);Fetch 移动机械臂三个子任务成功率 34.4%/20.6%/16.5%,高于同规模的两个对比方法,与 3.62B 参数的 π0.5 持平或更好。
速度来自收敛快:作者报告在每个任务 256 个训练帧上,去噪五步后下一个动作的中位误差已低于 2°(同尺寸 Diffusion Policy 为 7–12°),因此十步 DDPM 就够用;部署侧的做法是缓存与观测相关的视觉 key/value,并把每轮去噪作为捕获的 CUDA graph 重放,16 步动作块在 RTX 6000 Ada 上 13.9 ms。消融给出的读法是:潜在身体图式、身体查询视觉、DINOv2 编码器三项全开时三个任务总分 75,三项全部替换后掉到 20;把 DINOv2 换成从头训练的 ResNet-18 会让总分大约减半,说明结构不能替代一个好的预训练视觉特征。作者还观察到不同部位读画面的区域不同:在 LPBT 上手臂、手和腰关节把 31–46% 的敏感度放在只占画面 10–15% 的箱子上,底盘指令则读整个场景。
对做本体和控制软件的工程师,这篇论文给出的东西更像一份结构说明加一组部署数字。
第一,策略接口的形态。论文把机器人建模为以根为起点的运动学树:直接控制的关节构成连通子树并带父子关系,底盘速度这类交给底层控制器的命令作为“离树”坐标单独处理;论文也明确说本体和底层控制器决定策略的命令空间。所以迁到新本体时,主要工作量是把关节层级、指令语义与底层控制器接口对齐,而不是去收集大规模预训练数据。另外策略输出的是关节目标,工程上仍然需要一个能稳定跟踪关节目标的全身控制器——真机实验中三个策略都通过关节空间控制策略 HoloMotion v1.4 控制从腿到手指的全部 43 个关节。
第二,延迟与规模的量级。仿真评测里一个动作块(16 步)13.9 ms,真机所用主机上 17.4 ms;服务路径的做法是缓存与观测相关的视觉 key/value、并把每轮去噪作为捕获的 CUDA graph 重放,这套部署侧做法可以直接照抄。它还意味着策略按“执行完整个预测动作块再取下一次观测”的方式工作,接进现有控制回路时需要按这个节奏安排观测频率。
第三,可诊断性。每个部位读画面的区域不同,而且这种分工不是人工标注监督出来的;排查某个关节动作异常时可以直接看该部位的敏感度落在画面哪里,也能理解为什么手部指令需要局部细节、底盘指令需要全局视野。同时要清醒:这套结构不能顶替视觉表征——把 DINOv2 换成从头训练的 ResNet-18 会让总分大约减半,所以换本体或换视角时仍要准备好高质量预训练特征与相应适配工作。
限制按原文所述:受算力限制,SIMPLE 上的训练与评测没有扩展到更多随机种子;方法依赖关节指令具备运动学含义,作者报告在 SONIC、BFM-Zero 这类用潜在坐标(不对应具体身体部位)指挥的全身控制器上,潜在身体图式的效果弱于关节空间控制,因此不能直接搬到这类控制器上。此外 Fetch 三个子任务的绝对成功率本身不高(表中最好的 BSP 为 34.4%/20.6%/16.5%),真机实验每个任务也只有 10 次试验(表 3 题注所述),统计余量有限。
以下属于我的判断而非原文陈述:这是一篇 arXiv 预印本,上述成功率、延迟与消融数字均为作者自测,未见独立复现;表内比较只在作者设定的评测器与硬件配置下成立,不构成跨方法、跨协议的通用排名;与 Ψ0、π0.5 的对比是在各自预训练与评测条件不同的前提下做的,不宜等同于“通用能力更强”。


对做本体软件和数据管线的工程师,这条链路值得看的地方在两端。采集端从"受训操作员+真机+动捕"换成"人戴眼镜走一遍",数据采集的门槛结构完全不同;判定端把"接触到底成不成立"交给物理仿真——够不着、夹不住的轨迹先在仿真里被淘汰,再上真机微调,能减少无效采集和真机试错。图像、本体感知与动作同源于一条仿真轨迹,训练数据不需另外做时序对齐。
动作侧并未另起炉灶:训练标签就是闭环的全身动作 token 加手部关节指令,也就是在仿真里真正移动了物体、同时保持平衡的动作序列;推理端沿用既有链路,GR00T N1.7(3B)输出 78 维动作块,由冻结的 SONIC 解码器在 G1 上执行,本体控制栈需要改的只是数据来源。
现实约束也摆在眼前:数据可用性取决于物体好不好抓,薄壁帽子的录像在进入仿真前就被大量丢弃(154 段只剩 59 段);真机上抬瓶成功率 45%、戴帽 25%,失败同样集中在抓取阶段。
本次可用证据只有作者论文本身,以及作者自己用基线公开代码跑出的对比(EgoHumanoid、EgoHumanoid-V2;完整版 EgoHumanoid-V2 只在其完成的 8 段留出录像中的 6 段上评估),没有第三方独立复现的实验报告;真机每个任务只做 20 次试验,抬瓶成功率 45%、戴帽 25%,失败集中在抓取阶段;仿真里的质量、惯量、表面摩擦由编码智能体按先验从视频估计,重物和质量分布不均的物体仍有仿真到现实差距;渲染视图与真实相机在色调平衡以及眼镜从未观测到的区域仍有差异;物体只能建成刚体、参数化形状或铰接连杆,叠衣、切面包这类高度柔性或拓扑变化任务不适用。